这场培训的甲方,是 DeepSeek 介绍的。
南召衡辰中学的校董想弄清楚 WorkBuddy 到底怎么赋能教育,去 DeepSeek 上查。DeepSeek 的回答里,引用了我发在腾讯云开发者社区的一篇文章。校董顺着这条引用找到了我。
我平时总讲「上下文是资产」,这次算是 AI 亲手替我把这笔资产变现了一回。
于是前几天,我去了河南南阳,给这所学校的老师们做了一场培训。
整整 6 个小时,不是讲座——每个人带着电脑,跟着我一步一步真跑。上午认知加英语备课,下午 Skill 沉淀、数学实验室、整班作文批改。全程四段录屏,5.6 个小时(有一段我忘了按录制)。
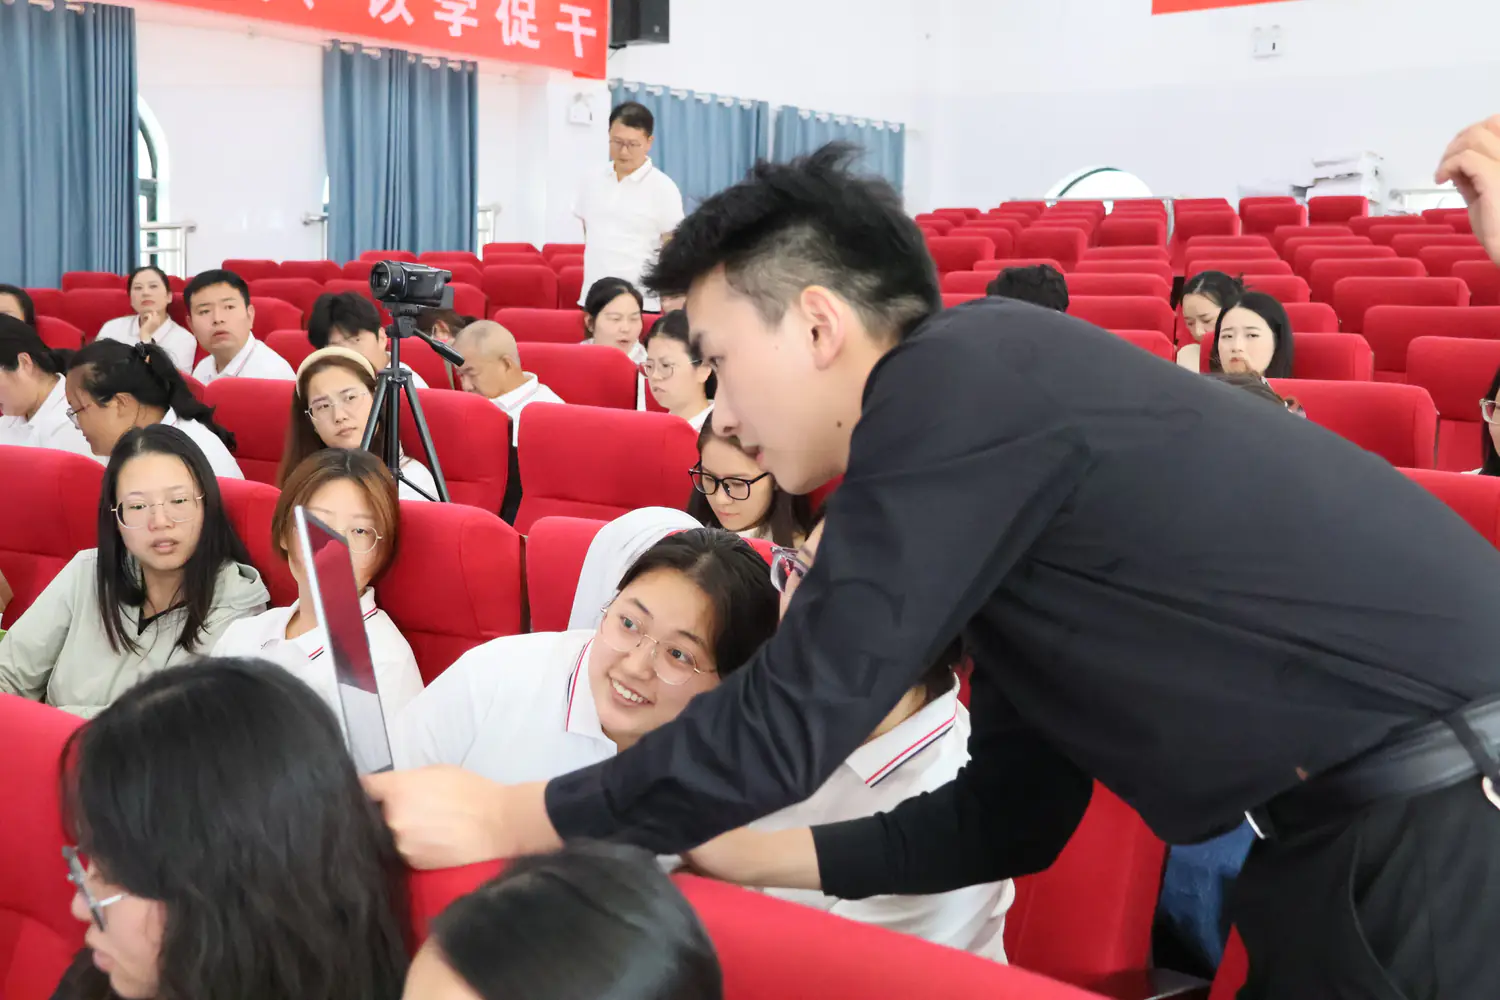
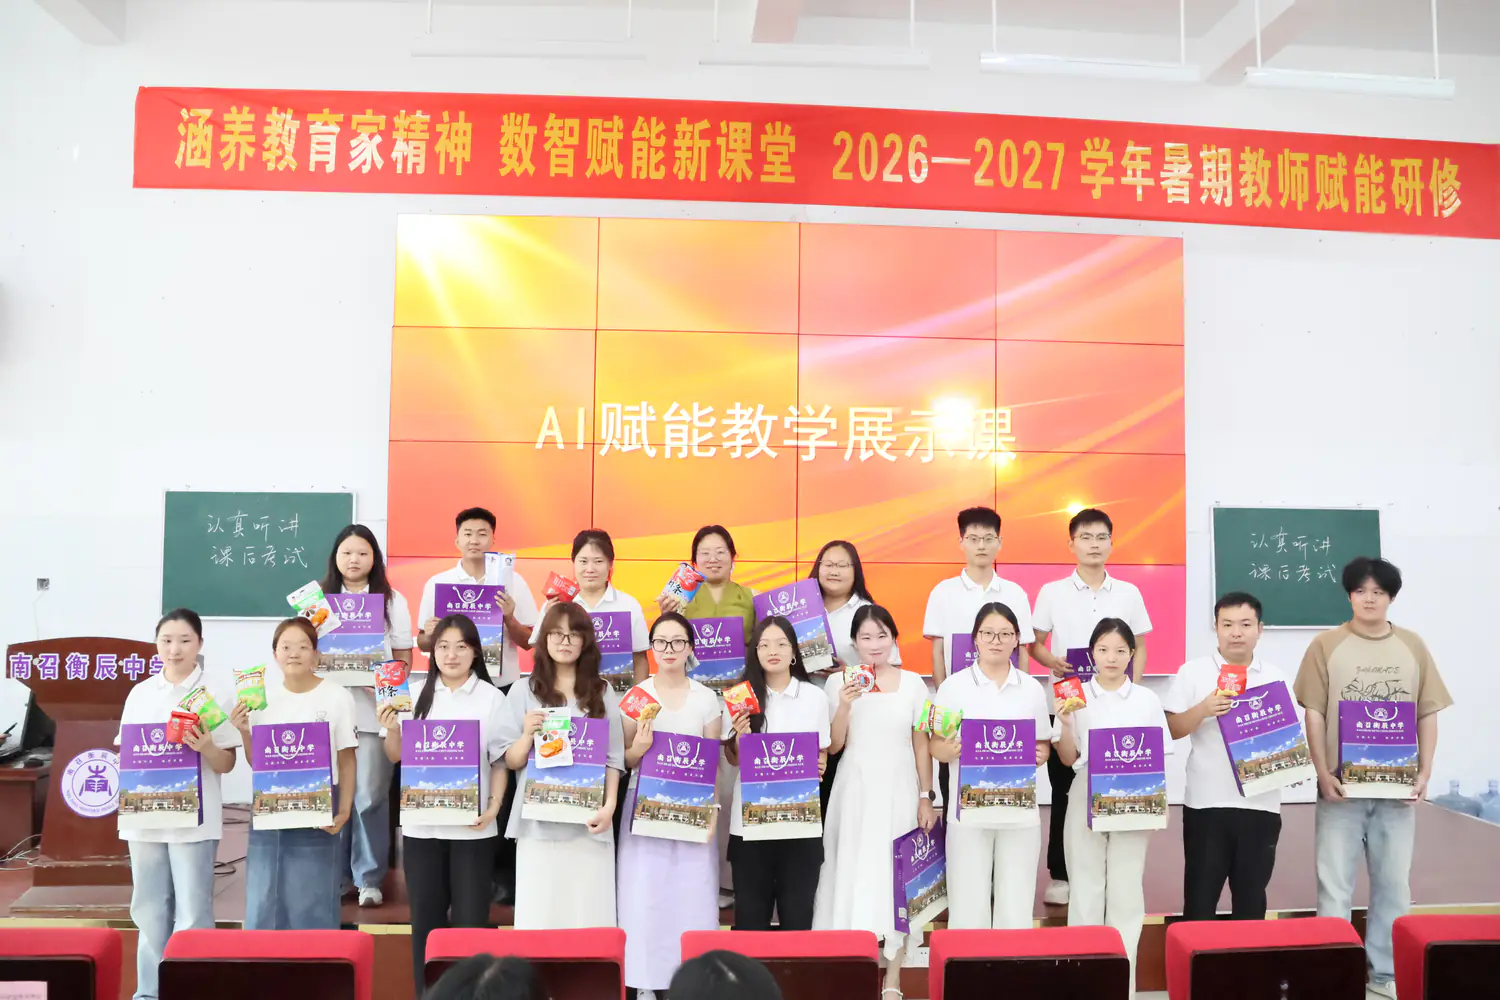
值得一夸的是,南召衡辰的执行力非常离谱的强,第二天就让老师实操,举行了AI赋能教学的比赛。所以,这样的学校肯定是能从AI时代跑出来的,只是时间问题~
这篇文章把那 6 个小时完整复原一遍。不是花絮,是那条真正跑通的路:英语老师从一堆错位的材料备出一整套课,数学老师拿到一个能投大屏的函数实验室,30 本手写作文并行批改完还出了全班的诊断报告。所有关键提示词都在文中,照抄就能用。
读完了你会发现,老师们缺的从来不是工具,是一套完整的派活方法。
一、67 份问卷:都在用,都没用起来
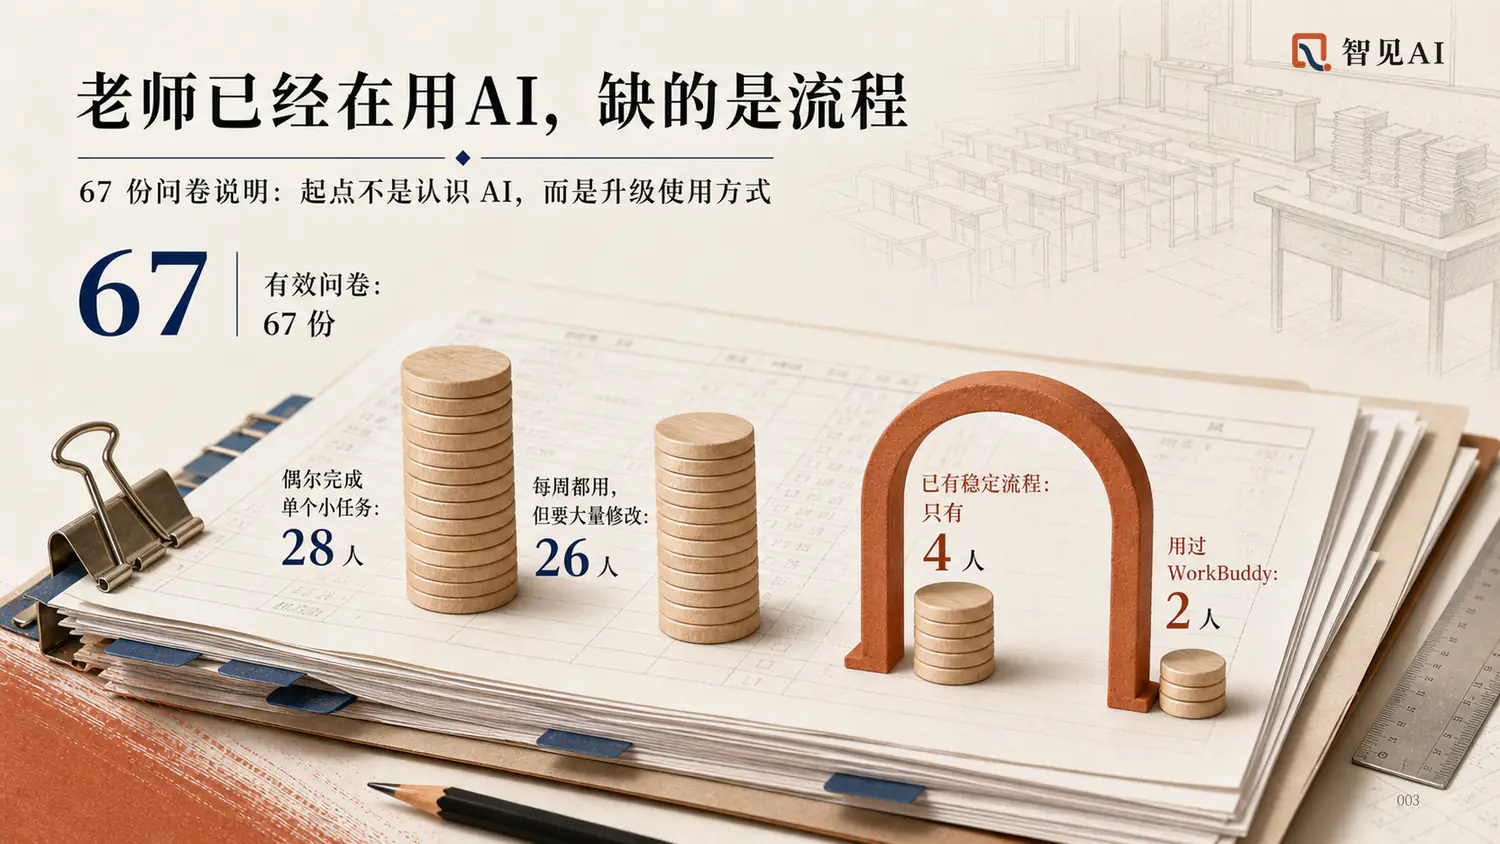
培训前我发过一份问卷,收回来 67 份。
数据很有意思:28 位老师偶尔用 AI,26 位每周都用。加起来八成老师已经在用 AI 备课了,基础比想象中好得多。
但往下看就露馅了。有稳定使用流程的,只有 4 个人。用过 WorkBuddy 这类 Agent 工具的,只有 2 个人。
八成人在「用」,几乎没人「用出成果」。中间隔着的那条沟,就是我这场培训要填的。
问卷里还问了担忧,排前三位的是:怕 AI 产出的东西不符合课标和学情;怕千篇一律,没有自己学校的样子;怕事实和答案出错。
这三个担忧其实指向同一个东西——上下文。AI 不了解你的课标、你的学生、你的学校,产出当然悬浮;判断的权力没攥在自己手里,产出当然失控。这一条线,贯穿了那 6 个小时。
先交代老师们过去用 AI 的方式:打开豆包或 DeepSeek,问一句,答一句。要备课了,先自己翻本地文件夹挑资料,上传附件,贴一段很长的提示词,等它出一个大纲,再复制粘贴回 Word,自己排版。
整个过程里,AI 是被告知的,人是搬运工。这种用法,天花板很低。
二、把 AI 养在你的文件夹里
所以上午前半段,我先把三个概念讲透。这三个概念是后面所有操作的地基。
第一个概念:Agent。
DeepSeek、豆包这类产品,行业里的定义是 Chatbot,对话机器人。你问一句,它答一句,它的职责是回答。
Agent 不一样。这个词翻译过来叫代理,就像注册公司找代办:你给一个具体任务——帮我把公司办下来——过程中的所有问题,他替你解决。
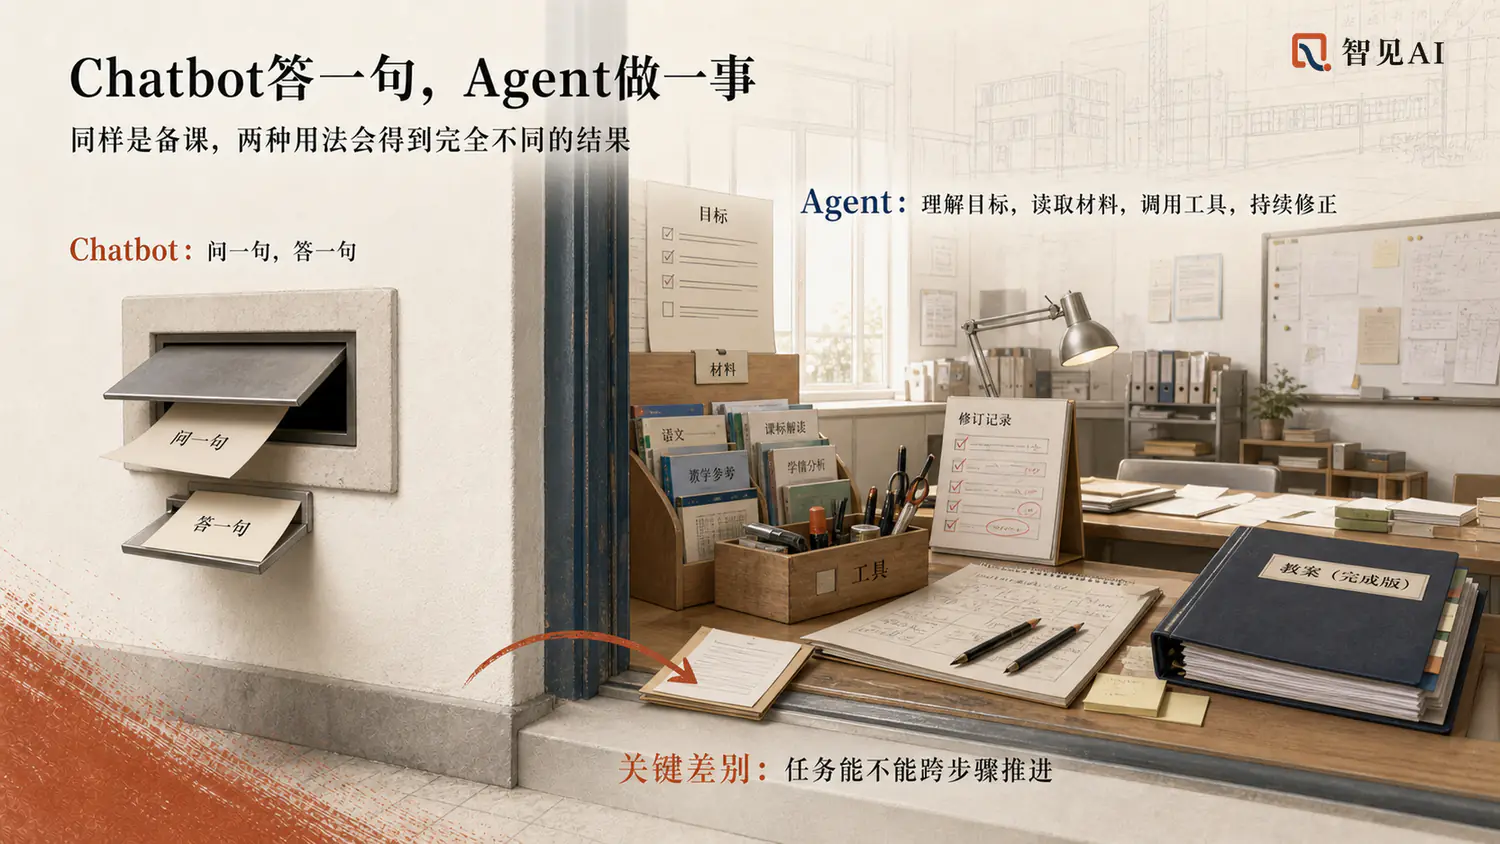
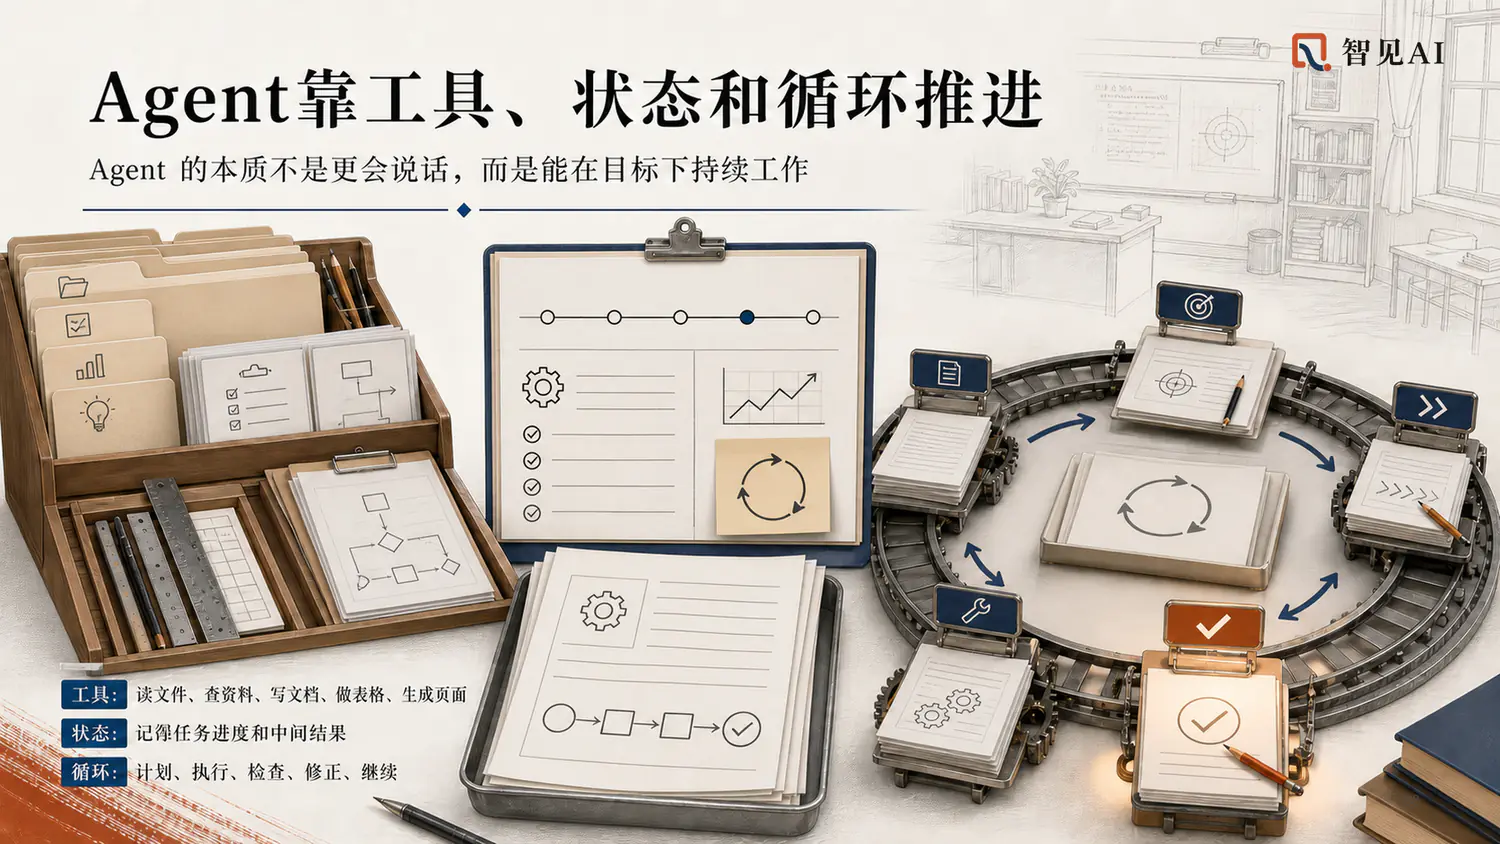
Agent 和 Chatbot 的差别,拆开是三个词:工具、状态、循环。
工具。你让 DeepSeek 帮你做个 PPT,它为什么动不了?没有写 pptx 文件的工具。模型是大脑,工具是手脚。大脑再聪明,没有手就干不了体力活。
状态。今天你跟它探讨了三小时第三课怎么备,明天新开一个对话,问「咱俩昨天聊到哪了」,它一片空白。Chatbot 保持不了状态,这就是为什么过去用 AI 感觉很累——每次都要重新自我介绍,重新喂资料。
循环。任何一个智能,完成任务的路径都是一个循环:先看目标,思考、拆解、定计划,调用工具去执行,拿到初步结果,跟最终目标比对差距,再调整计划进入下一轮。你给组里老师布置一个明天汇报的 PPT,那位老师干活的路数也是这个循环。Agent 干活之所以像人,就是因为它跑的是同一个循环。
第二个概念:上下文。这是全场培训我讲得最重的一点。
把世界上所有的知识放到一个平面上,用两条轴切开:横轴是「人知不知道」,纵轴是「AI 知不知道」,得到四个象限。
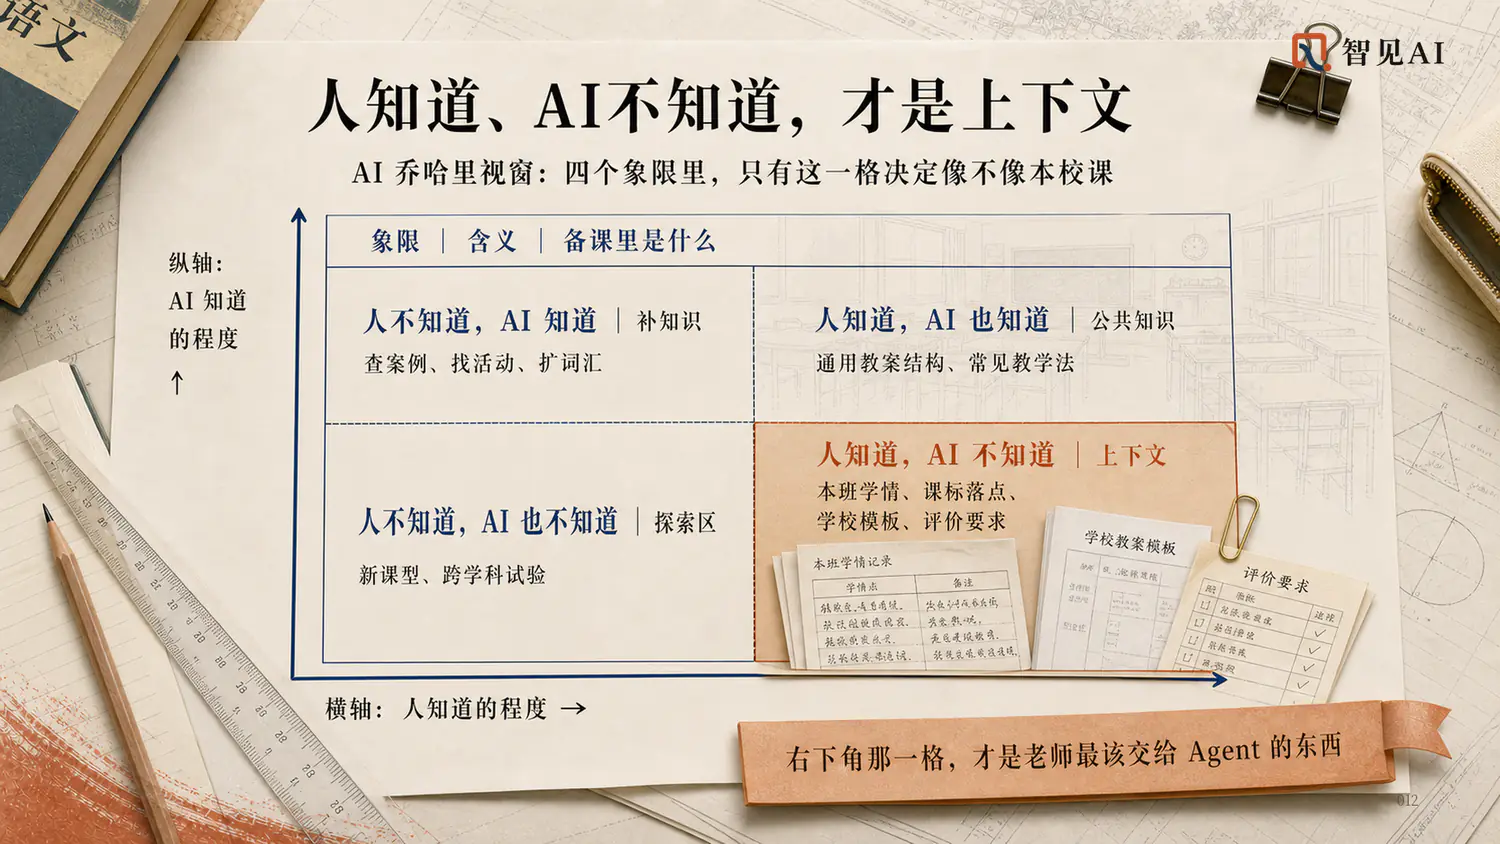
右上角,人知道、AI 也知道。比如通用教案的结构、常见的教学方法。这些东西不用你说,不影响结果。
左上角,人不知道、AI 知道。问概念、做调研,这是 Chatbot 的主场,也是过去大家用得最多的场景。
左下角,人不知道、AI 也不知道。那是顶尖科学家用 AI 探索前沿的领域,跟我们关系不大。
最重要的是右下角:人知道、AI 永远不知道。
有哪些?你是谁,你教哪科,你班上学生的基础怎么样,你学生常犯什么错,你们学校的导学案长什么样,你桌上那堆文件里都是什么。
这些是物理世界的信息。AI 就算联网,也查不到你班学生上次考试的分数。它们对你最重要,对 AI 却是彻底的盲区。
所以过去用 AI 感觉产出很表层,不是模型不行,是你最值钱的那部分上下文,一次都没给过它。
备课的上下文是什么?课标、教材、单元要求、班级学情、学生常见错误、学校模板、评价要求、过往作业记录。这些东西在哪儿?全在你电脑里。
那就别每次手动搬运了。把 AI 养在你的文件夹里。
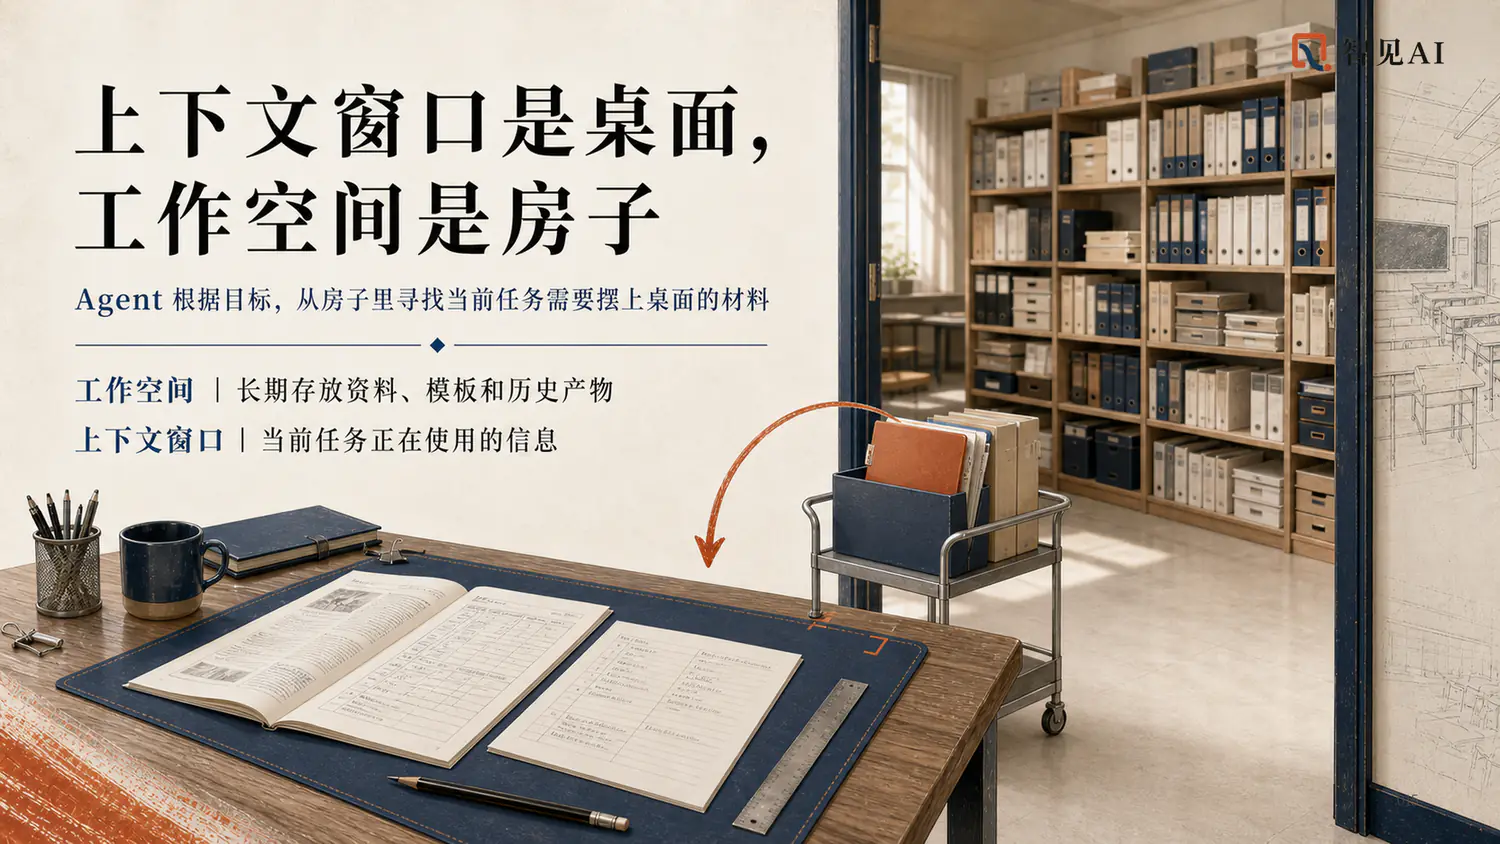
这就引出第三个概念:工作空间和上下文窗口。现场我用一间房子讲这三个概念,其中「书架要规整」那一层,还是一位老师自己答出来的。
工作空间是房子。在 WorkBuddy 里选一个本地文件夹作为工作空间,AI 就住进这间房子:它需要什么材料,自己去书架上找。房子同时也是一个围栏——它只能在这间房里增删编辑,动不了你电脑上的其他文件。网上常传「AI 把代码库删了」这种事故,工作空间就是防这个的。
上下文窗口是工作台面。AI 接到任务,先去书架上把相关材料搬到台面上,台面的大小决定了它一次任务能摊开多少信息。目前主流大模型的上下文窗口在 20 万到 100 万 token,100 万 token 大约是两本《红楼梦》的体量。文件夹比台面大没关系——只要书架足够规整,它每次取的材料足够准。
书架规整,就是文件夹结构化。文件夹命名清晰,AI 看一眼名字就知道里面是什么;乱堆一气,它就得把每个文件都翻开看一遍,白白烧掉台面。就算接手的是一个乱文件夹,也可以先让 AI 自己整理一遍。
选模型也就三句话:长任务、大文件夹,选上下文窗口大的;看模型后面的积分系数,日常任务 V4 Flash 这个档位能解决 95% 的场景;要处理手写照片、要看图做网页的,选多模态模型——它能像人眼一样看出照片里你打的勾和叉,而不只是把字提出来。
三、SGP:别再学提示词了
概念讲完,讲怎么开口。
GPT 刚出来那两年,市面上全是提示词课,九块九一节。我也买过不少。但模型能力越来越强,那些结构化的长提示词,作用越来越小——很多事你随口一句话,它也能完成得不错。
Agent 的运行是一个循环,循环里最要紧的三件事:初始状态、目标、过程。我把它总结成 SGP:State、Goal、Process。
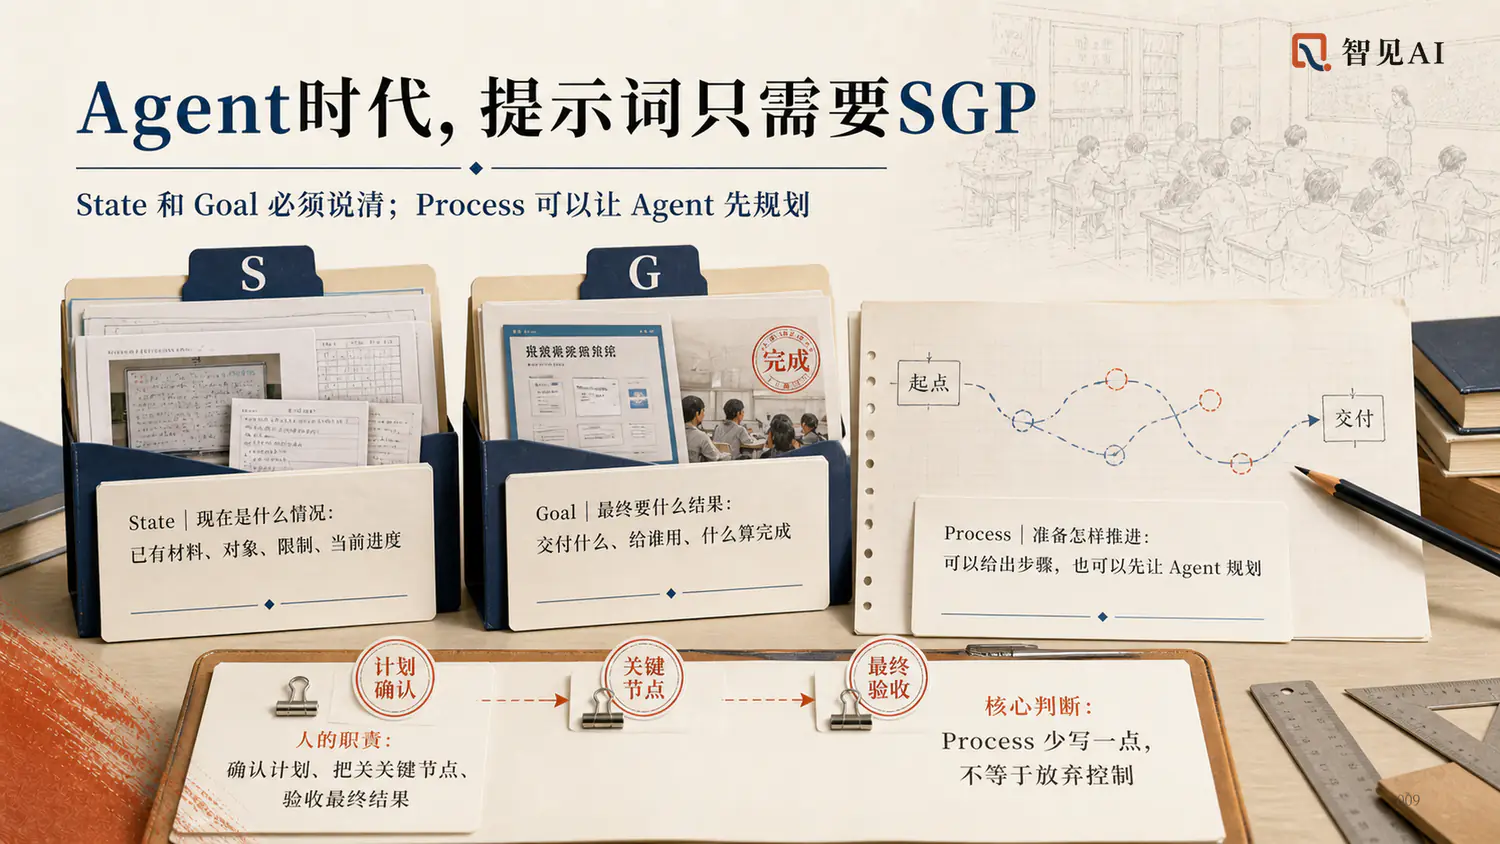
State 是现状:我是谁,我手上有什么材料,事情现在做到哪了。Goal 是目标:我要一个什么东西。Process 是过程:你希望它怎么一步步干。
这里有个反直觉的判断:Process 的比重应该越来越小。你觉得在这件事上你比 AI 强,就把步骤说细;你不如它的,就把过程交给它去规划,你只审计划。备课这件事,规划能力 AI 比多数老师强,你真正不可替代的是教学判断。
落到操作上,派一个活说清五件事就够了:我是谁(State),手上有什么材料,必须遵守什么规则,要什么(Goal),先对齐再动手(Process 的验收)。
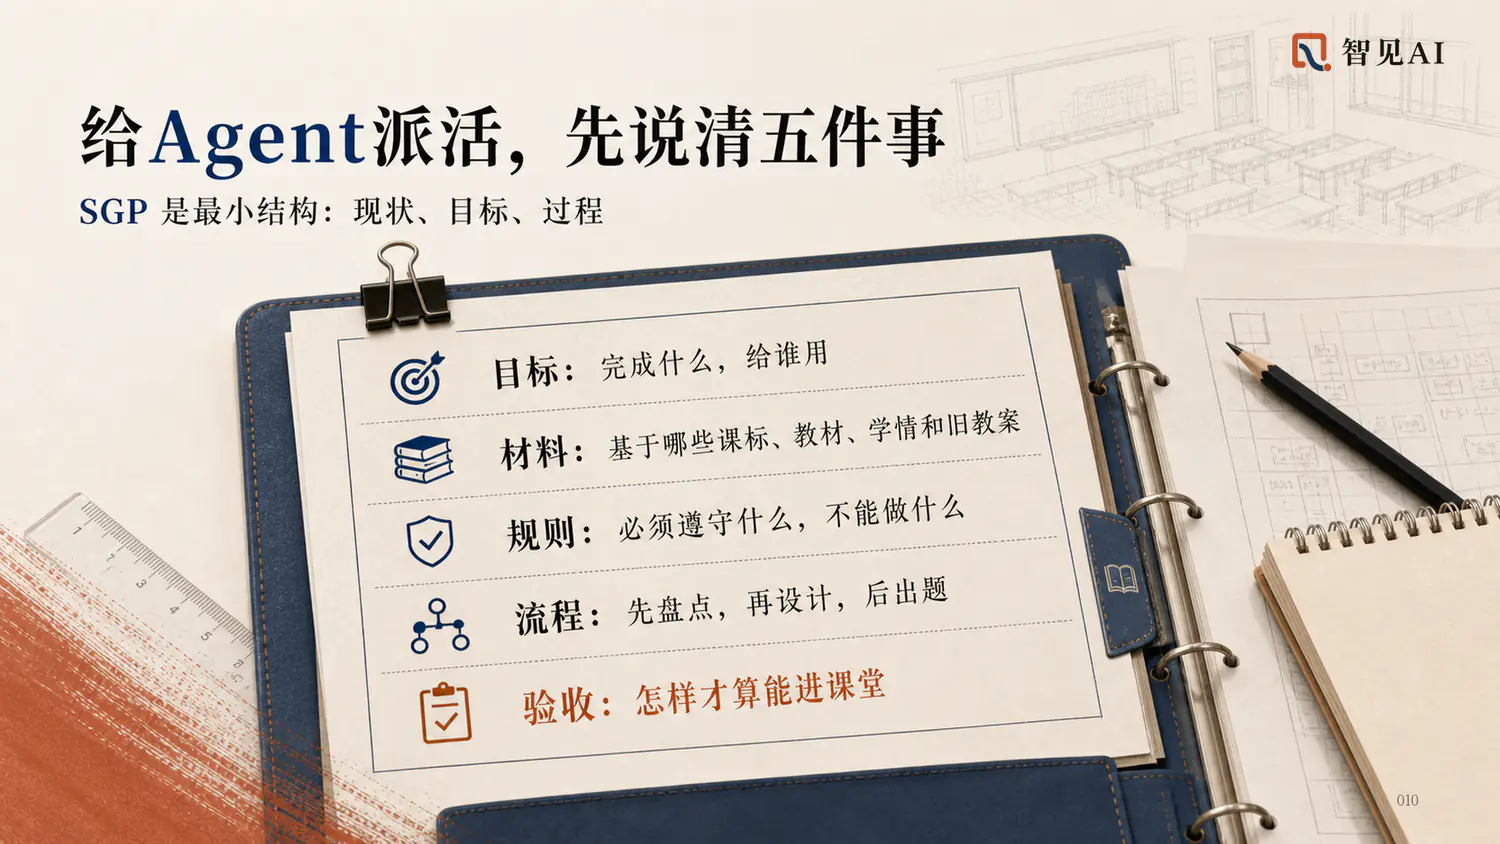
最后一件事值钱:对齐需求。
人是不善于表达自己需求的。你给下属布置任务,怕他没理解,会补一句「你还有什么想问的吗」。对 Agent 也一样,在提示词结尾加一句:
在正式开始之前,请通过提问的方式与我对齐需求。
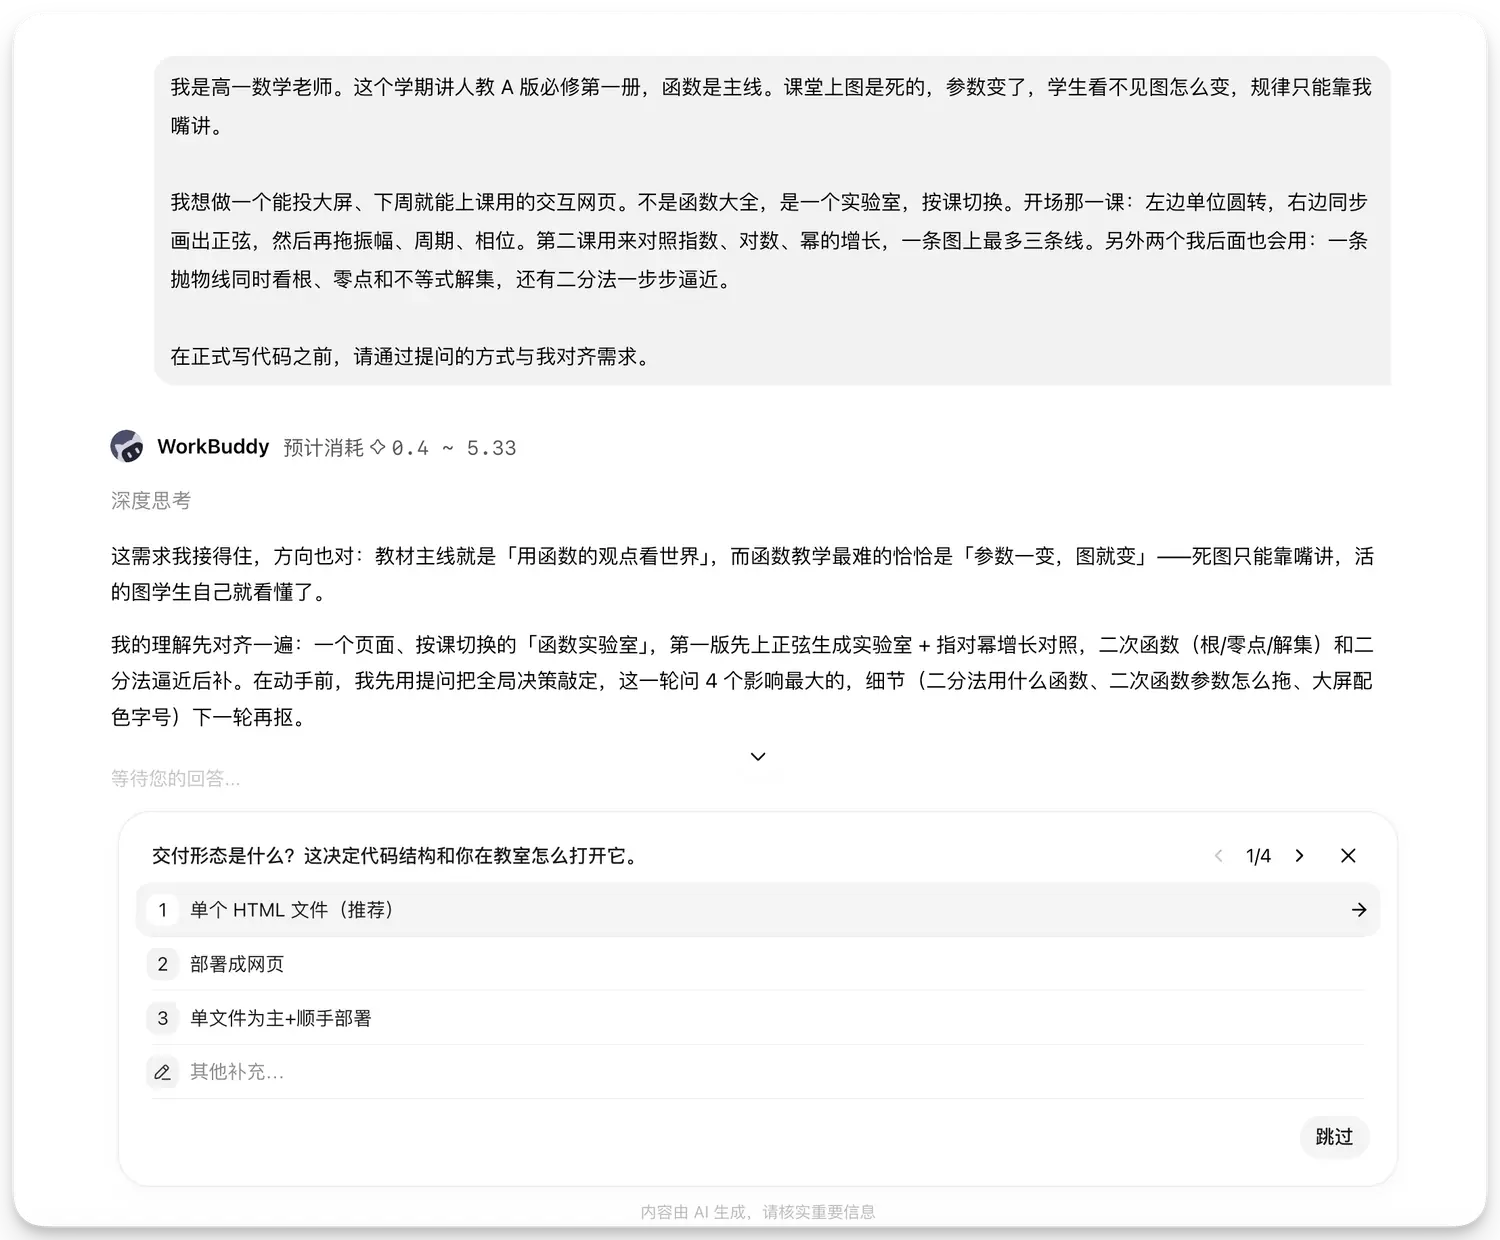
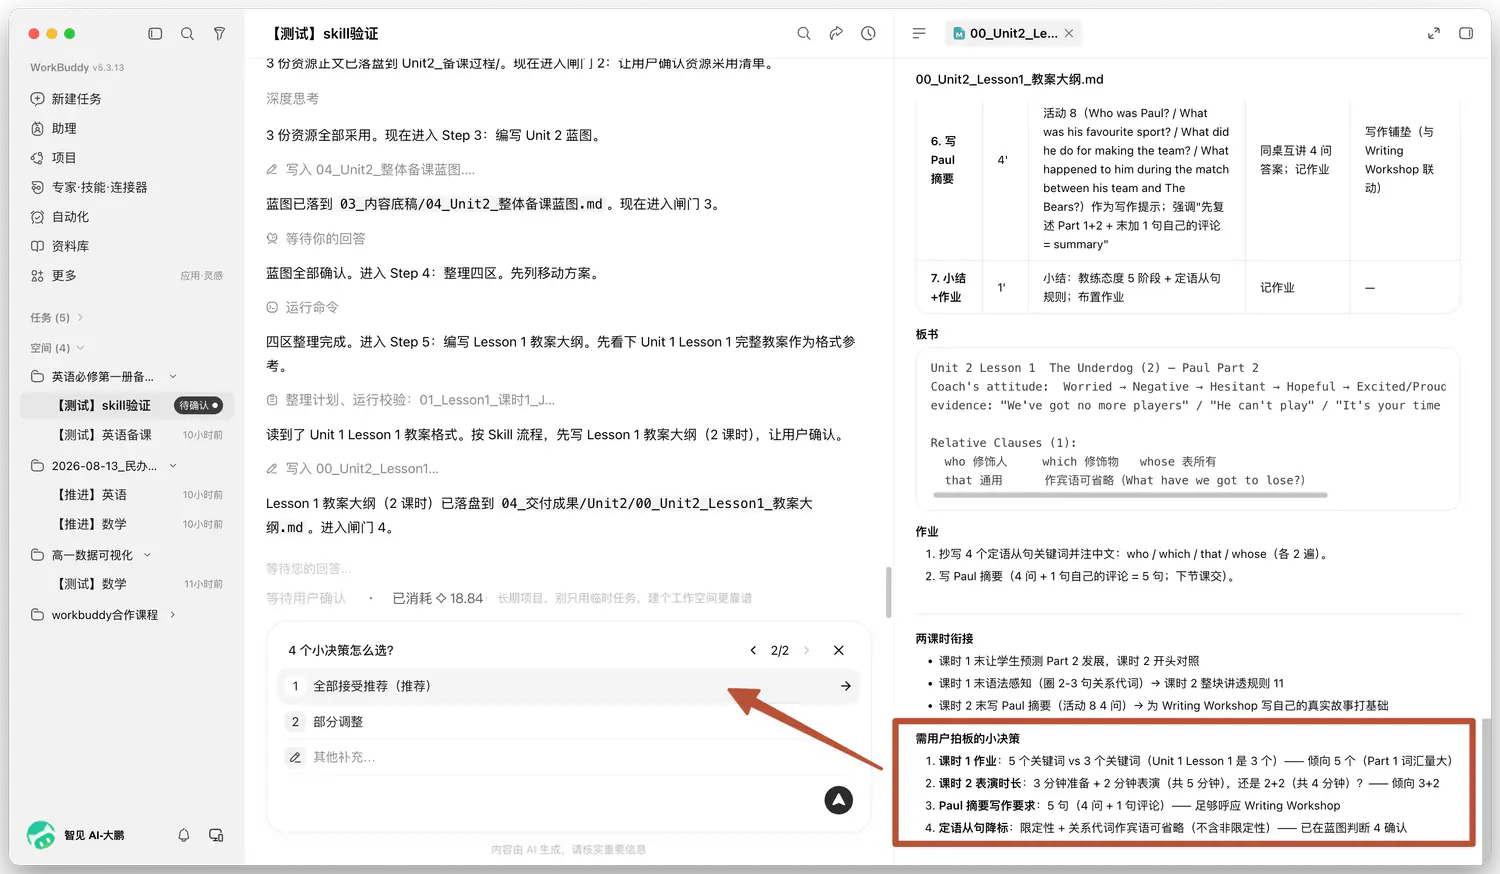
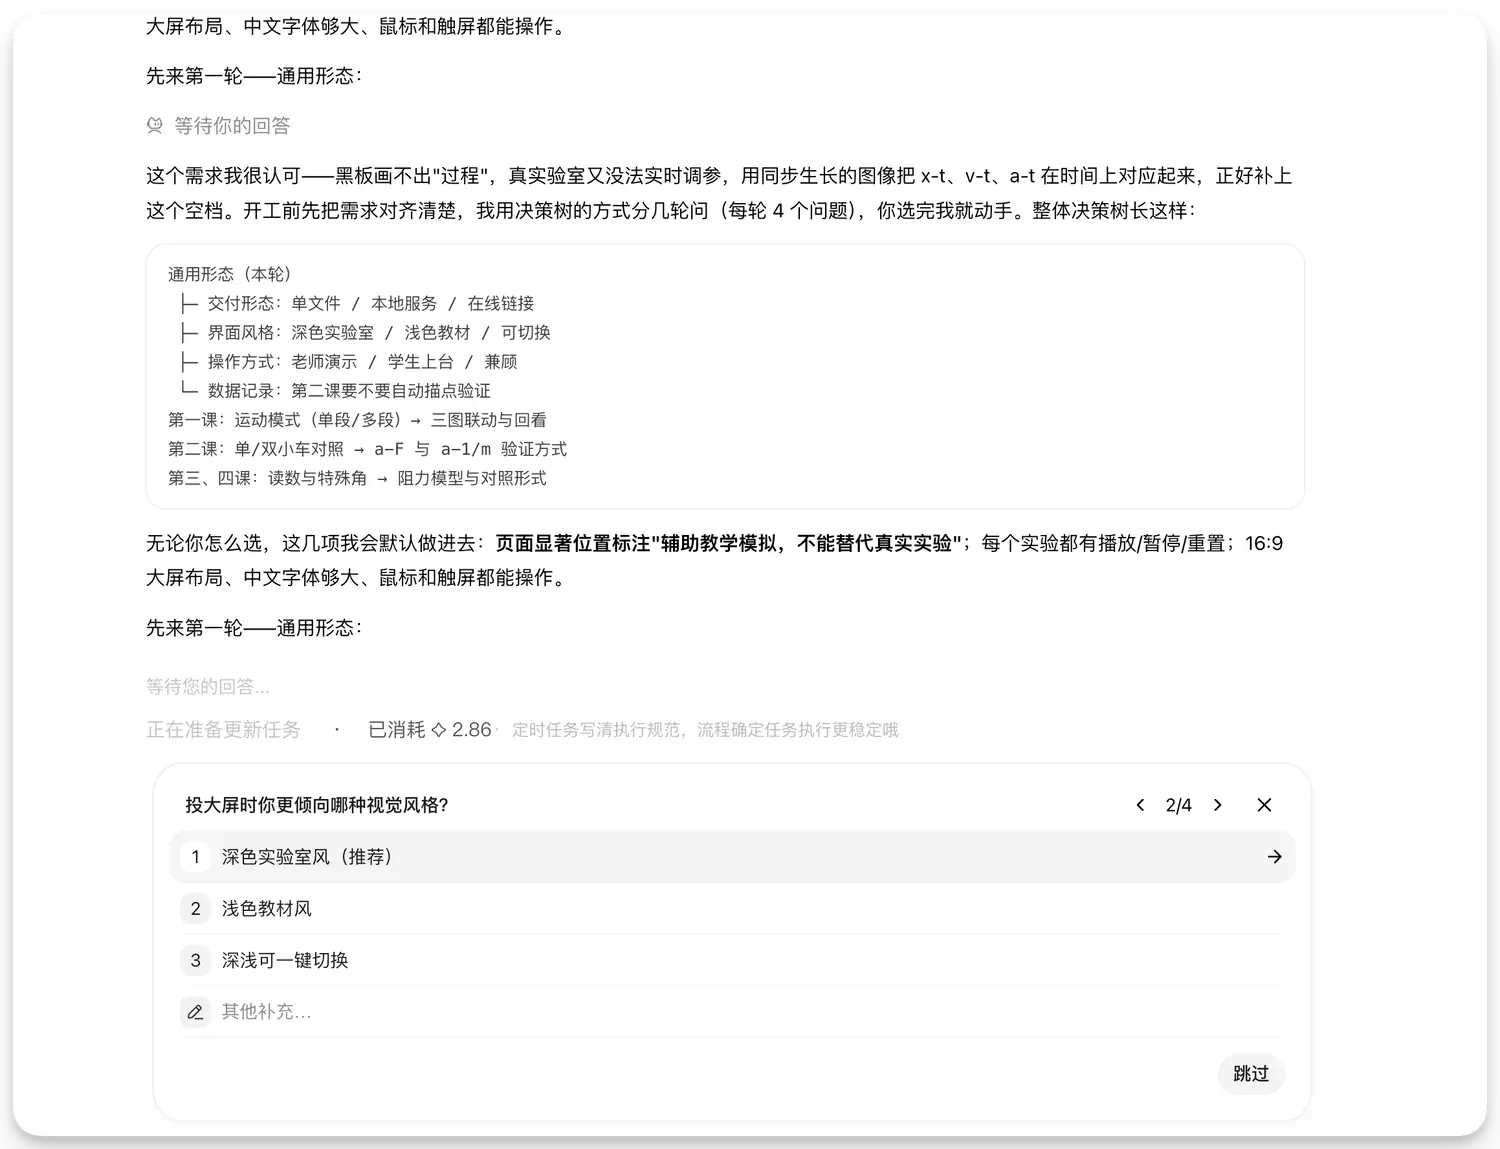
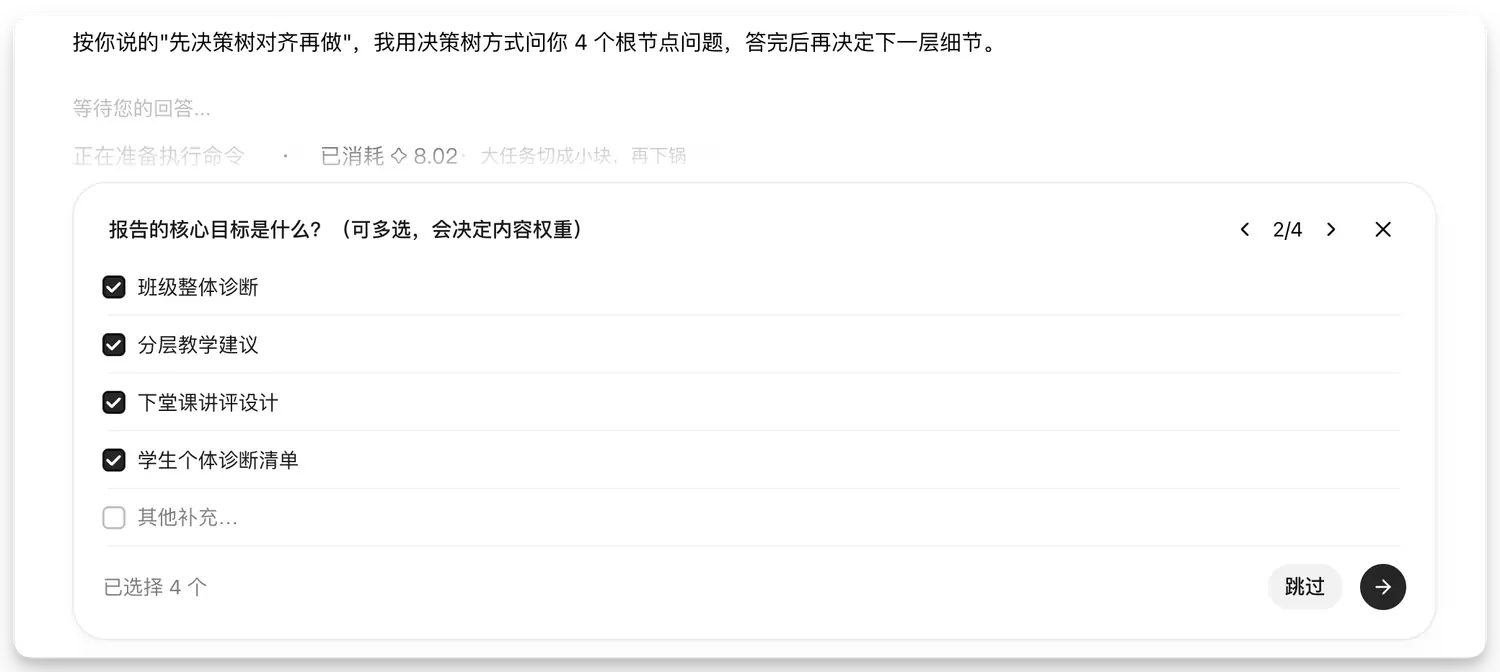
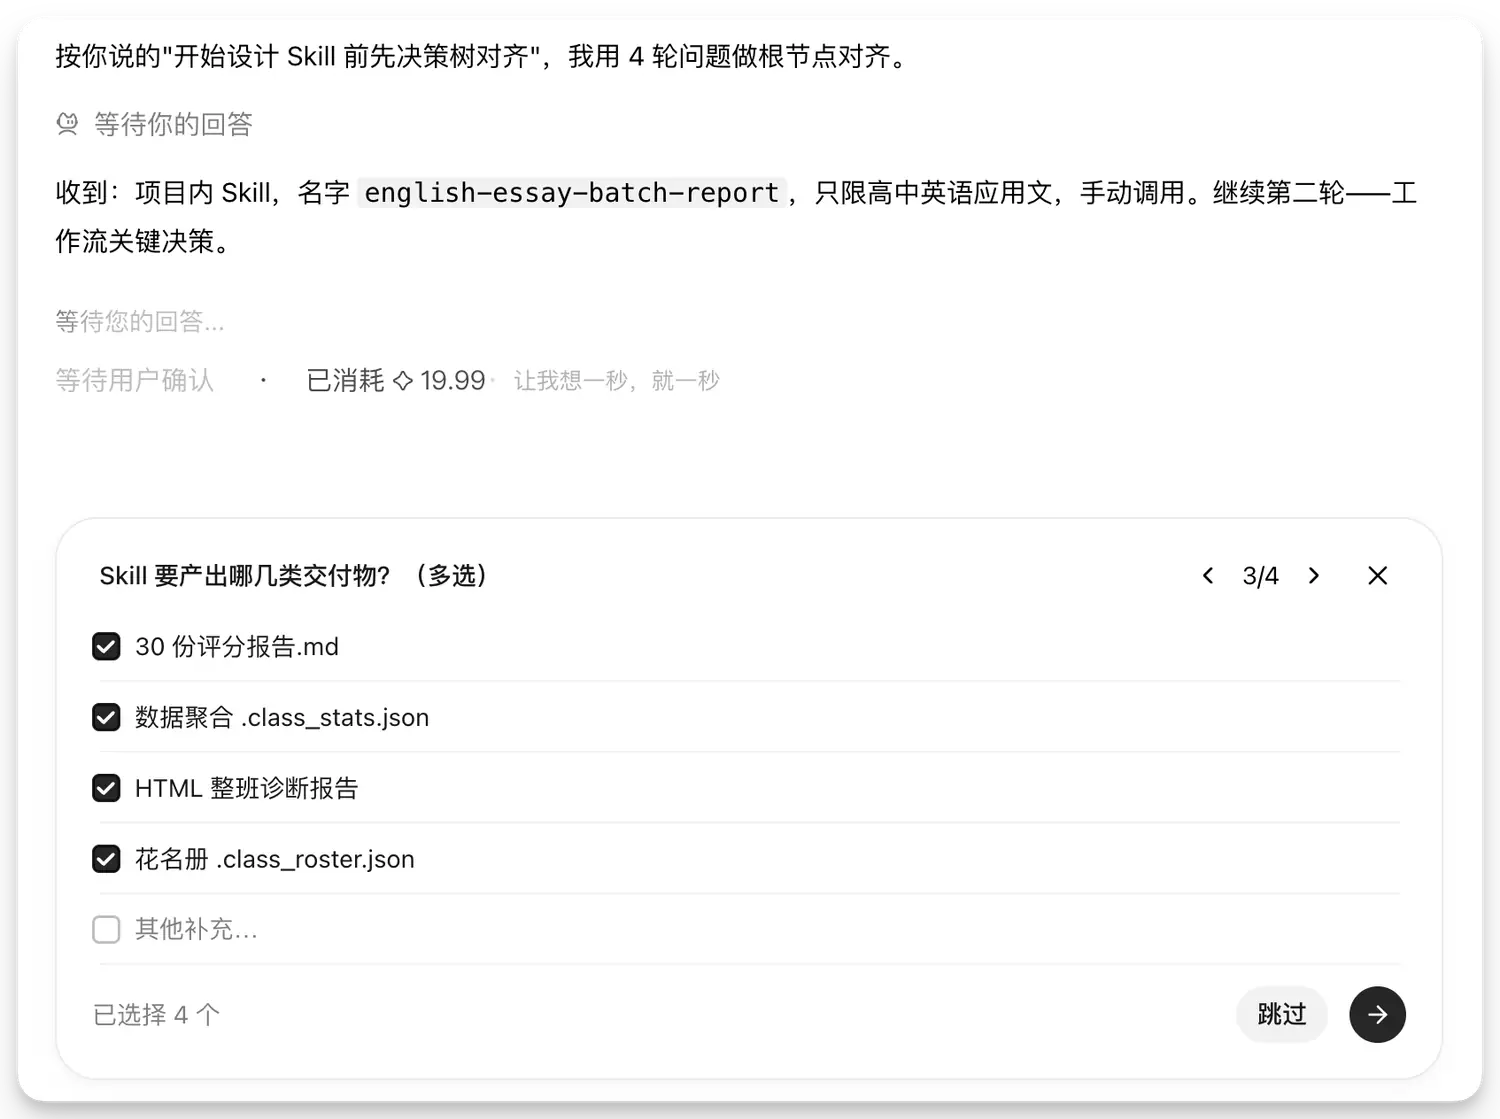
这句话会贯穿后面所有实操。WorkBuddy 把它实现成了选择题卡片:AI 先复述它理解的东西,然后弹出选择题,一轮最多 4 题,每题两到四个选项,还会标注推荐项和理由。你点完一轮,它汇总,再进下一轮。
推荐项带着教学判断。比如它问「正弦实验室里的角用什么单位」,推荐「弧度+角度双显示」——因为它知道必修一第五章用弧度,而学生的直觉停在角度。你可以不选推荐,点「其他补充」改口,拍板权永远在你。
记住这一句就够了:方向可以说清,细节让它来问。
四、英语老师的备课流水线
上午的主案例是英语:一个新入职的高一英语老师,北师大版必修第一册,前辈给了一堆参考资料,下周就要上课。
这条线一共 20 步,我挑关键的讲。
第一步,盘点,别急着写教案。
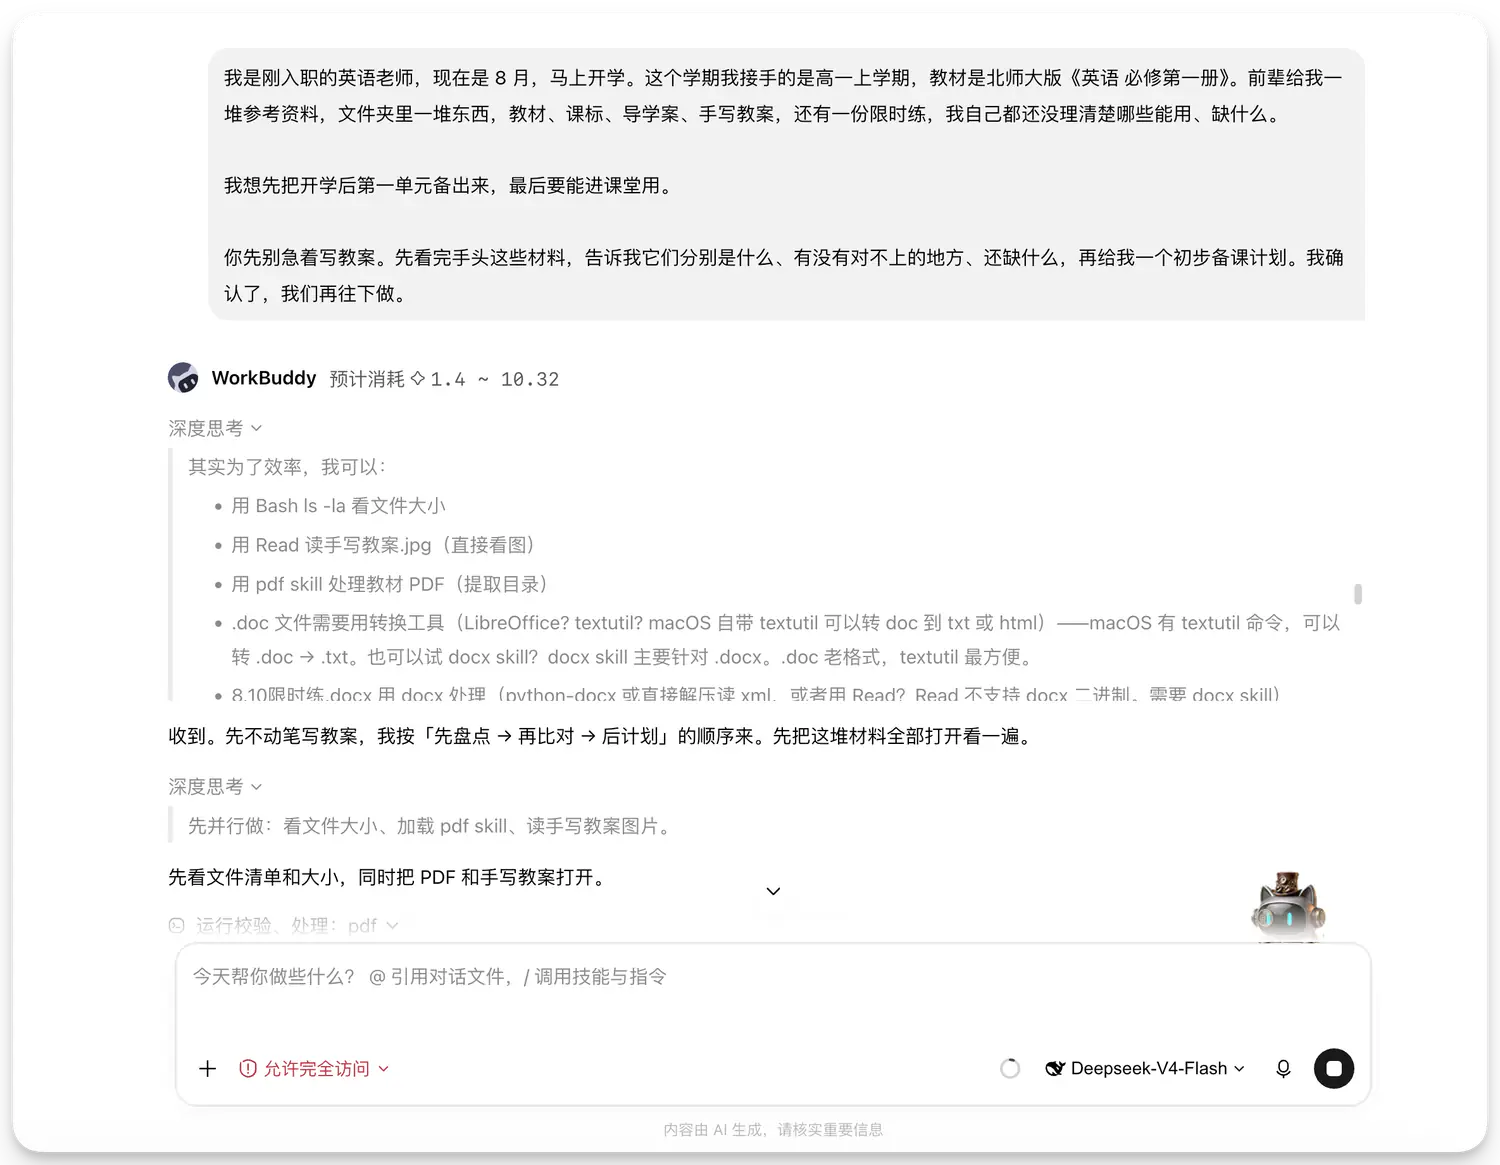
开口三段话:我是新入职的英语老师,马上开学;我想把第一单元备出来,最后要能进课堂用;你先别急着写教案,先看完手头这些材料,告诉我它们分别是什么、有没有对不上的地方、还缺什么,我确认了再往下做。
它的结论一句话:7 份材料里,只有 2 份能用——教材和课标。两份导学案的落款是高三,手写教案写的是 Unit 7,限时练是高考题型。年级错了,单元错了,题型也错了。开学第一周要的是新授课,不是高考综合卷。
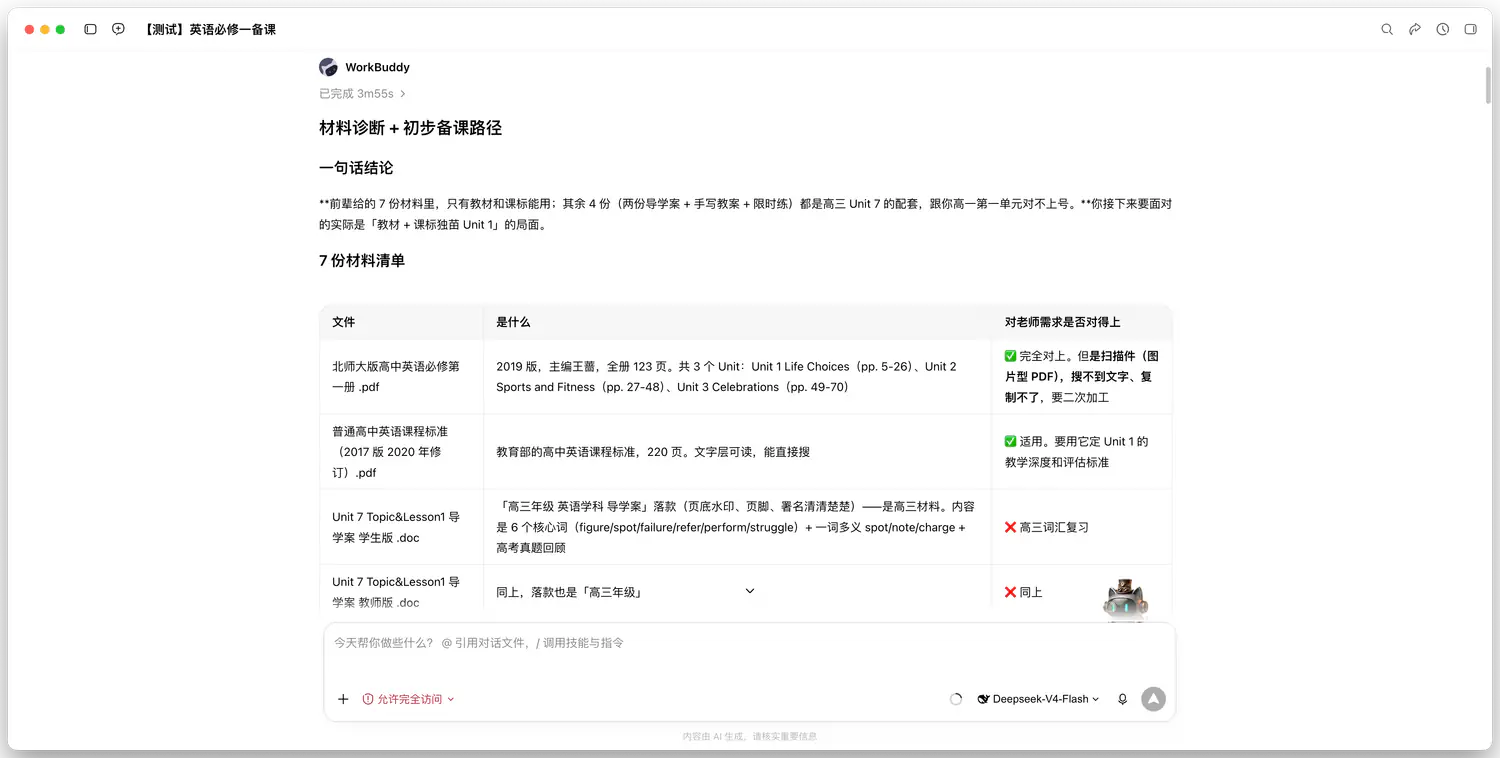
这一步很多人会跳过。直接说「帮我写个教案」,这些错位材料就全进了产出,你还不知道问题出在哪。AI 的第一份工作不是写教案,是当材料质检员。
顺带一个现场知识点:聊天框里的模型默认只能看文字。Word、扫描 PDF、手写照片,它得先找工具打开——大脑是模型,手脚是工具。Agent 和 Chatbot 的差距就在这双手上。
第二步,联网补料。
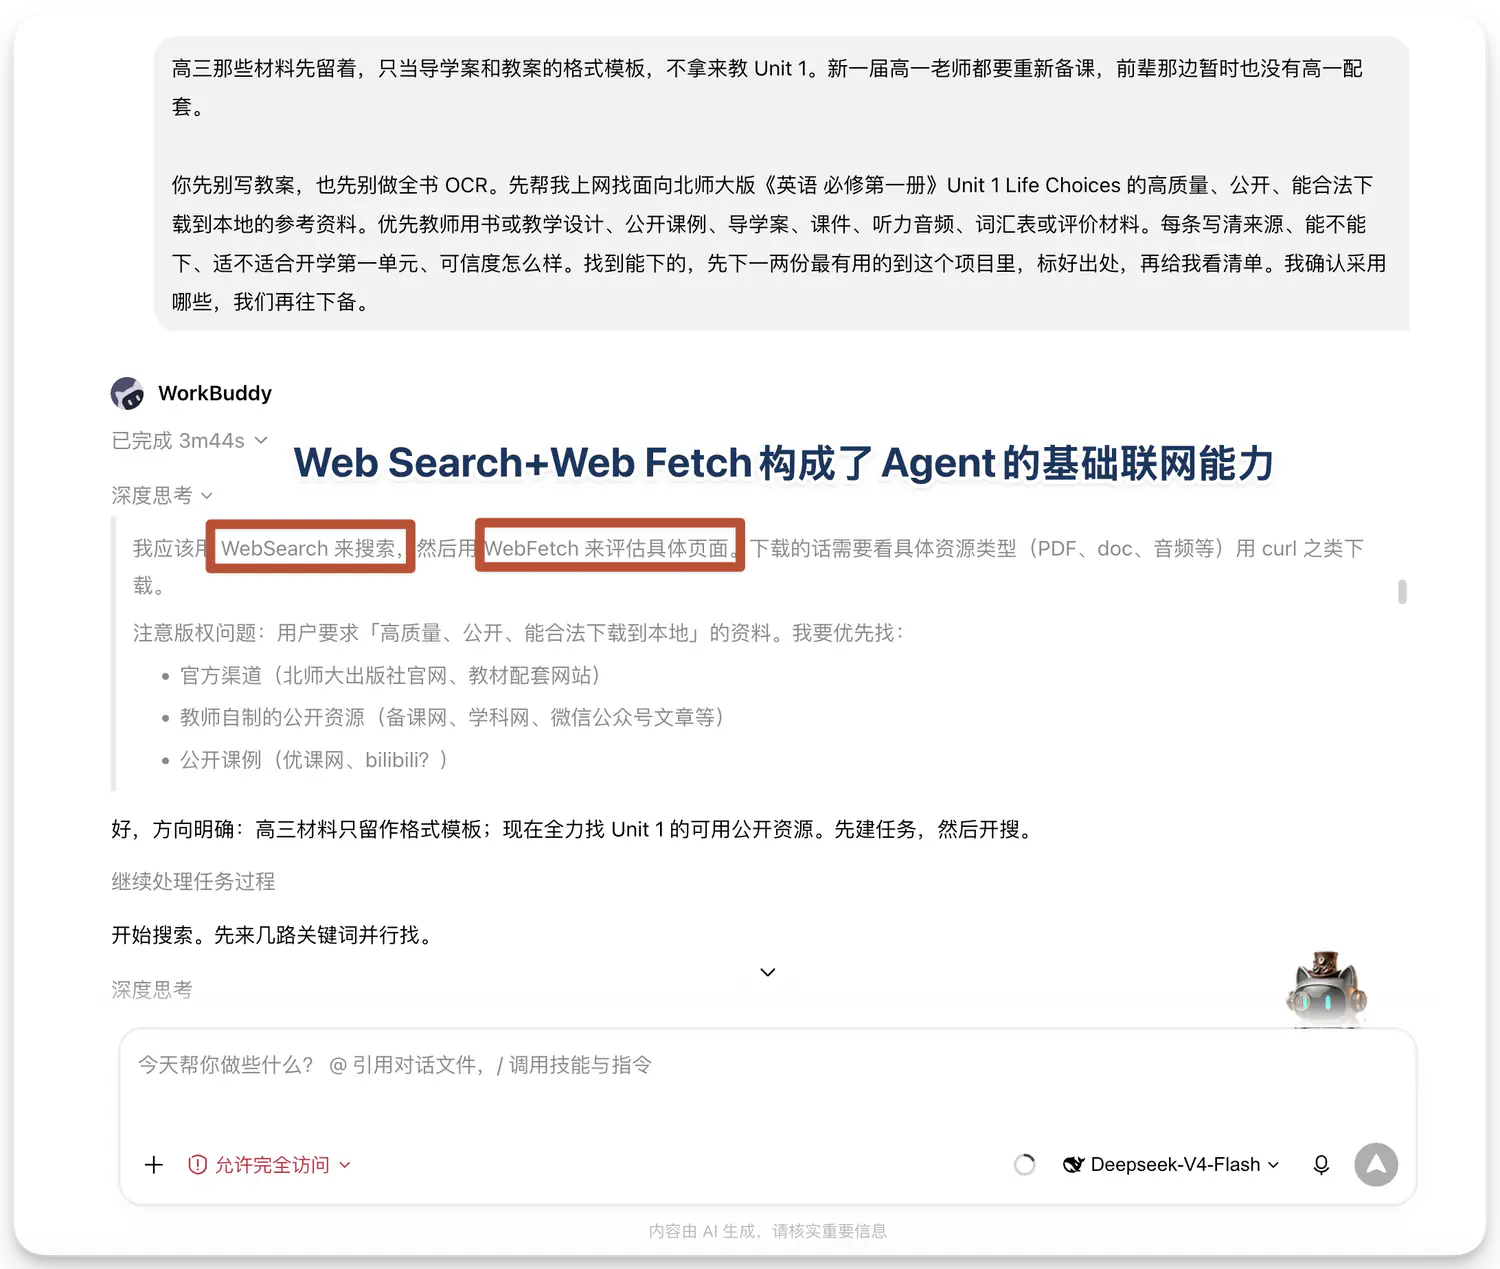
前辈那里没有高一的配套,缺口就让它自己上网补:先别写教案,也别做全书 OCR,帮我找北师大版必修一 Unit 1 的高质量、公开、能合法下载的资料,每条写清来源、能不能下、适不适合开学第一单元、可信度怎么样,先下一两份最有用的,列清单给我确认。
这里有两个工具,值得所有老师记住。Web Search 是搜索框,输入关键词,拿回一堆标题、摘要和链接;Web Fetch 是点开链接,进到页面里读具体内容。搜到不等于找到,点开不等于能下。
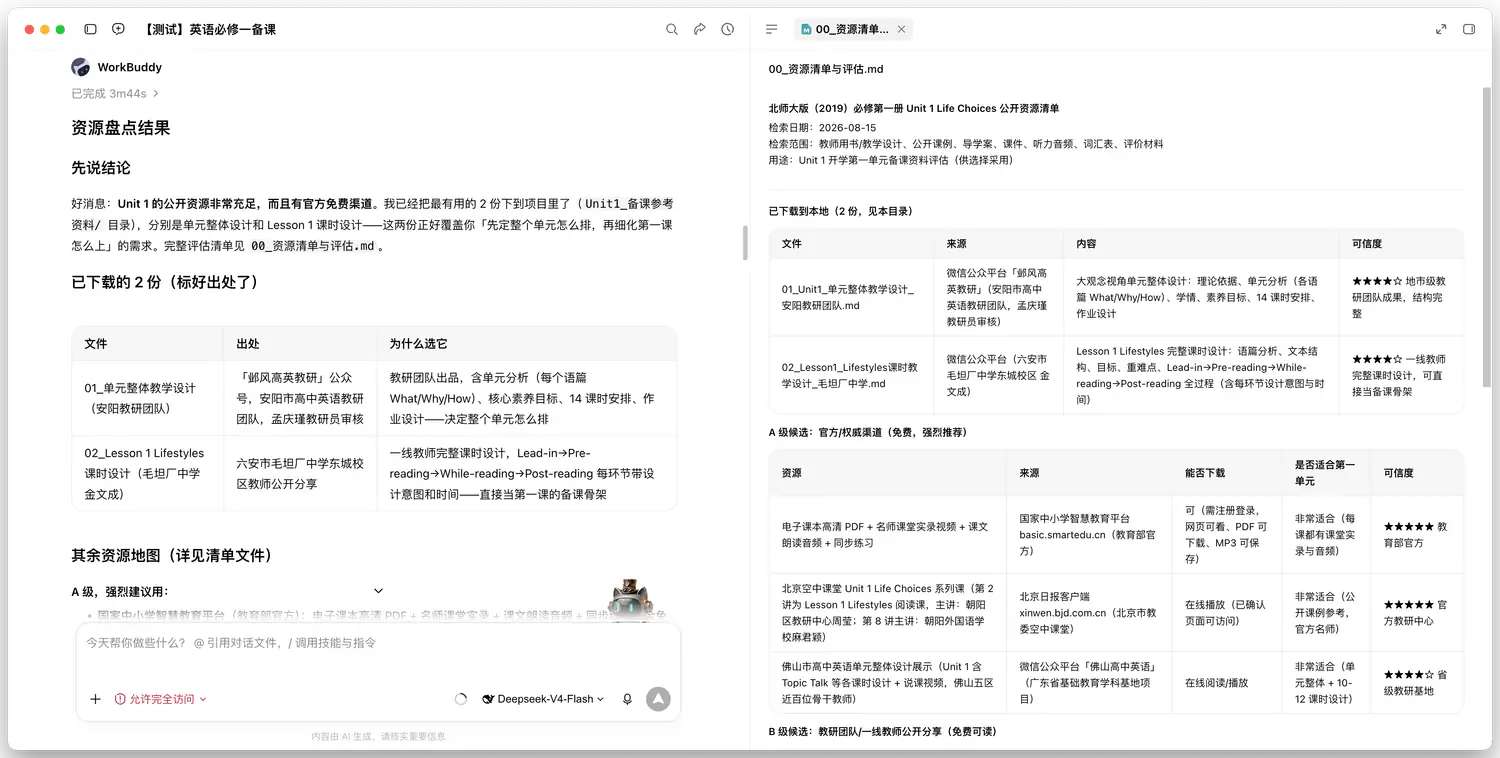
它最后下载了两份:安阳教研的单元整体教学设计,管整单元怎么排;毛坦厂中学的课时设计,管第一课怎么上。其余只画了一张地图,哪些是 A 级官方渠道,哪些要学币、套话多,标成 C 级。
第三步,蓝图。
材料齐了,让它出 Unit 1 的整体备课蓝图:这个单元解决什么、拆多少课时、每课时干什么、重难点和任务链怎么安排。资料有冲突,说明采用哪种、为什么;需要我拍板的关键教学判断,单独列出来。
它给了 12 课时的方案,另附 6 个必须人来定的判断:课时用 12 还是 14;不定式讲到什么深度;Lesson 1 拆 2 课时还是挤 1 课时;超纲练习当不当作业;课末那几句「我的理想生活方式」怎么安排。每个判断它都有推荐和理由,但停在那里等人点头。
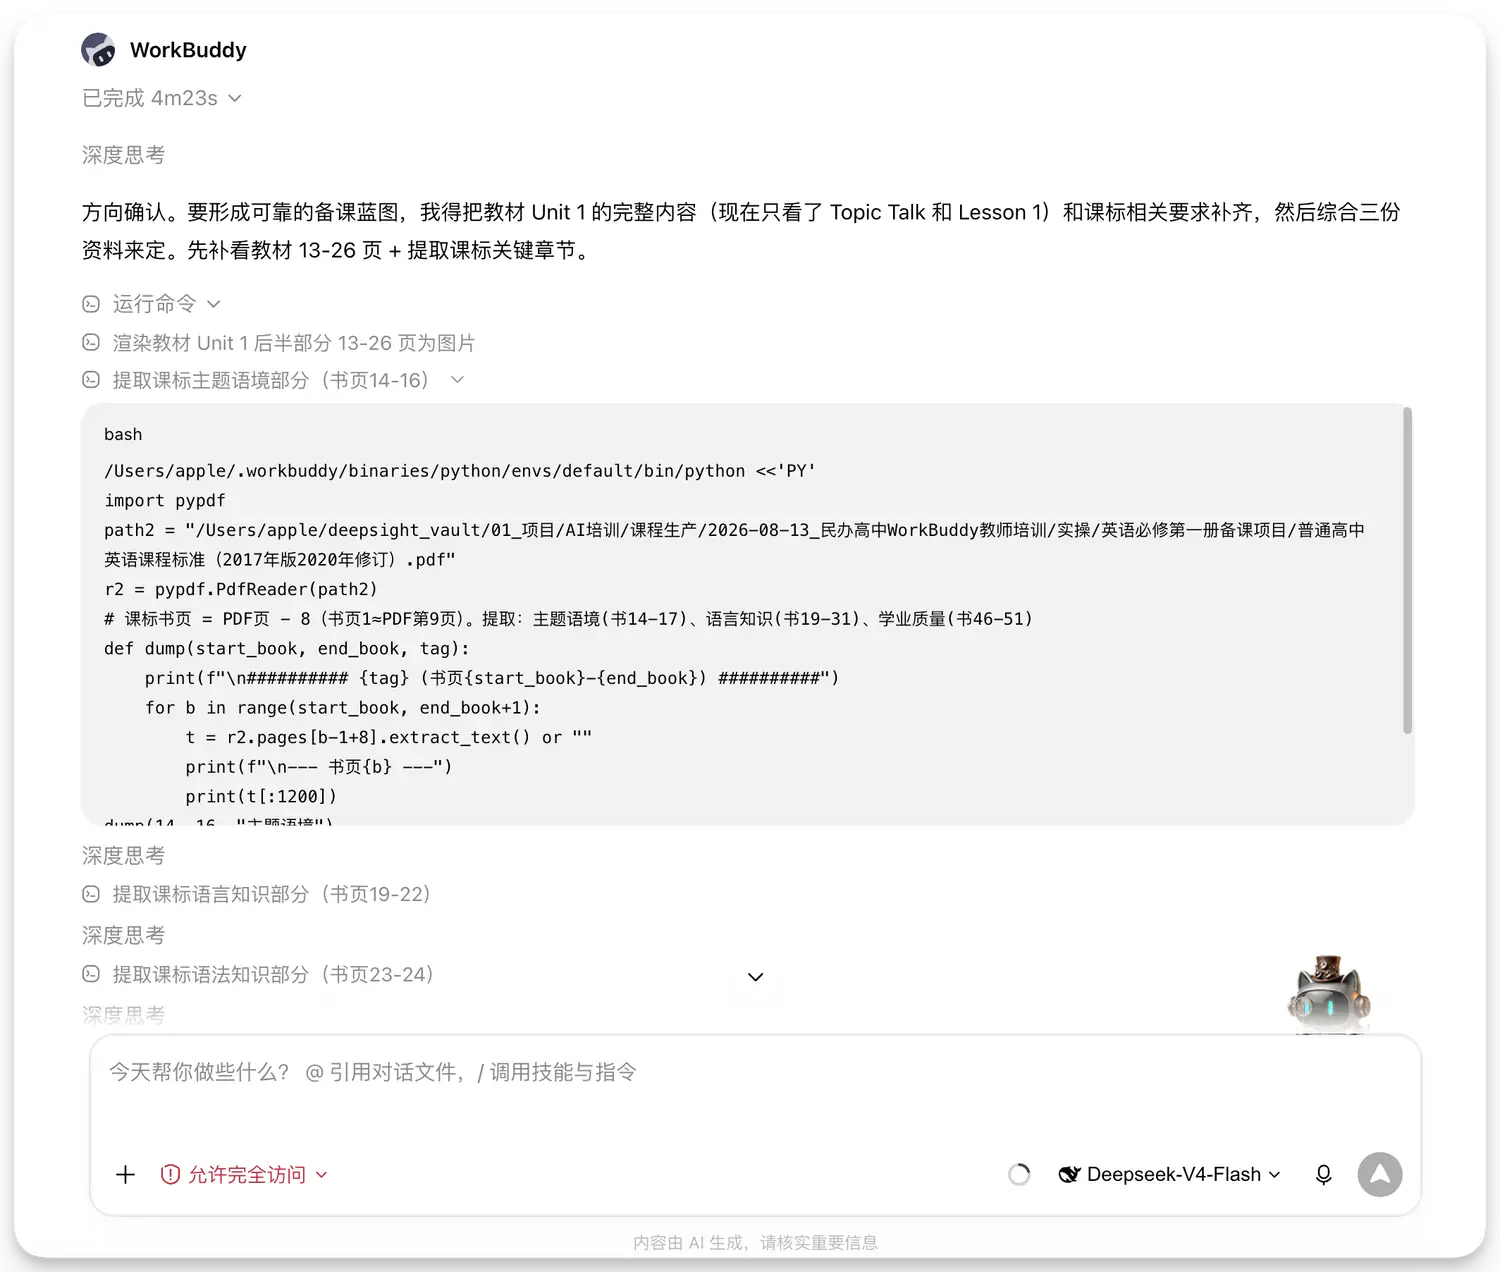
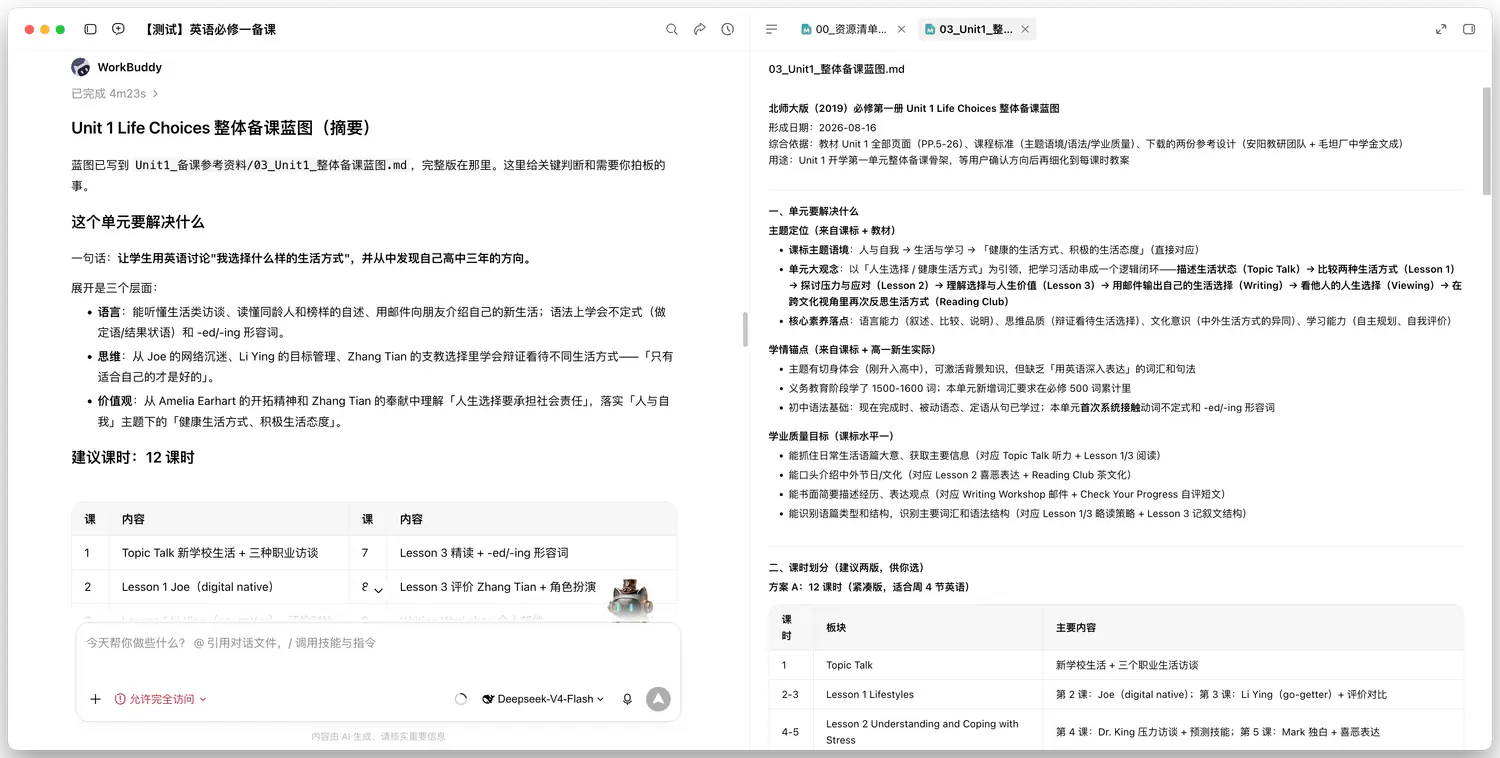
完整需求是问出来的,不是开场写进去的。
第四步,项目分身。这是全场培训我认为最值钱的一步。
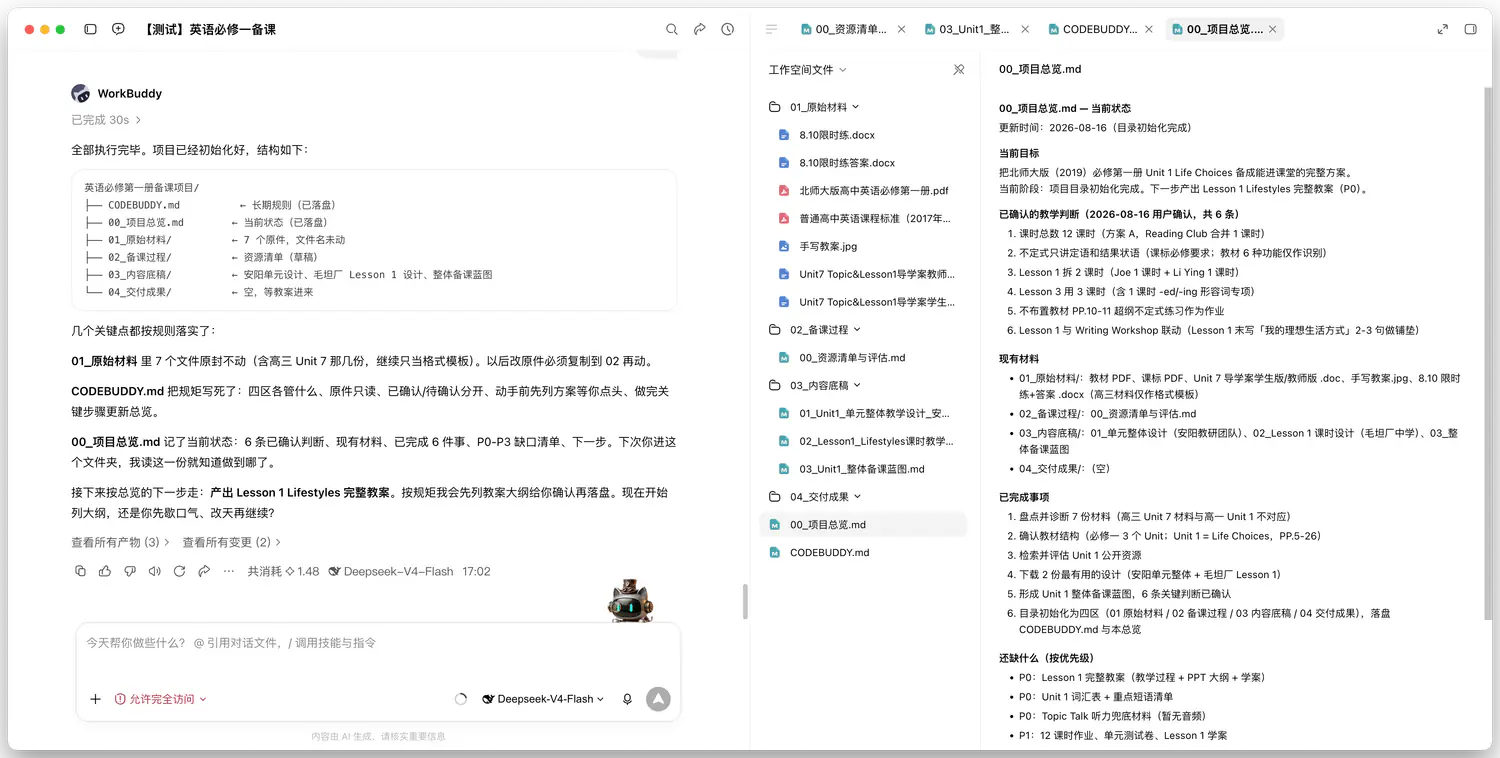
蓝图确认后,用一段自然语言把这个备课项目初始化:把文件夹按干活顺序分成四个区,再建两个文件。
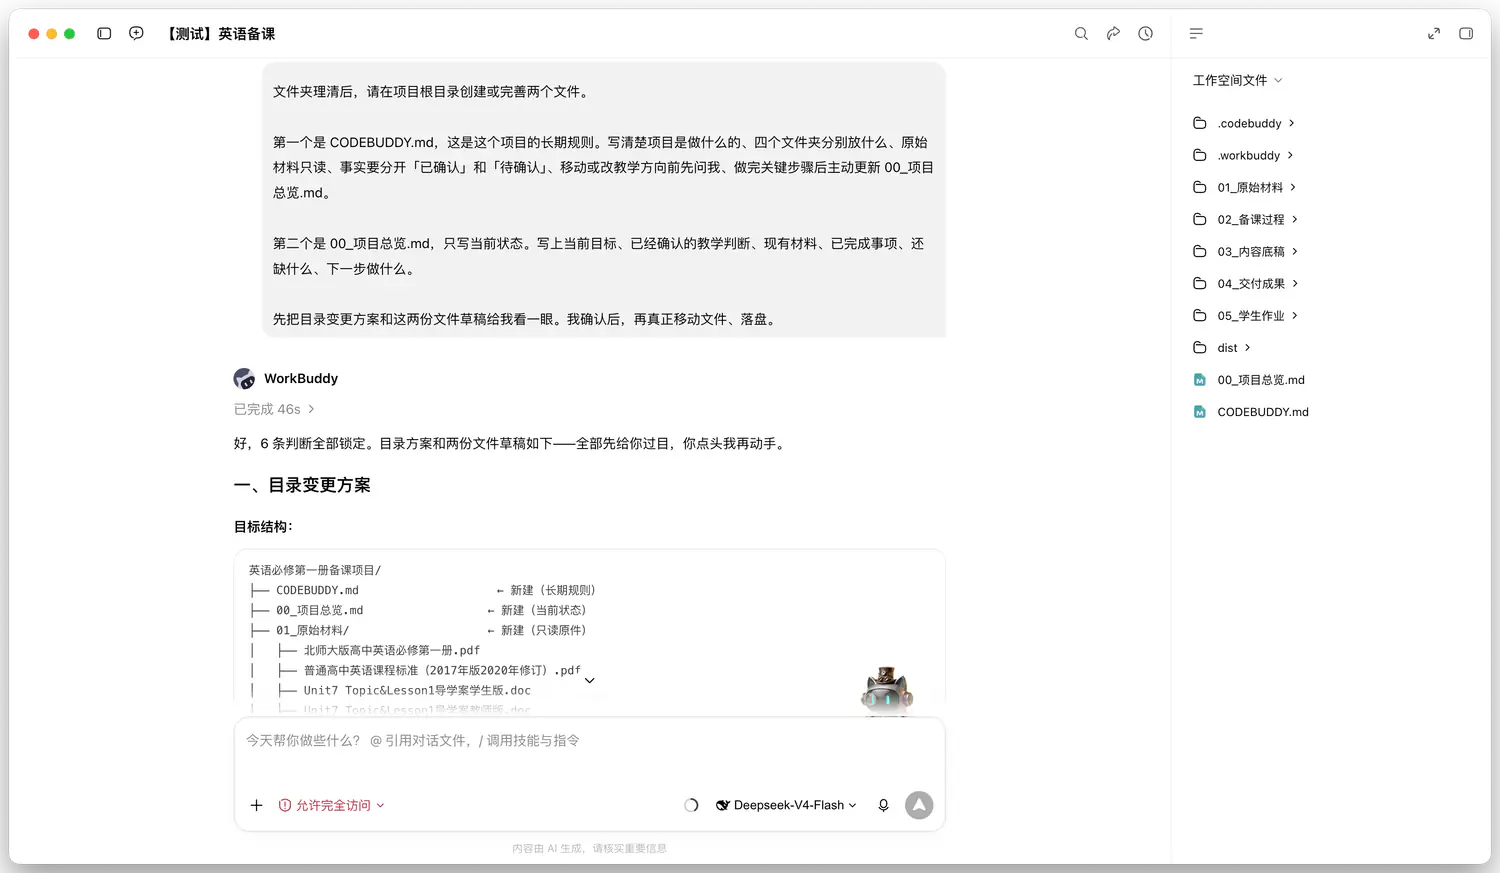
四个区:01_原始材料放别人给的和网上找来的原件,只读不改;02_备课过程放没定稿的中间层,是草稿箱;03_内容底稿放已拍板的蓝图和采用的设计,是共用事实源;04_交付成果放能进课堂的东西。编号跟着加工顺序走:先读原件,再加工,再沉淀,最后出成品。
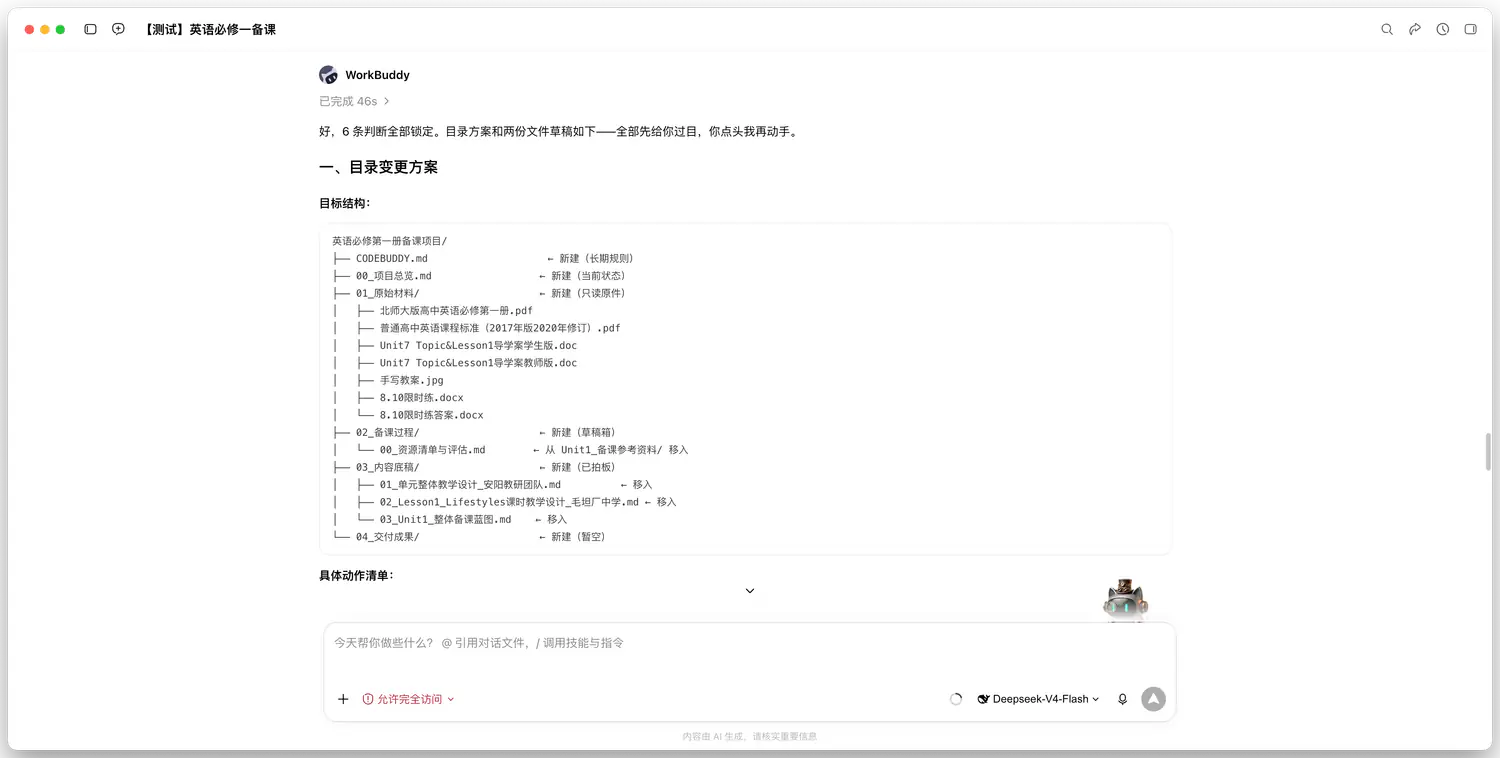
两个文件。
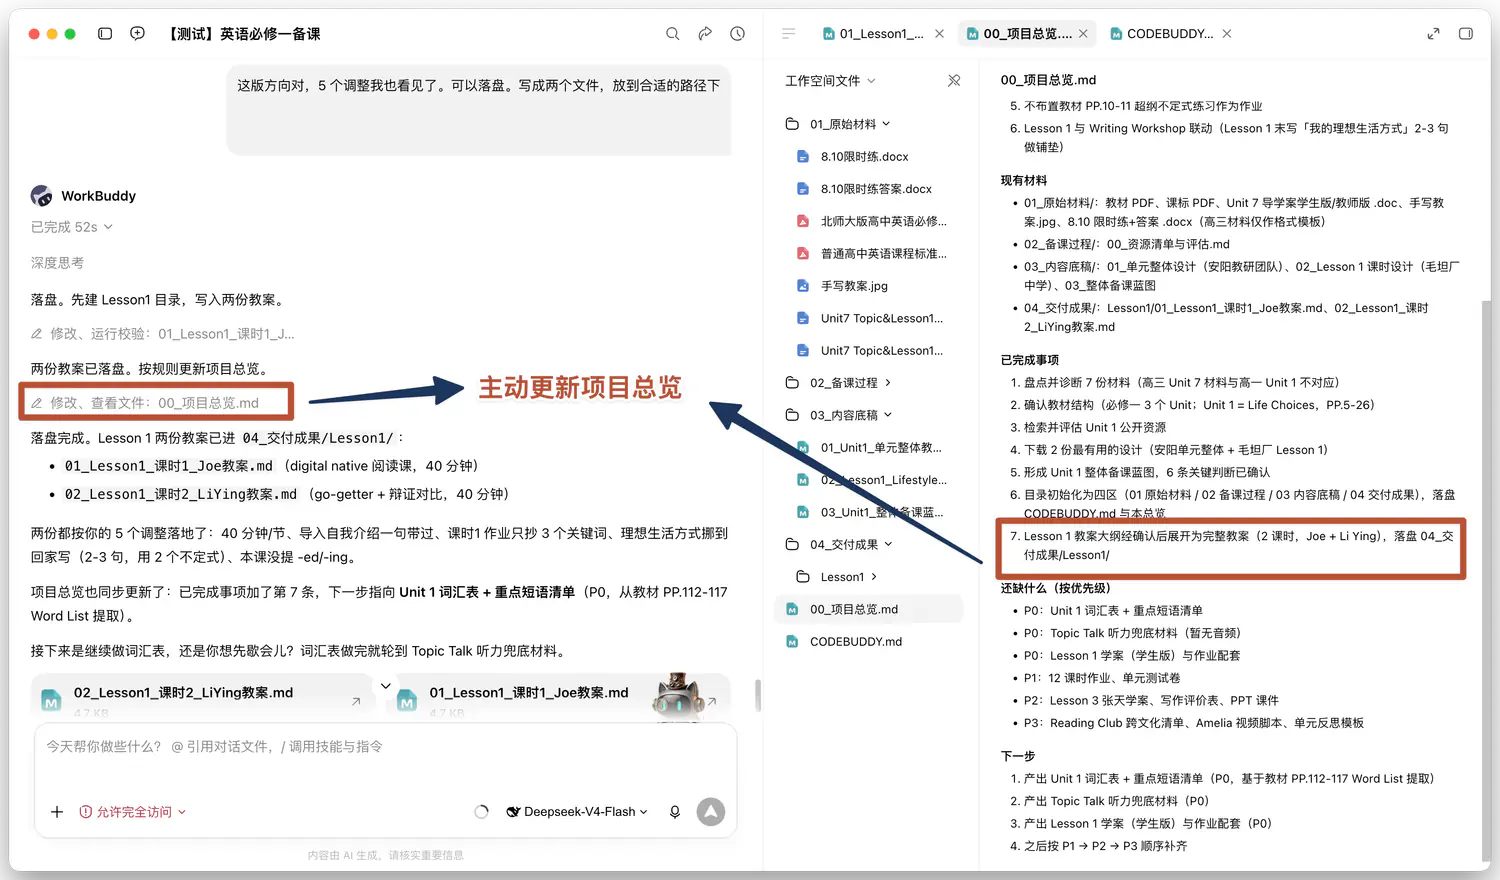
一个叫 CODEBUDDY.md,写这个项目的长期规则:项目是做什么的、四个文件夹各放什么、原始材料只读、事实分「已确认」和「待确认」、移动文件或改教学方向前先问我、做完关键步骤主动更新总览。
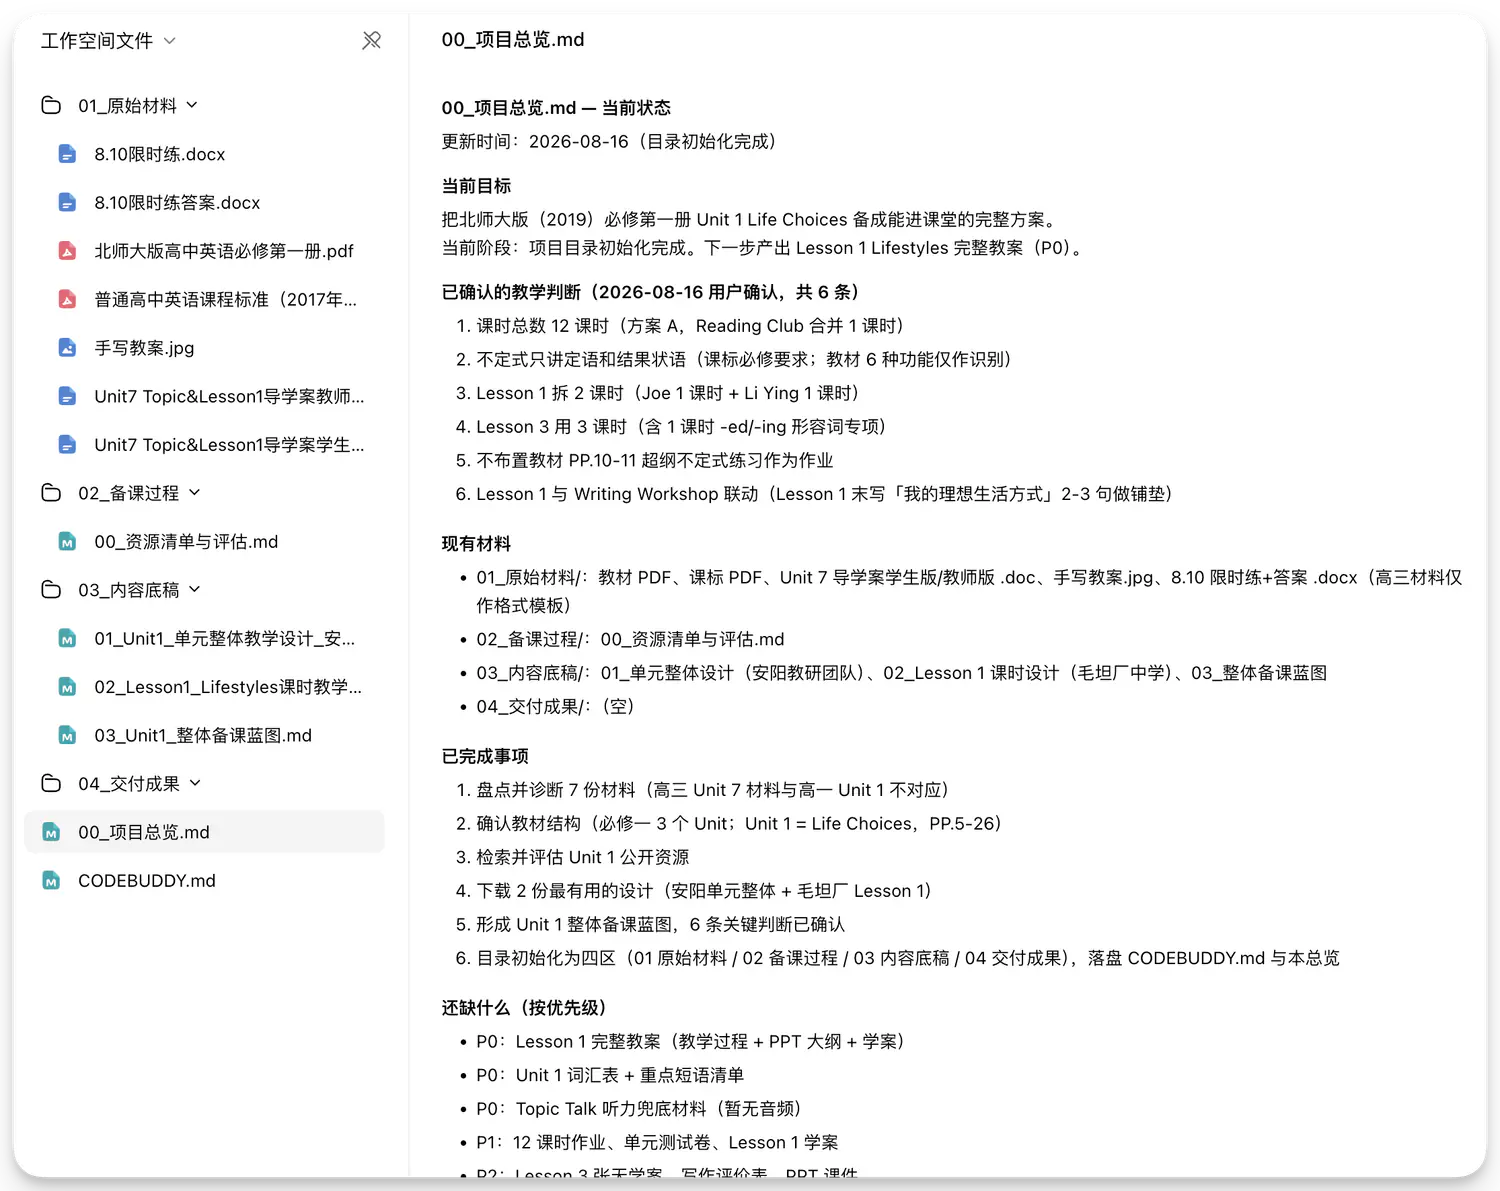
另一个叫 00_项目总览.md,只写当前状态:目标、已确认的判断、现有材料、做完什么、还缺什么、下一步。
解释一下 CODEBUDDY.md。它就是行业里说的系统提示词。你在对话框里打的字,是用户提示词,只管下一步;系统提示词是提前预设的规则,每次对话开始的一瞬间就自动加载进模型脑子里,永远生效。
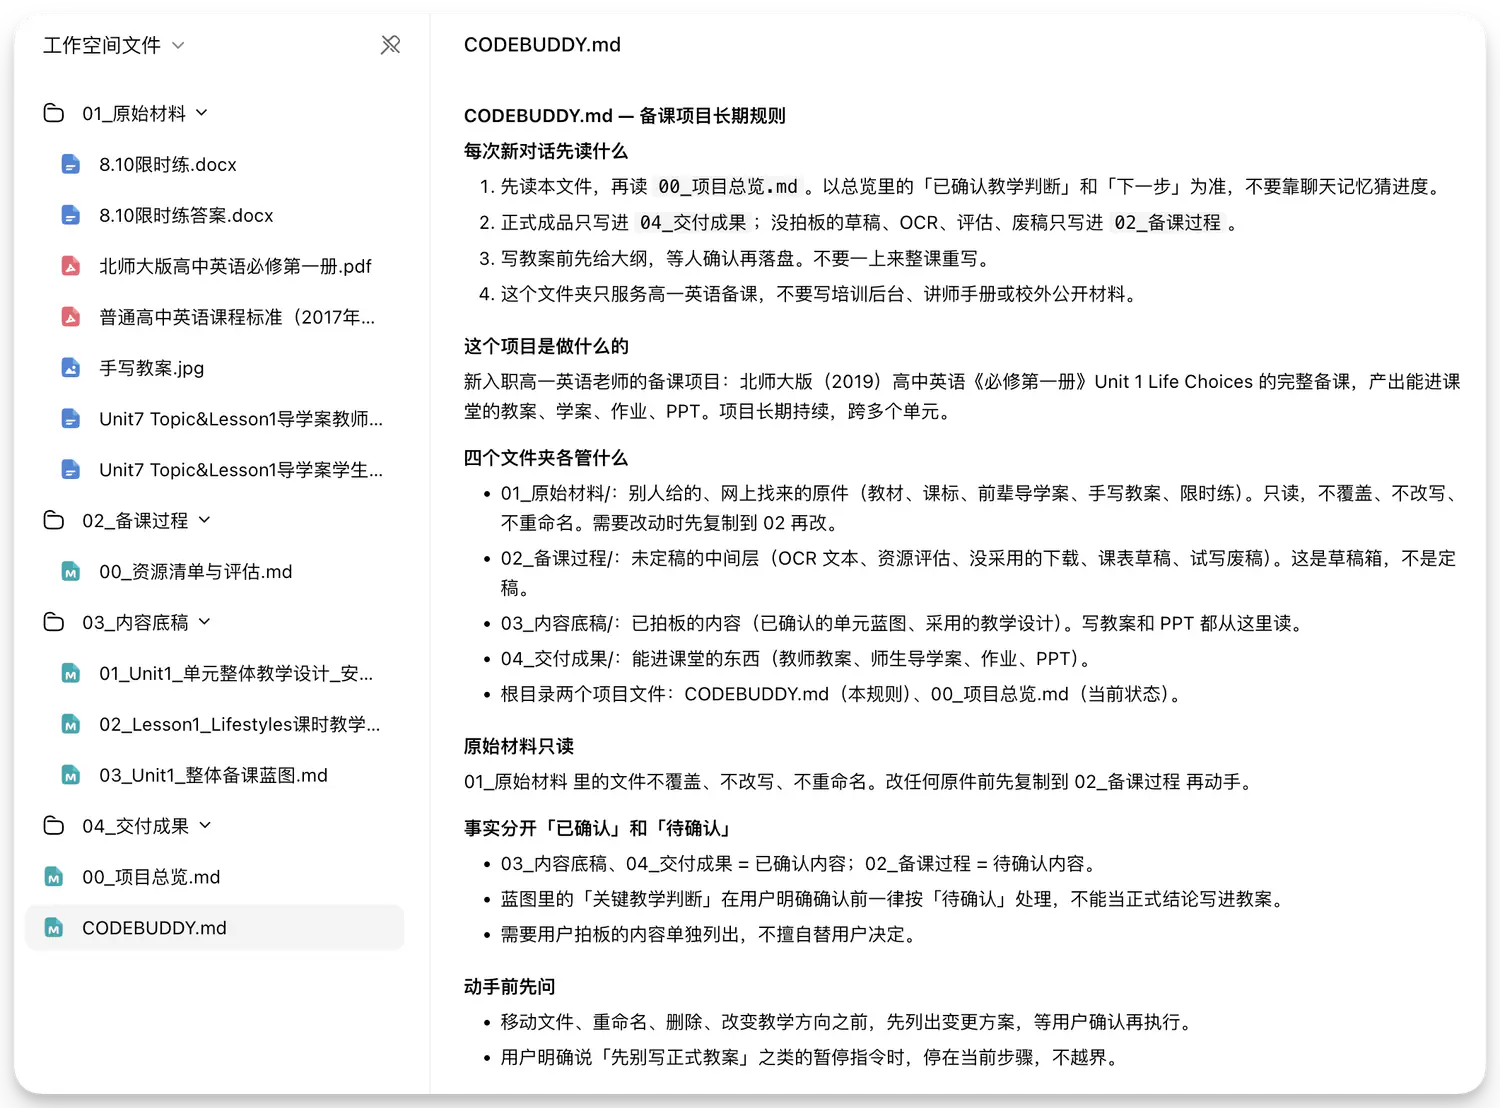
现场我拿政务大厅打的比方:你走到窗口跟业务员说的话,是用户提示词;那位业务员入职时领的员工手册,是系统提示词。手册决定他怎么办事,你的话决定这一单办什么。
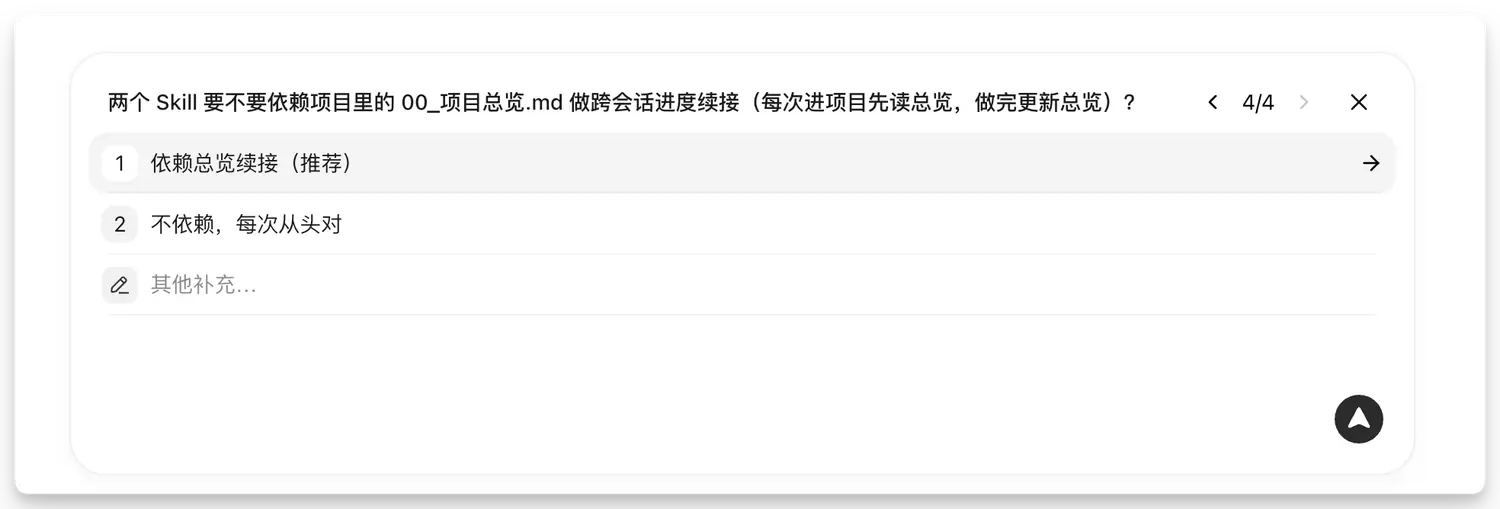
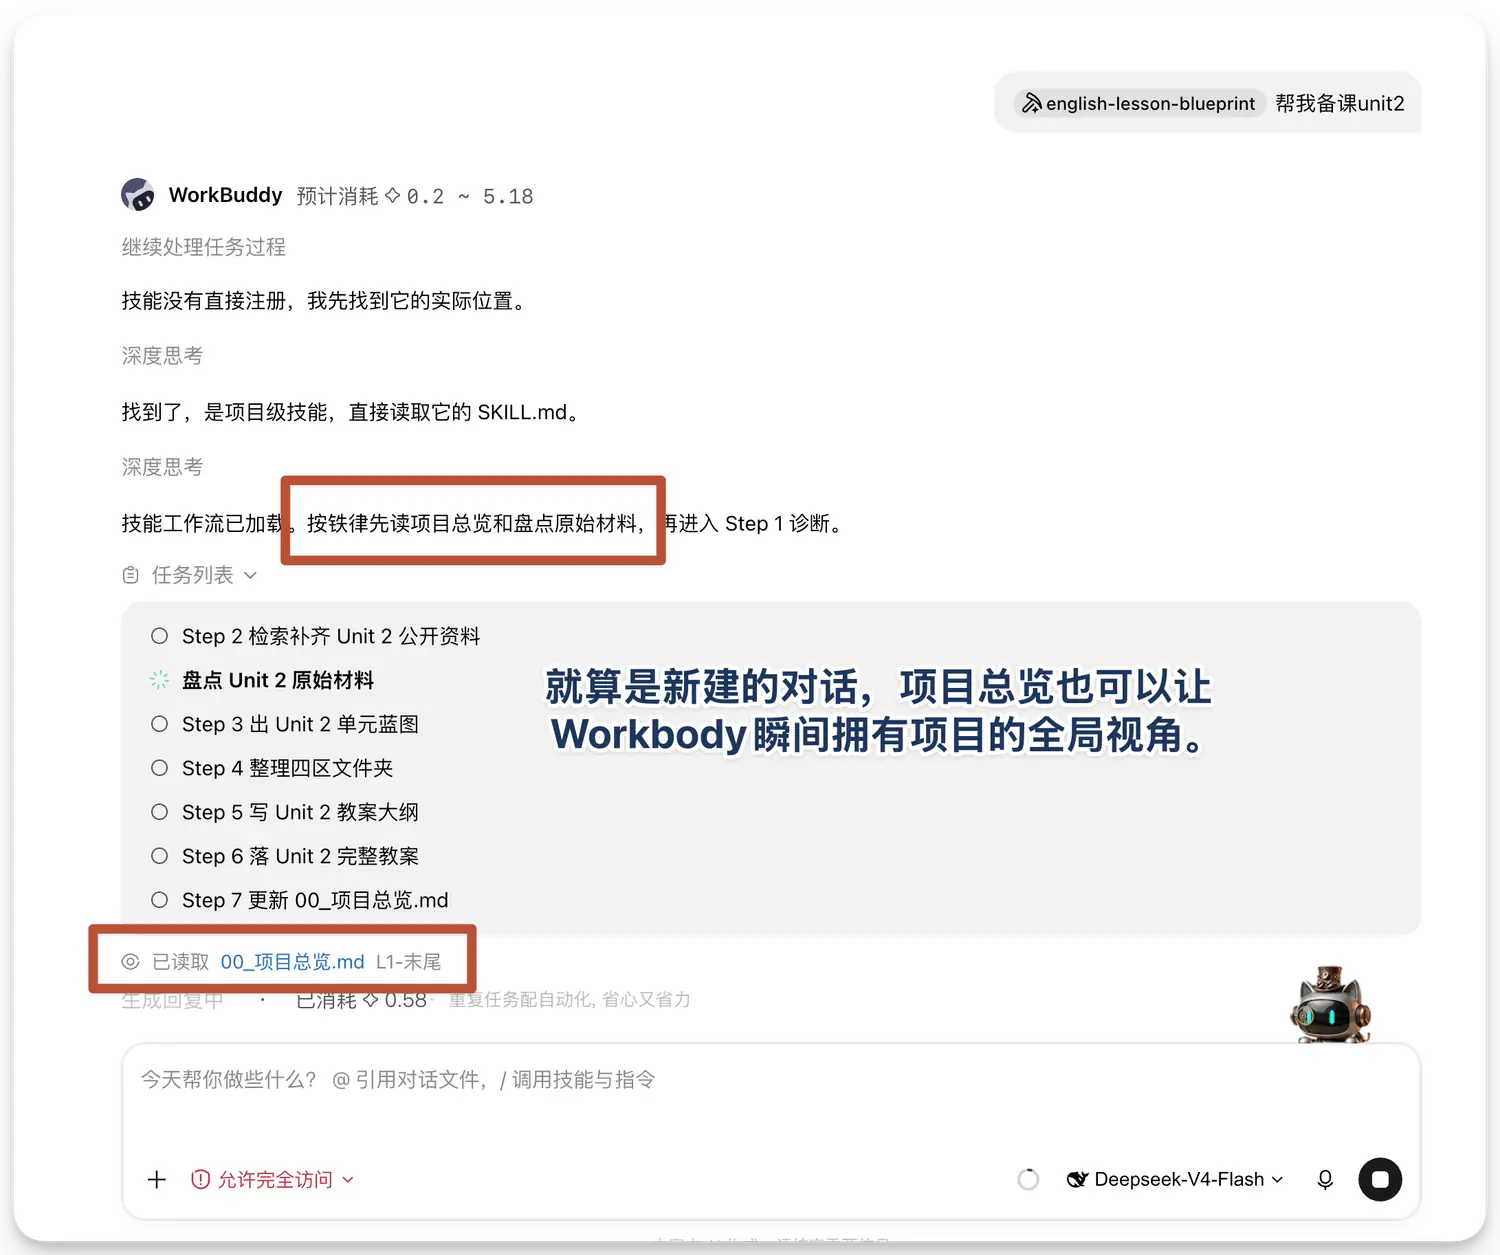
00_项目总览.md 则是状态文件。Agent 保持不了聊天记忆,但文件就是它的状态。每次新对话先读这两份,规则和进度就都在了。
验证很直接:新开一个对话,问「这个备课项目现在什么状态,下一步做什么」。它几秒钟就答上来,不用重新翻一遍文件夹。这两份文件合起来,我管它叫项目分身——规则和状态落在文件里,不靠聊天记忆。
第五步,教案。
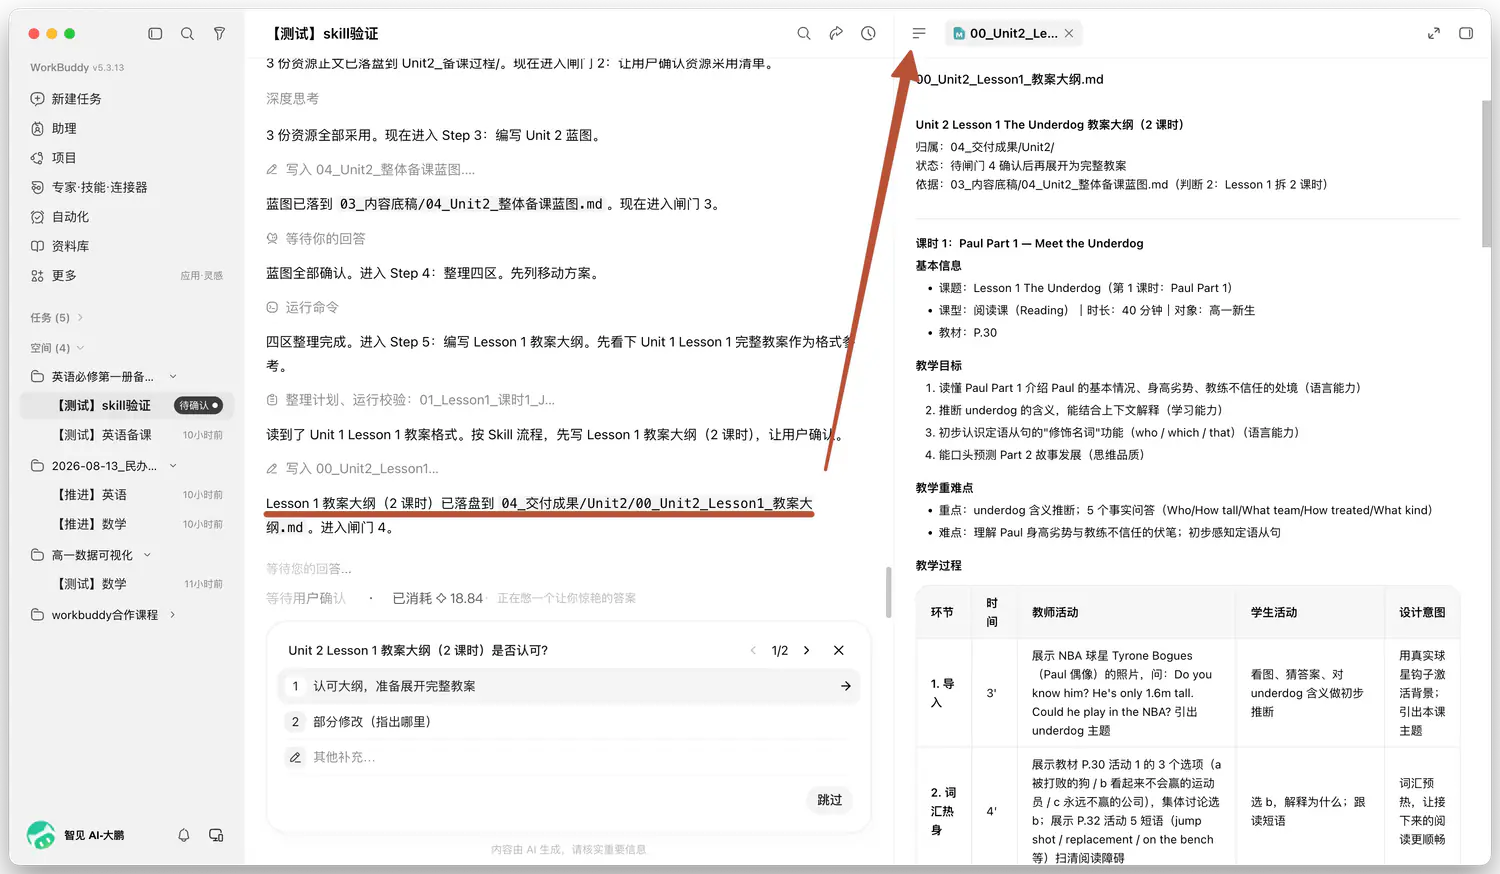
新老师不会拆课、拿不准重难点,可以让 AI 带着备:你按蓝图带着我把 Lesson 1 备起来,先别写完整教案,先给我大纲,把为什么这么安排用我能听懂的话说清楚,我看不懂的会问,我点头了再写成能进课堂的教案。
它给大纲的时候真的在教:为什么先读 Joe 再读 Li Ying——先学会读自述文;为什么每课都走导入、预测、速读、精读、输出——新老师不容易乱;为什么语法放进课文里看,不单开一节。甚至讲到图式理论:读前先聊「你课余干什么」,是先激活学生脑子里已有的经验,读起来不慌。
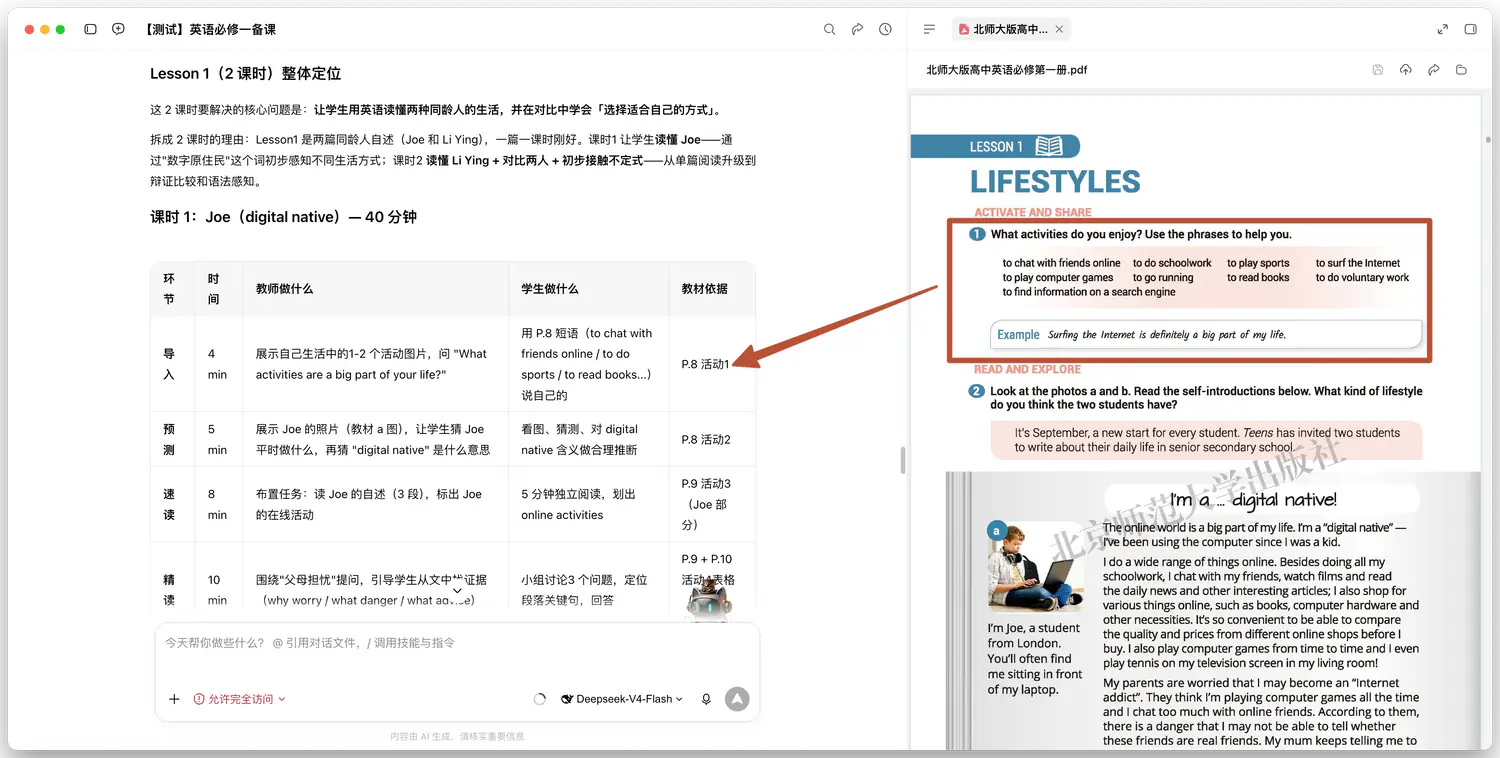
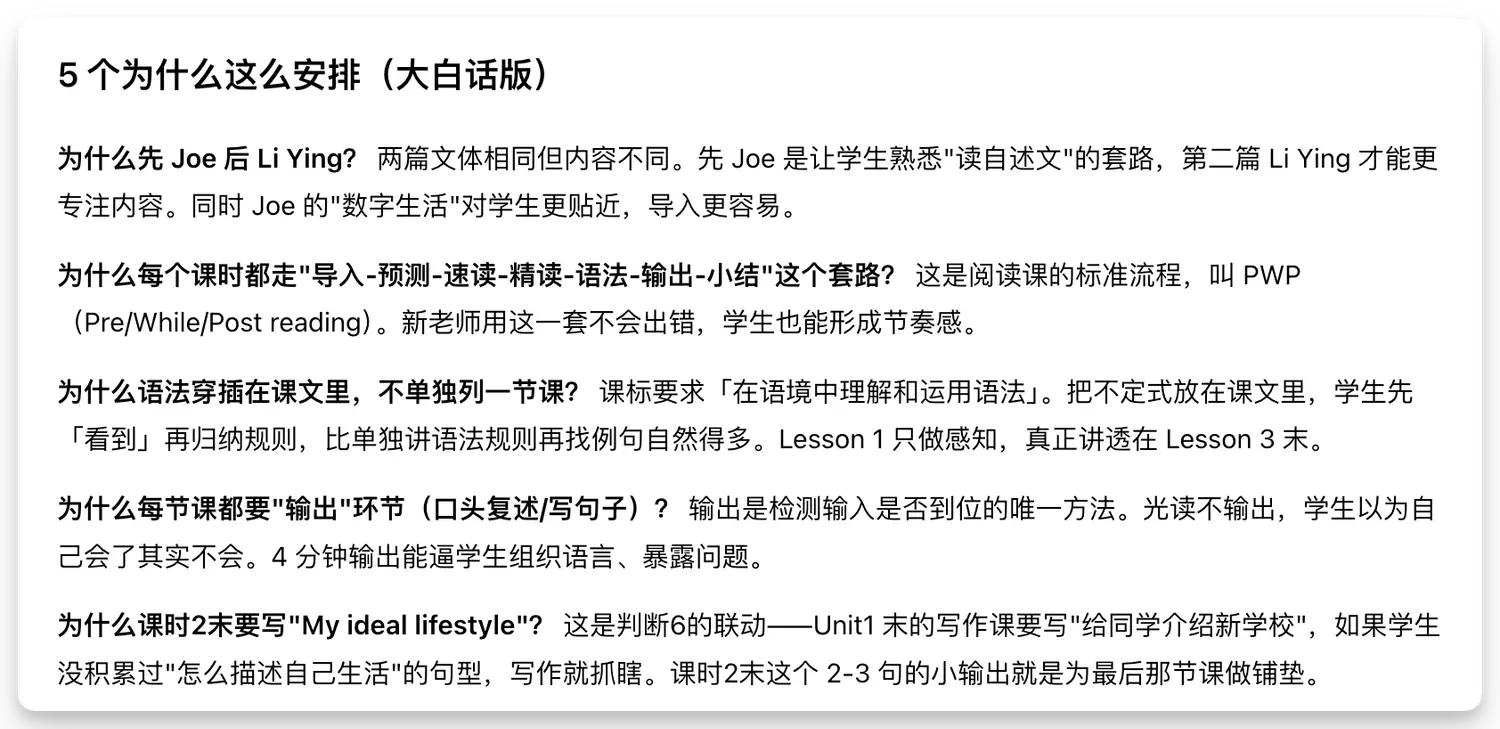
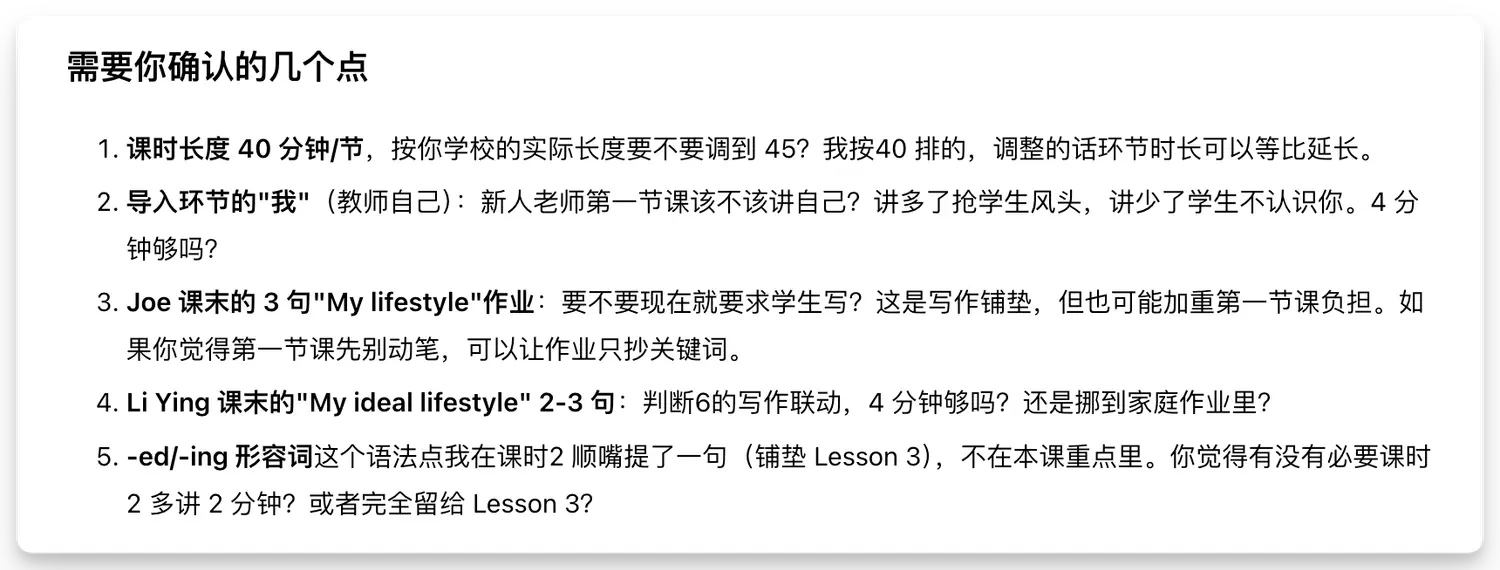
和 AI 协作备课的过程,本身就是新老师的带教课。
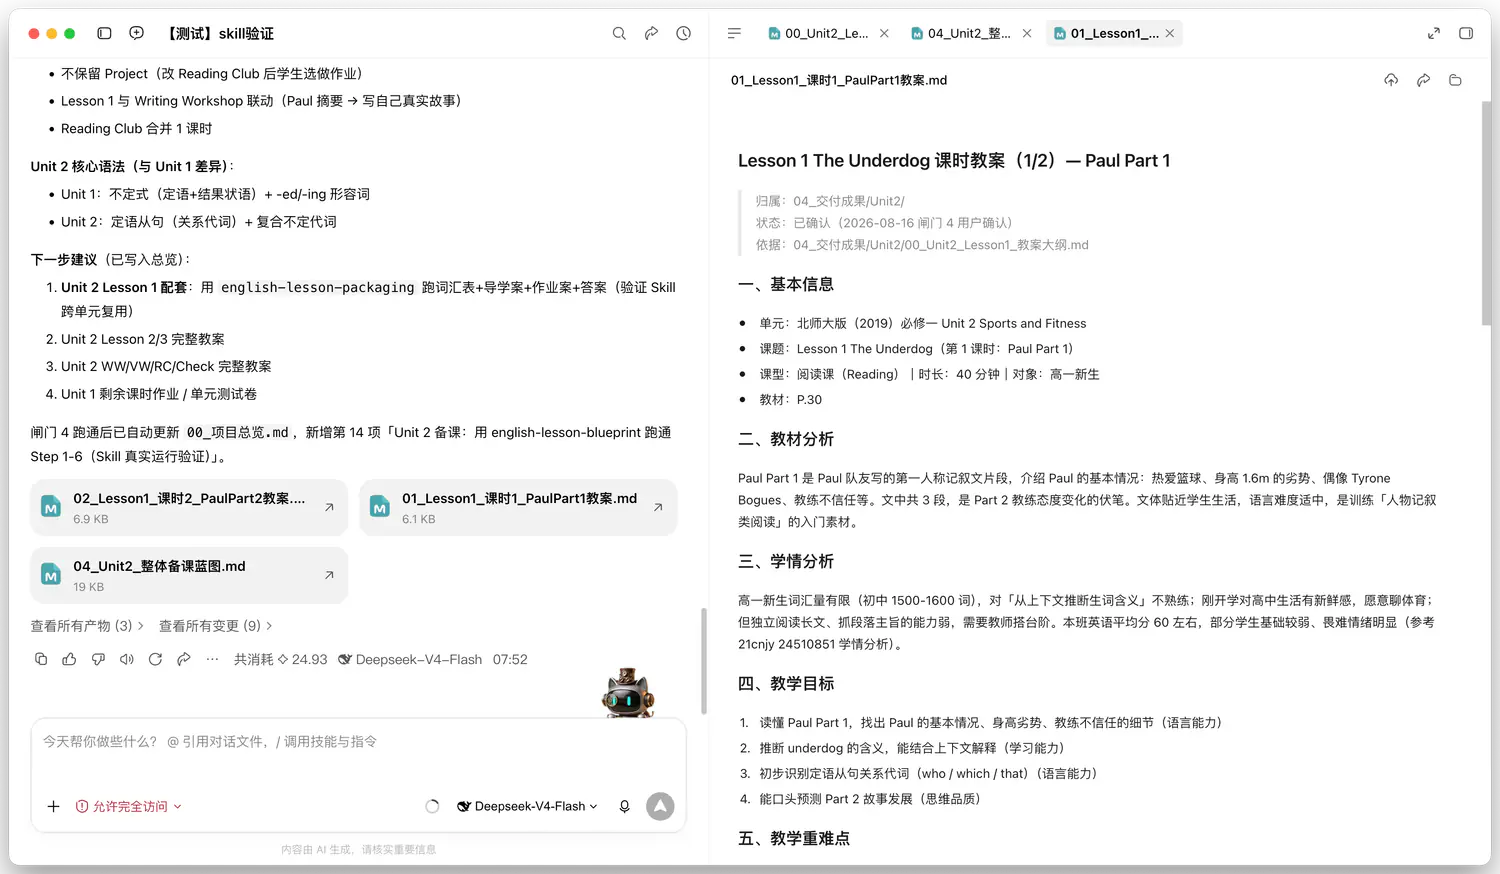
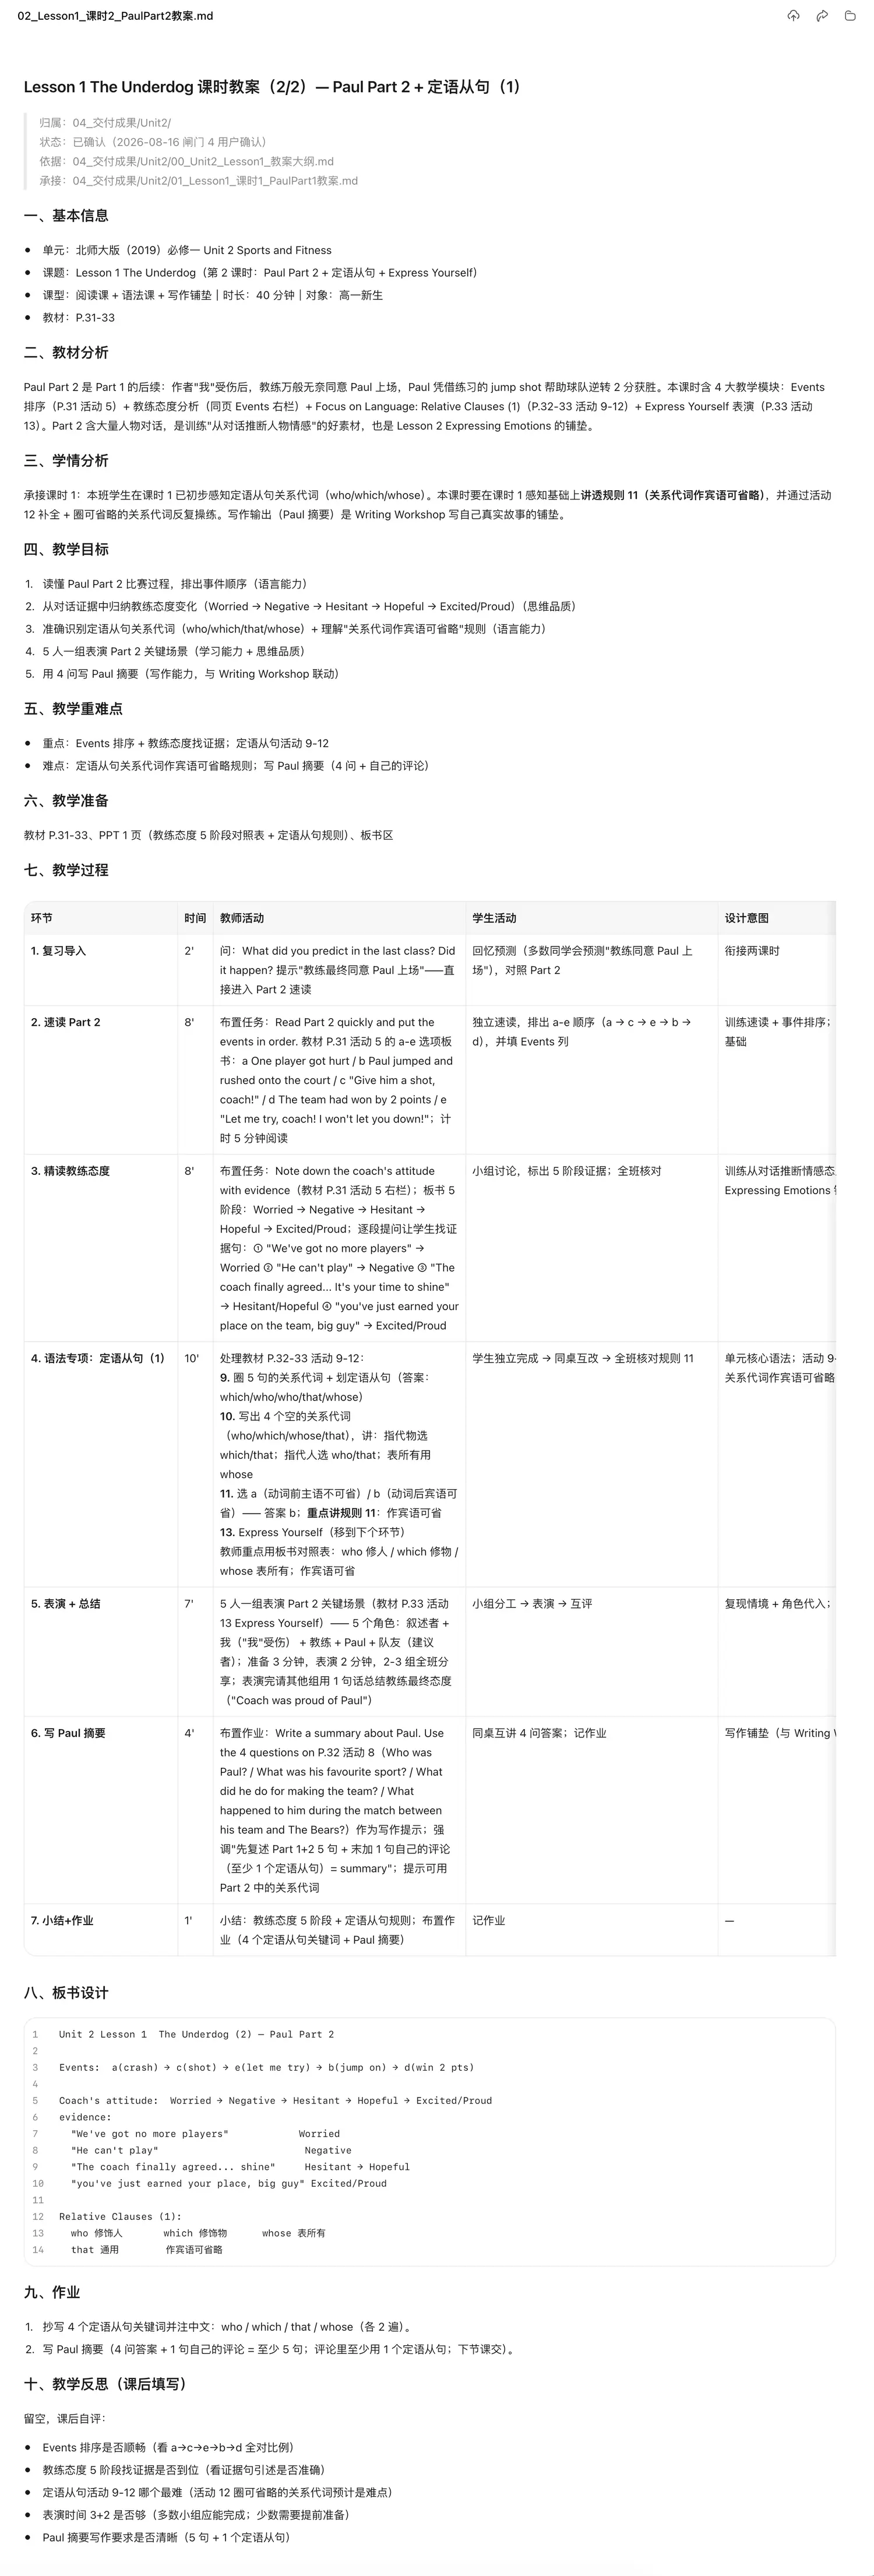
大纲确认后写完整教案。老师回了五条改口——一节课 40 分钟、导入别讲太久、作业先只抄关键词——它先把改口重写了一遍才动笔。老师只说「放到合适的路径下」,教案就进了 04_交付成果/Lesson1/,因为规则早写在系统提示词里了。它还自己更新了项目总览,把「下一步」改成了做词汇表。
现场一位资深英语老师看完教案的评价:环节、重难点和平时的要求一致,有的地方比他们日常写的更清晰。
第六步,学校模板:壳不能拆,只换字。
导学案要套学校模板,这一步翻车了两轮,翻得很有教学价值。
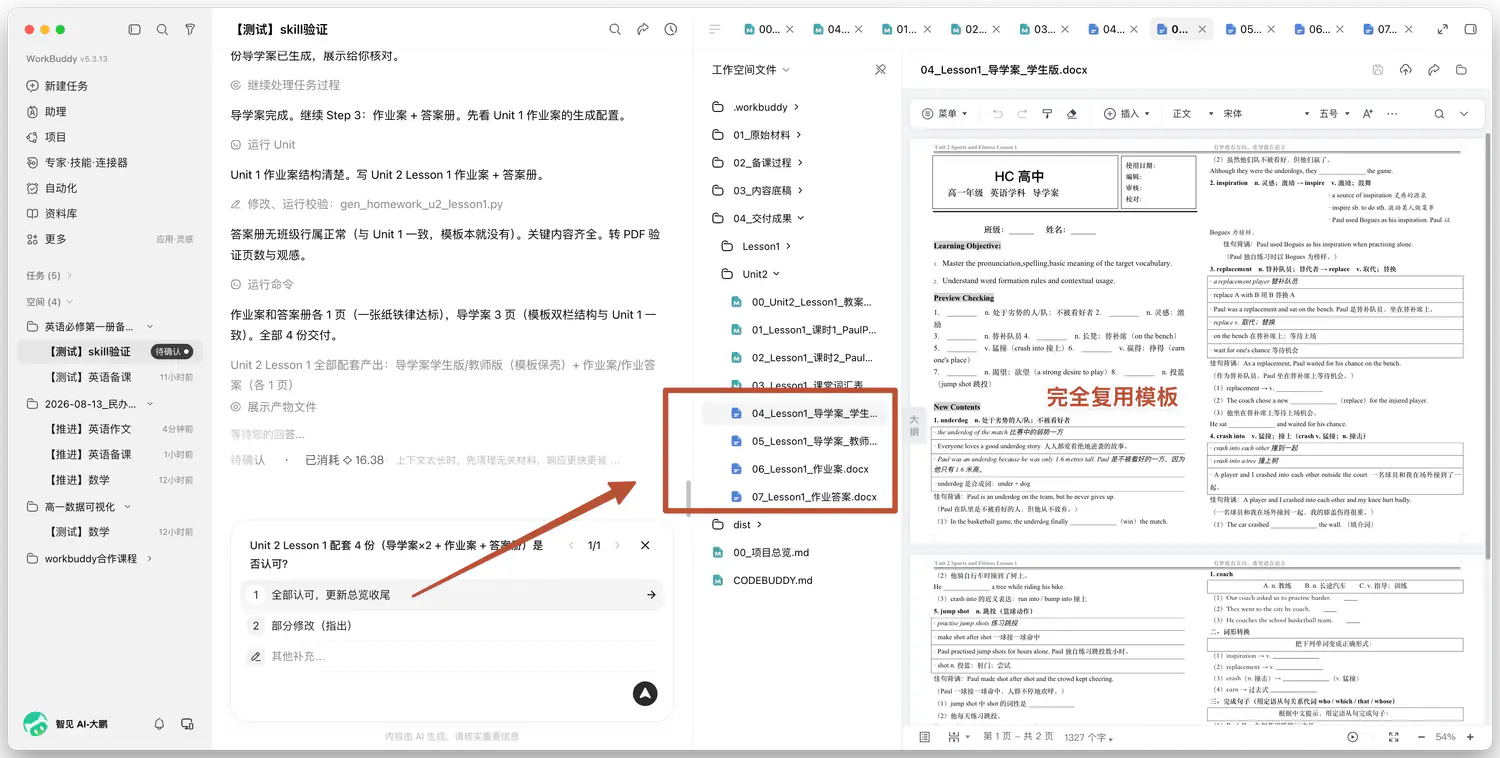
第一轮,它把学校模板的栏目学了一遍,用转换工具另起了一份新 Word。栏目差不多,但那不是学校那张纸,教务处不认。第二轮,它复制了模板,却清空正文、把双栏改成单栏——内容对了,壳拆了。
老师说了一句后来被写进手册的话:学校模板的壳不能拆。重新复制原件,只替换文字,页眉页脚、双栏、开头信息框、编辑审核栏都留着。
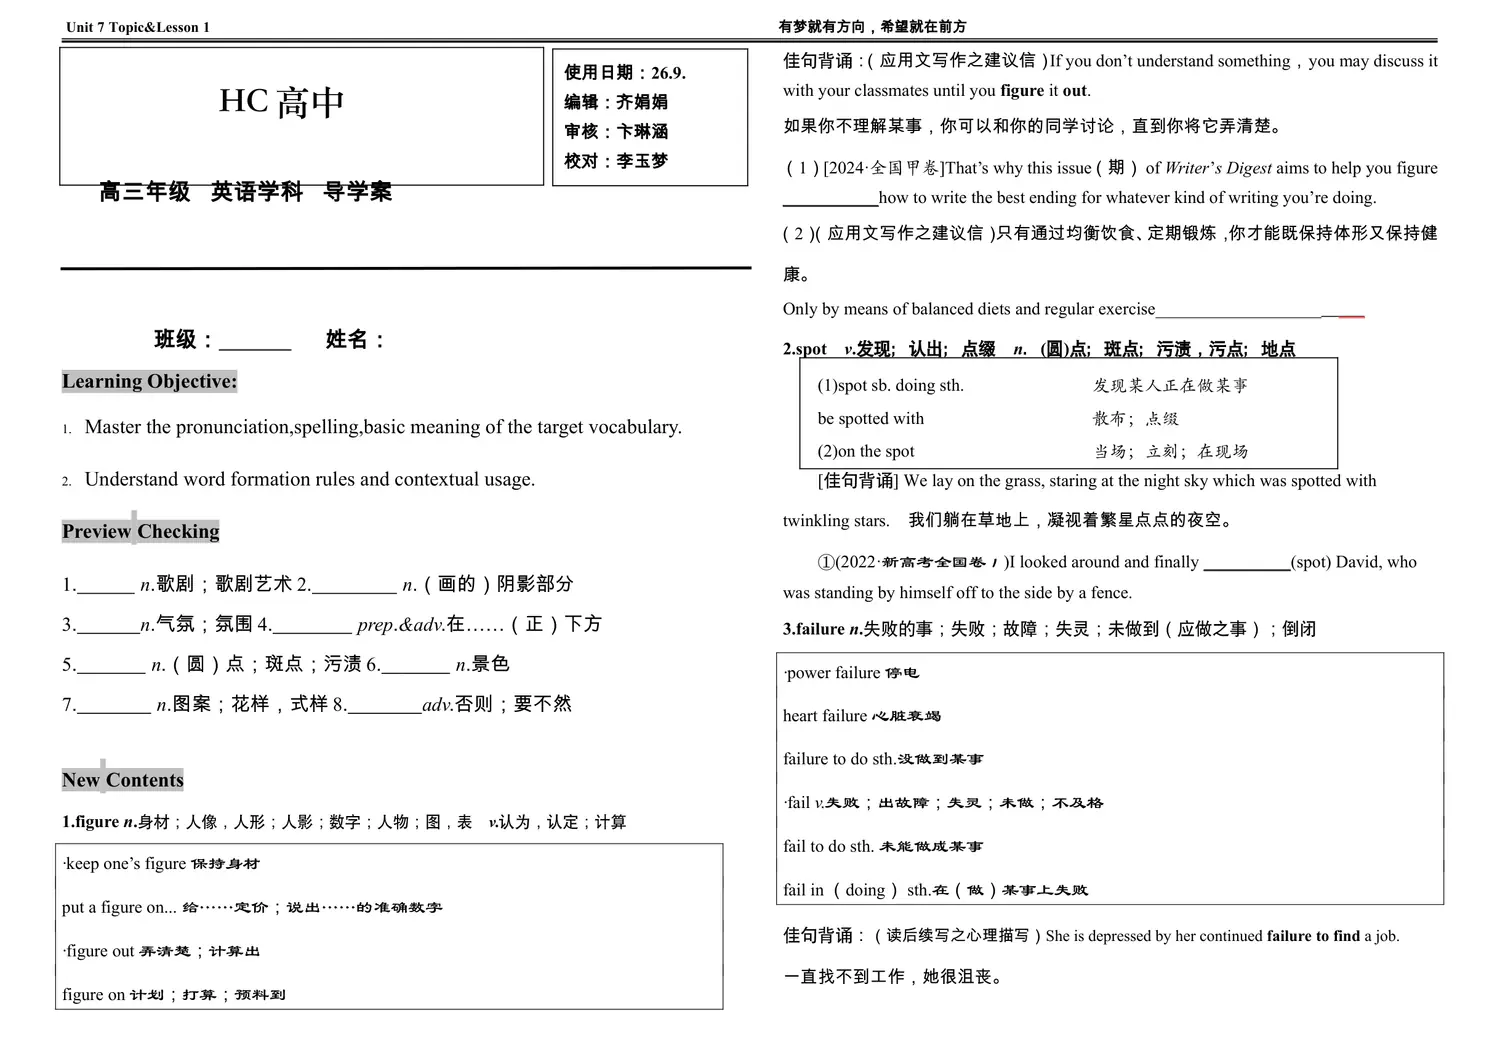
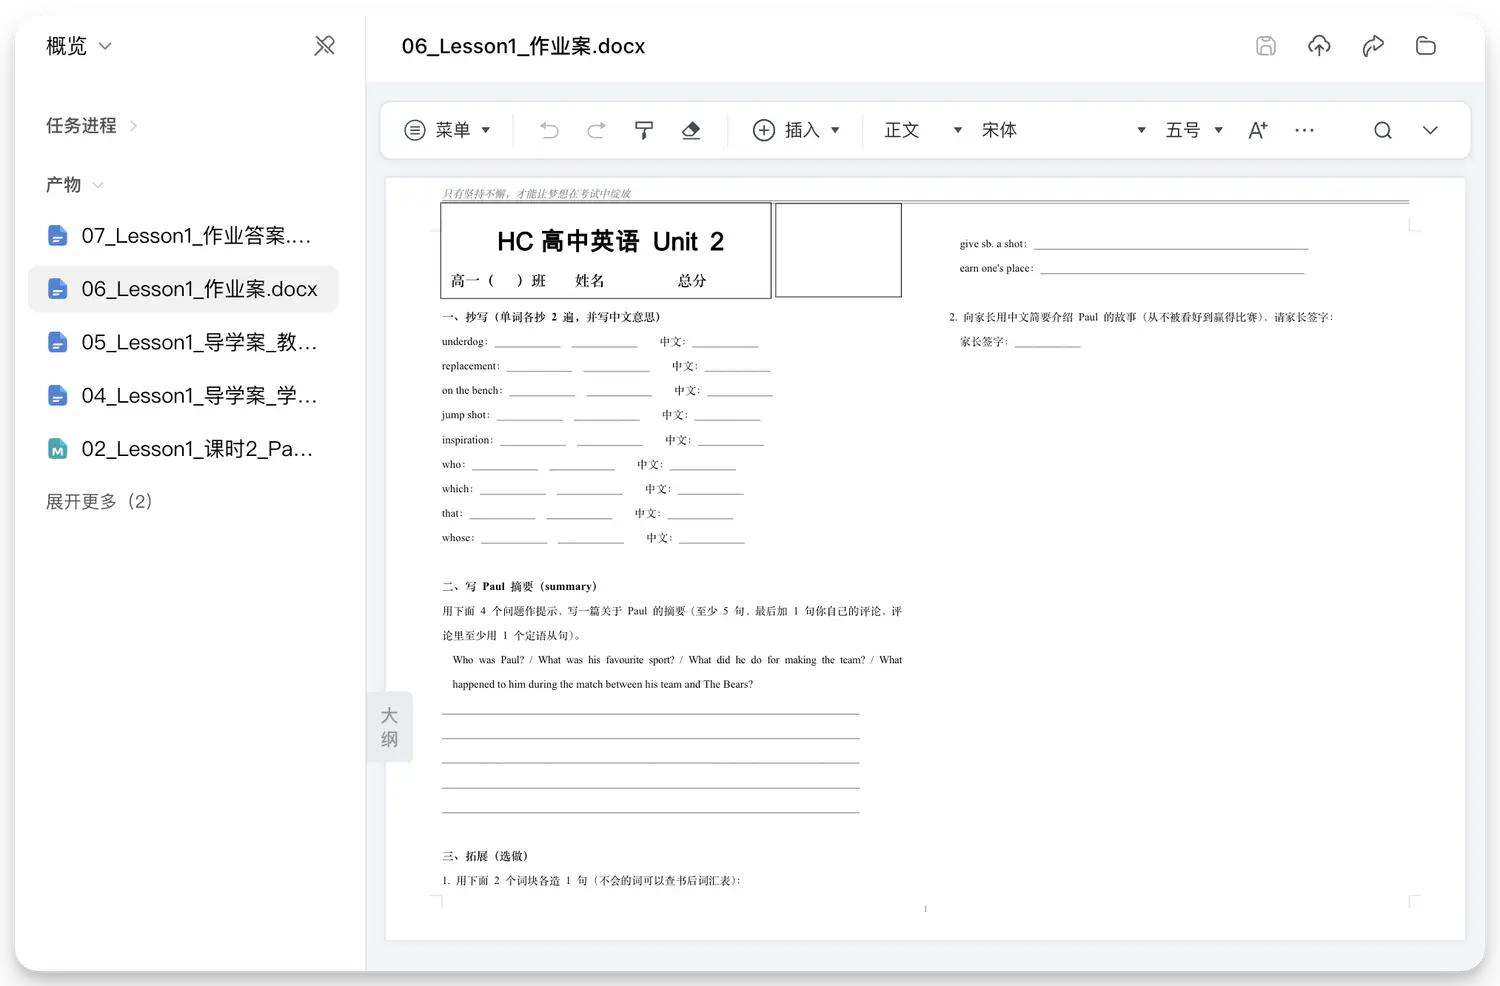
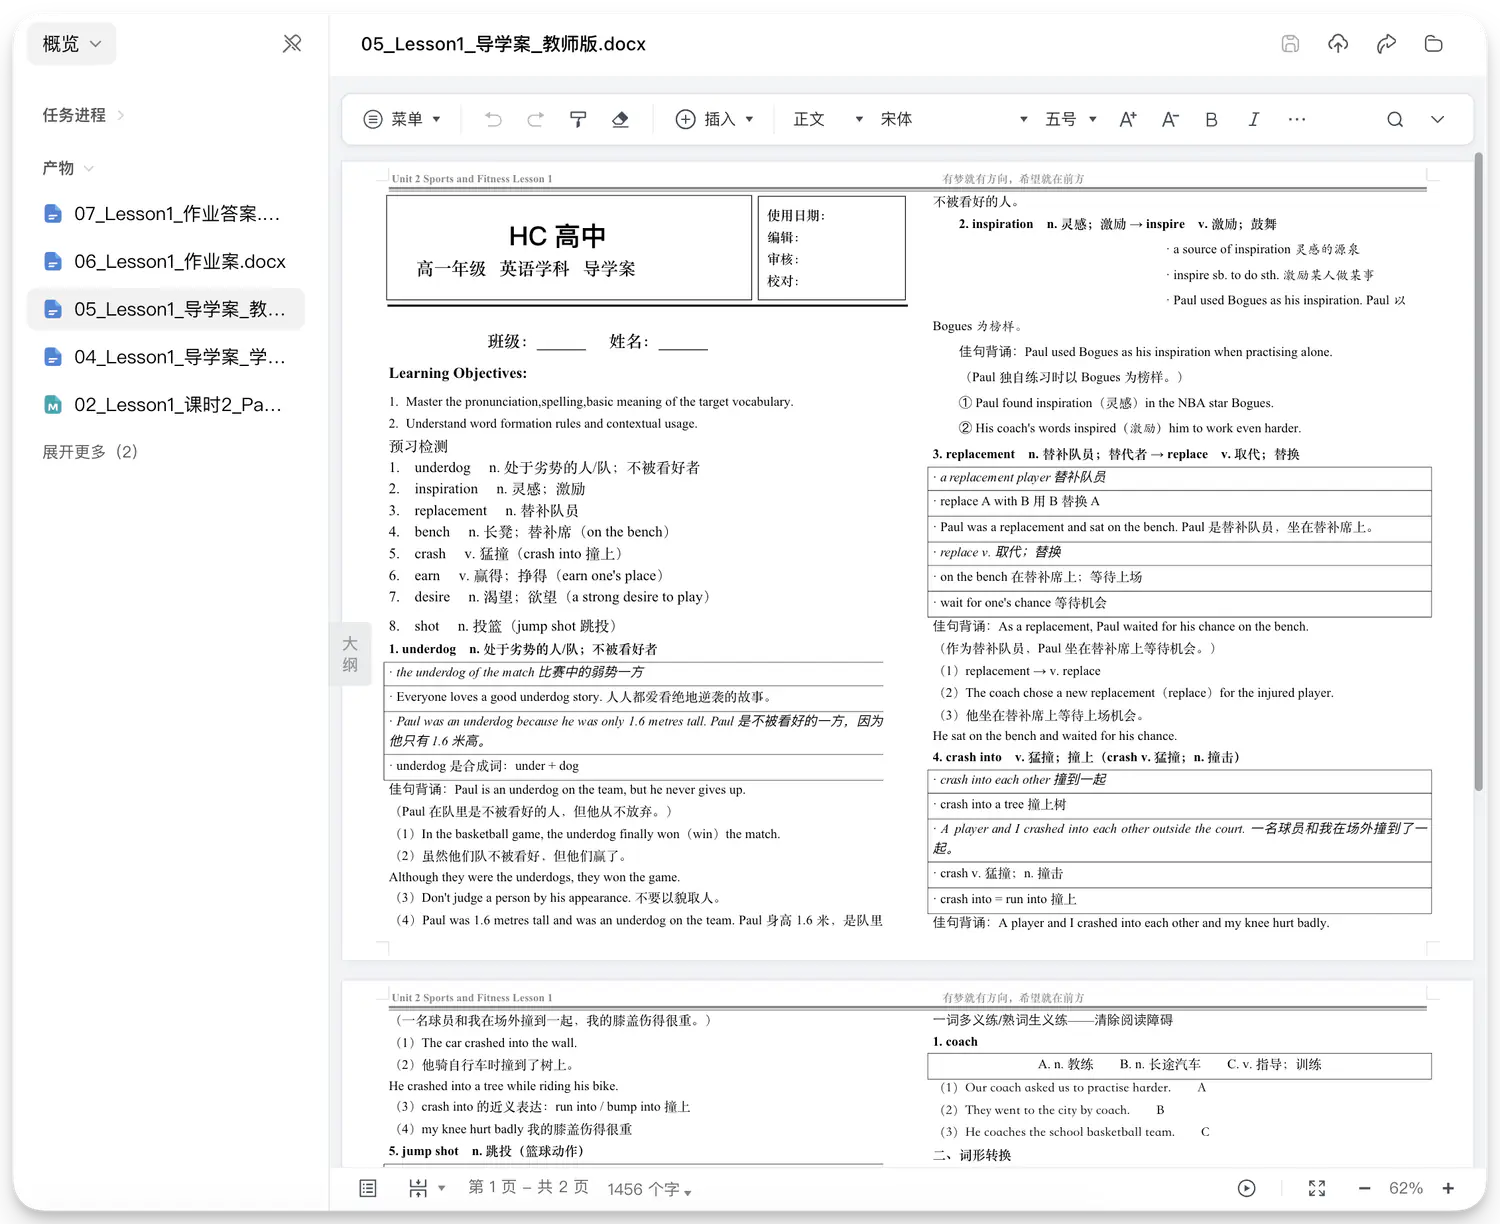
第三轮对了。左右双栏还在,学校信息框还在,页眉标语还在,换掉的只是课题、年级、单词和练习。高三的词、高考题、原模板编辑栏里的人名,全部清掉。
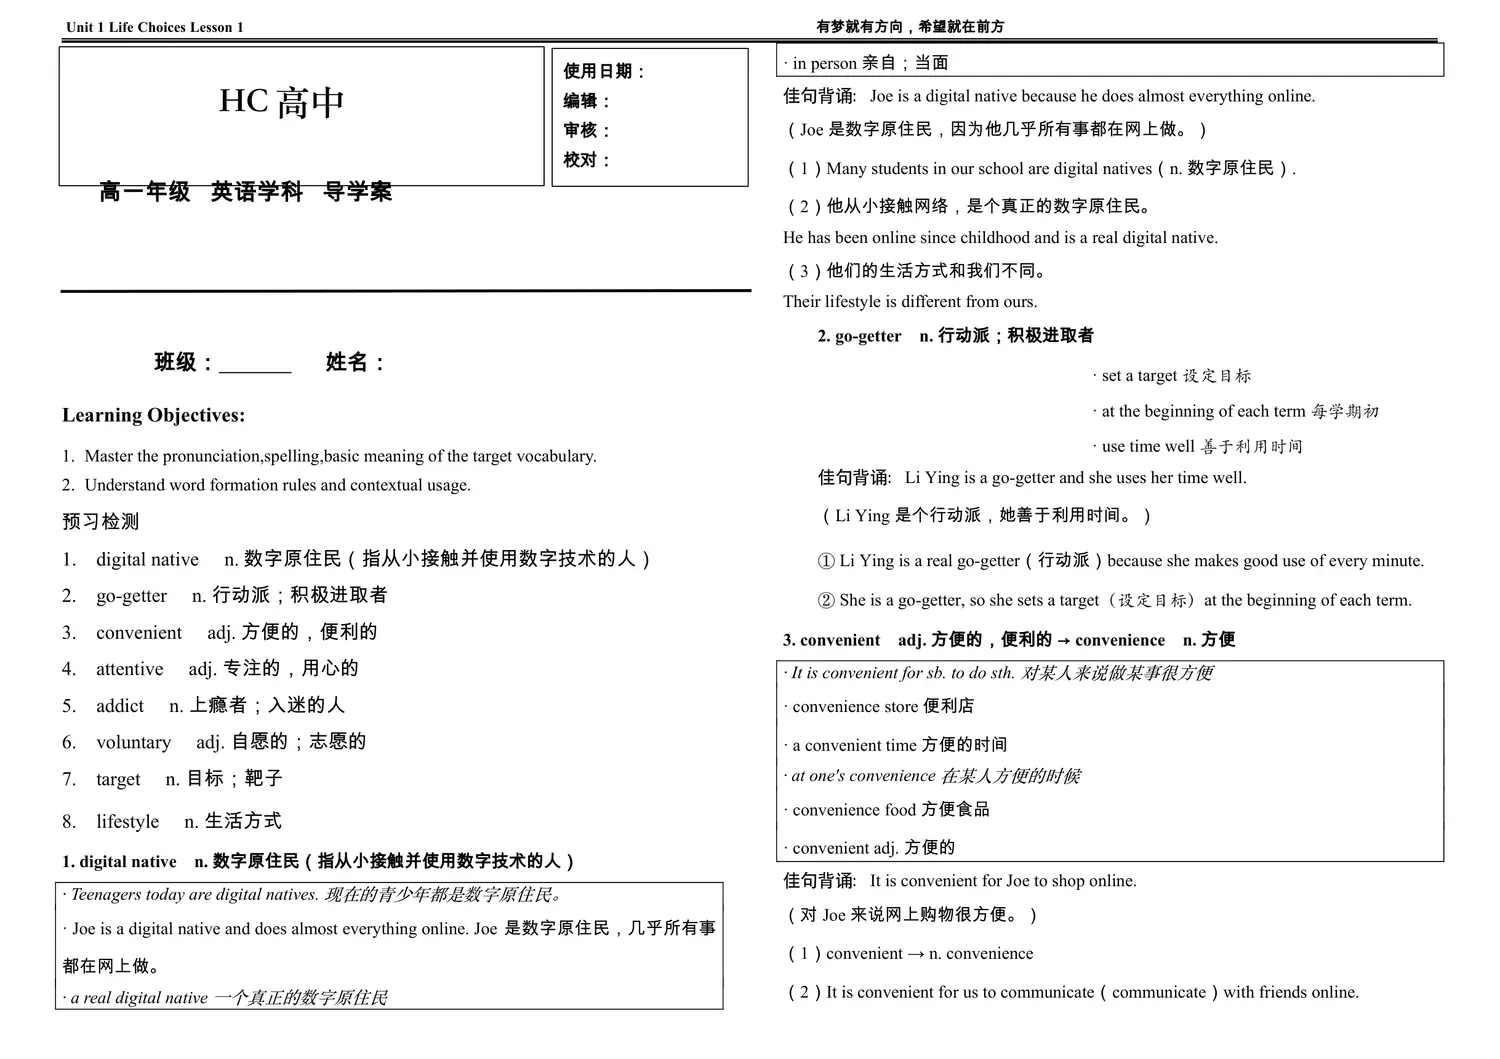
学校要的从来不是一份漂亮的新文档,是那张熟悉的纸上长出新学期的内容。这个细节在学校体系里工作的人都懂,AI 的默认输出做不到——除非你说出来。
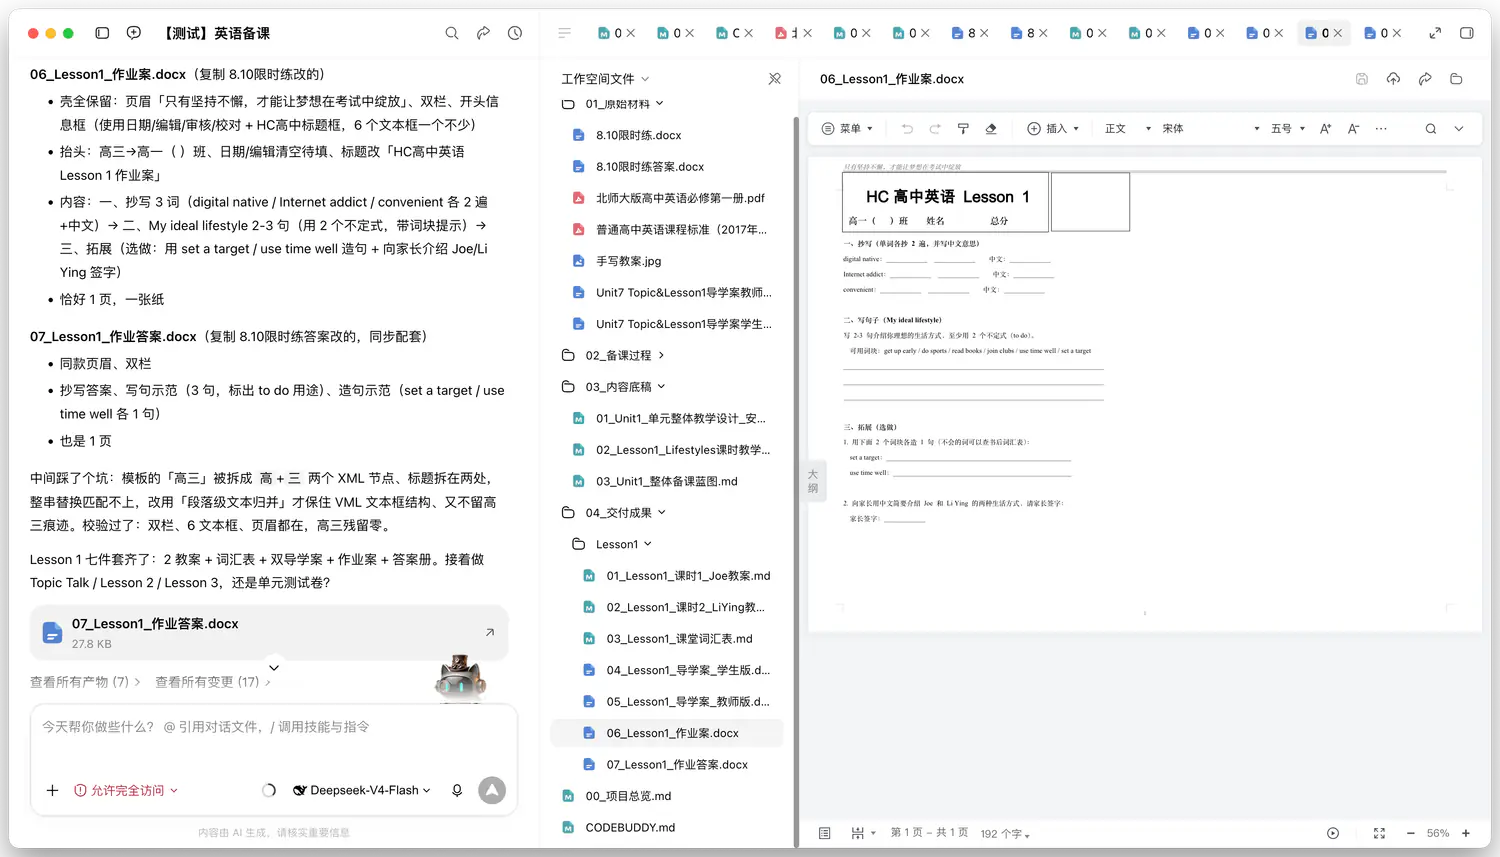
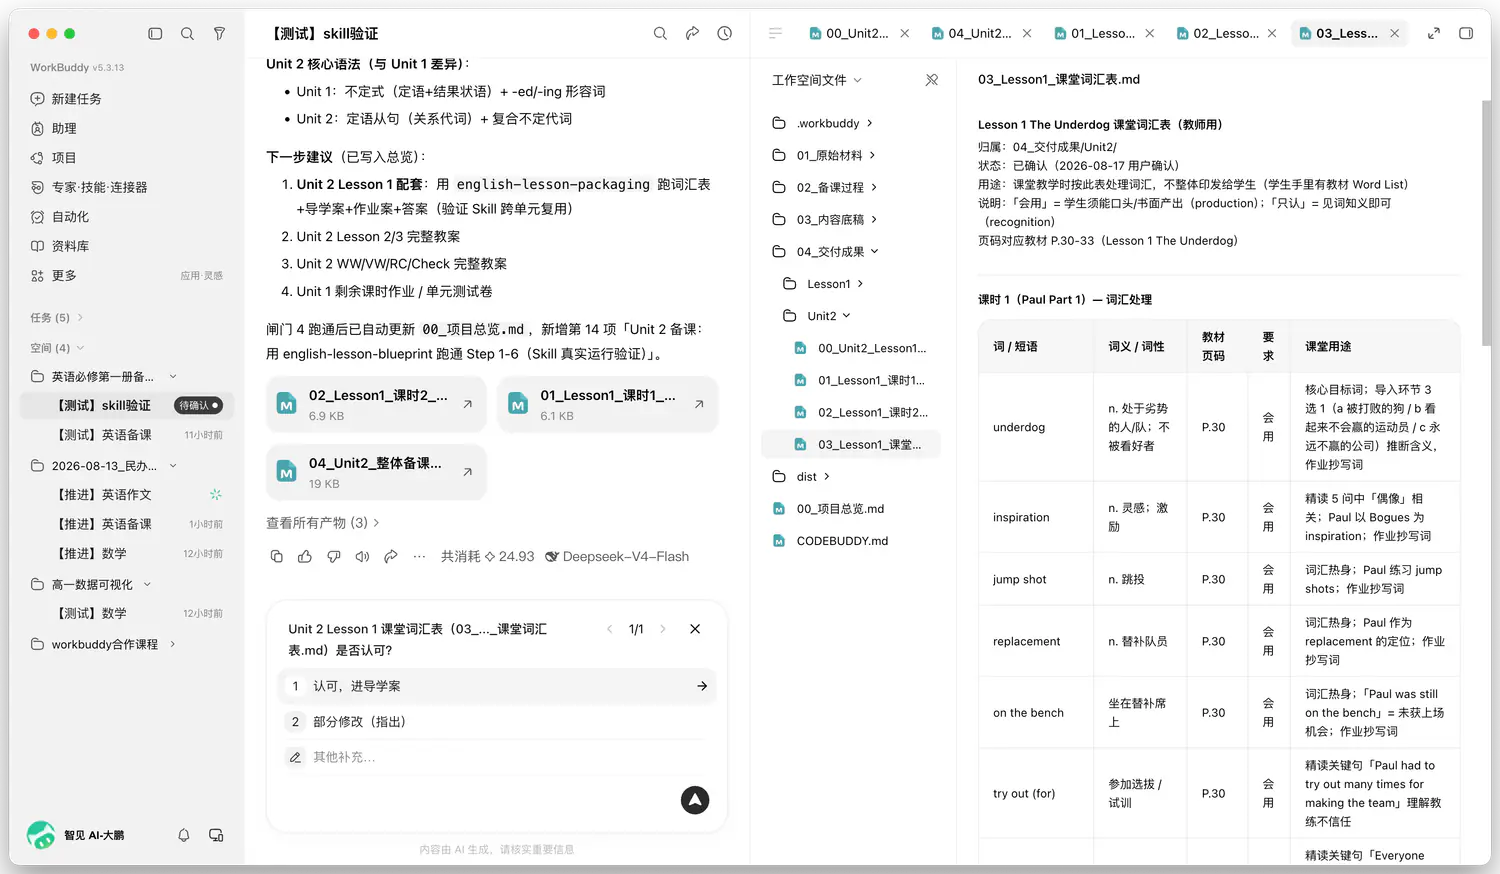
词汇表顺带一提:不从书后附录抄,按教案反推。学生手里有书,词表的价值是告诉老师:这节课哪些词要能用、哪些见着认识就行、分别出现在哪个环节。
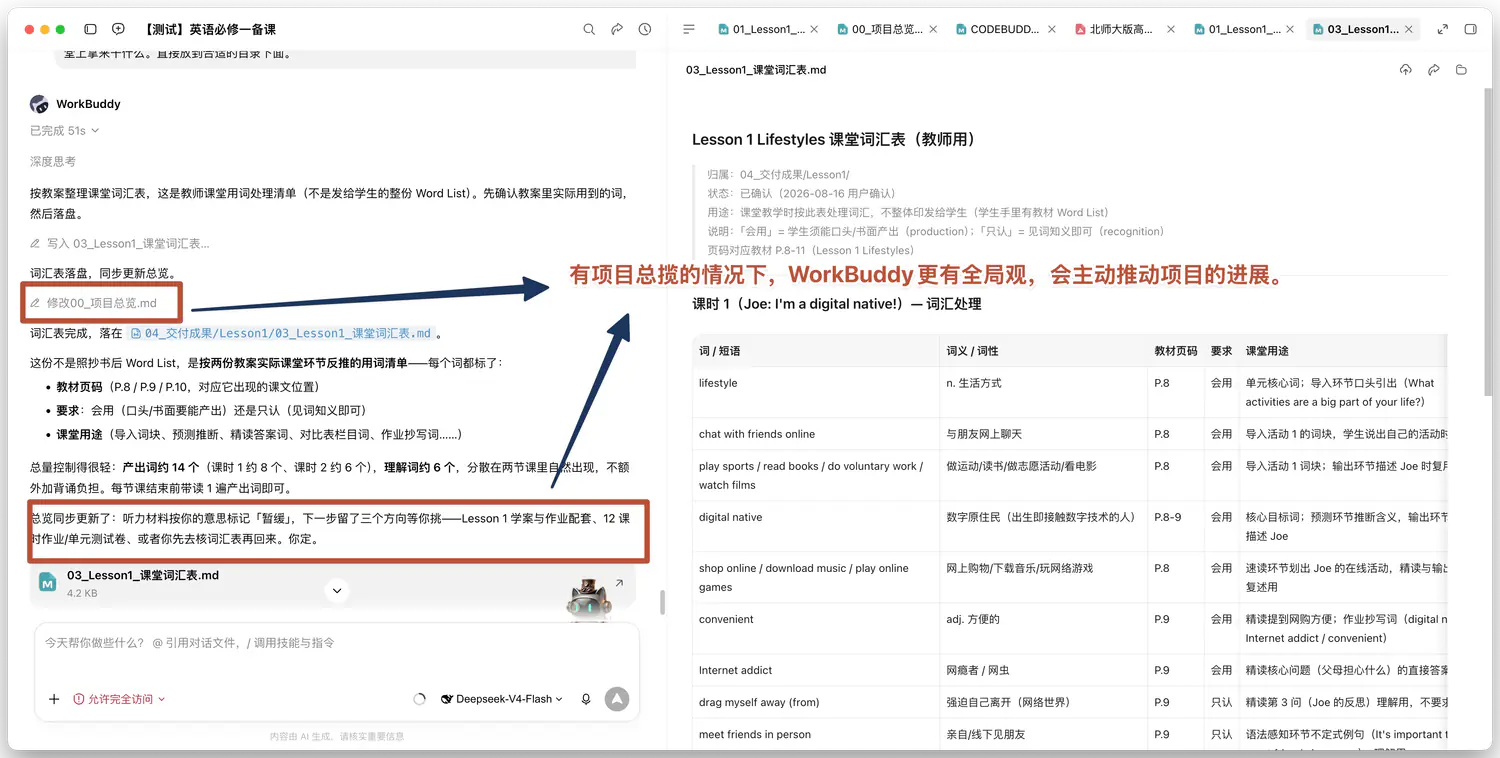
到这里,课前这条线跑通了。从一堆错位材料,到蓝图、教案、词表、师生导学案、作业案,全部落盘。
五、把走通的路收成 Skill
跑通之后,才谈沉淀。
Skill 这个词听着新,我用装桌子打过比方。你买了一套需要组装的桌子:电钻是工具;电钻的使用说明是说明书;而一个木匠装过一百张桌子,他知道怎么装最快最稳——这是做成这件事的最短成功路径。
工具+说明书+最短成功路径,三者打包,就是一个 Skill。别人拿到这个 Skill,等于木匠手把手教过他一遍。
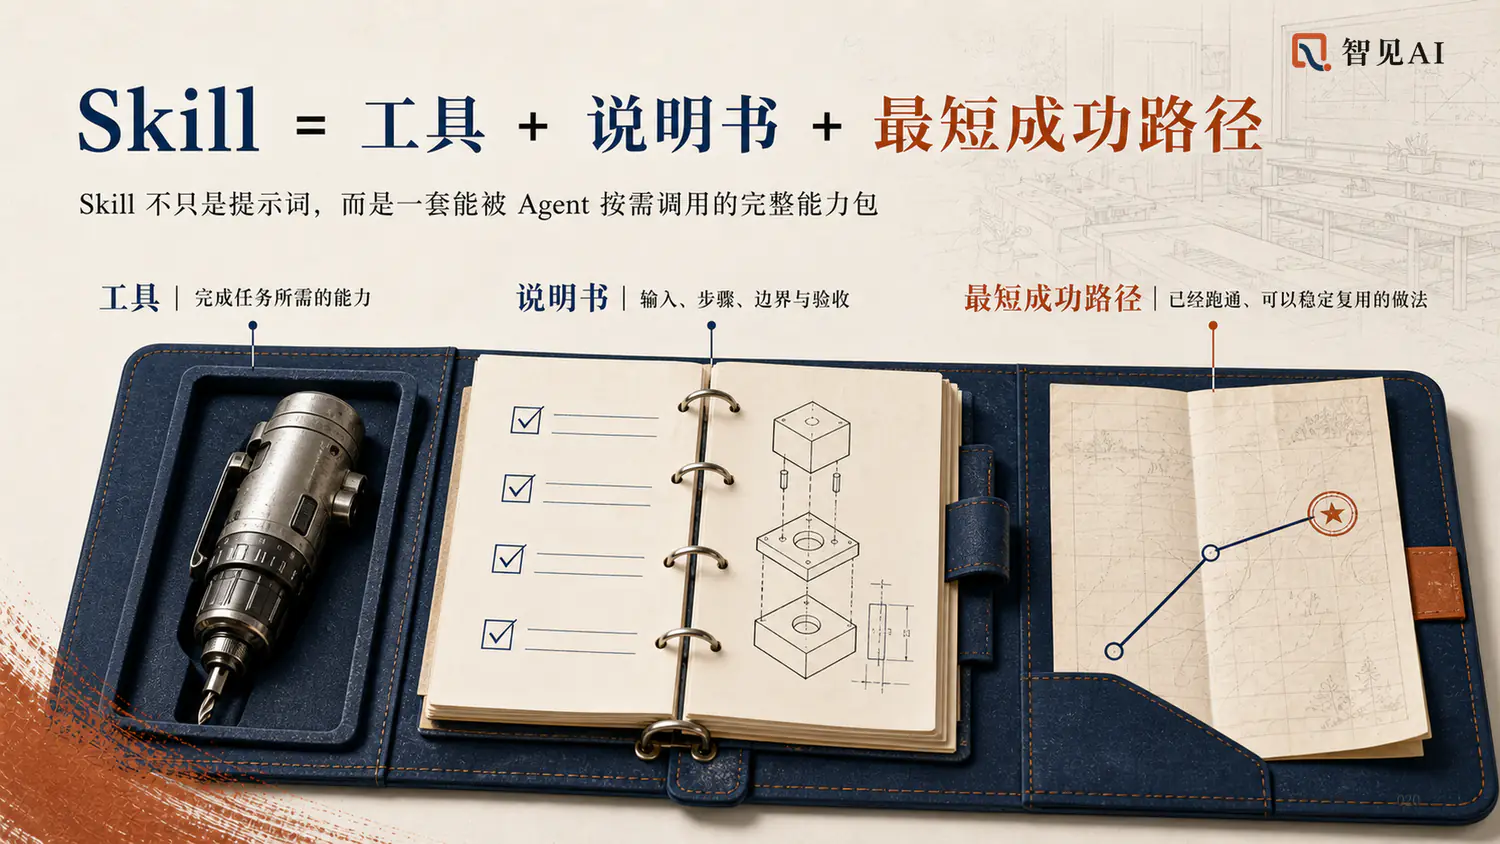
备课流程跑通了,就把它收成两个 Skill:一个管到教案确认——盘点、补料、蓝图、初始化、大纲、完整教案;一个从教案确认后接手——词表、师生导学案、作业案、答案册。
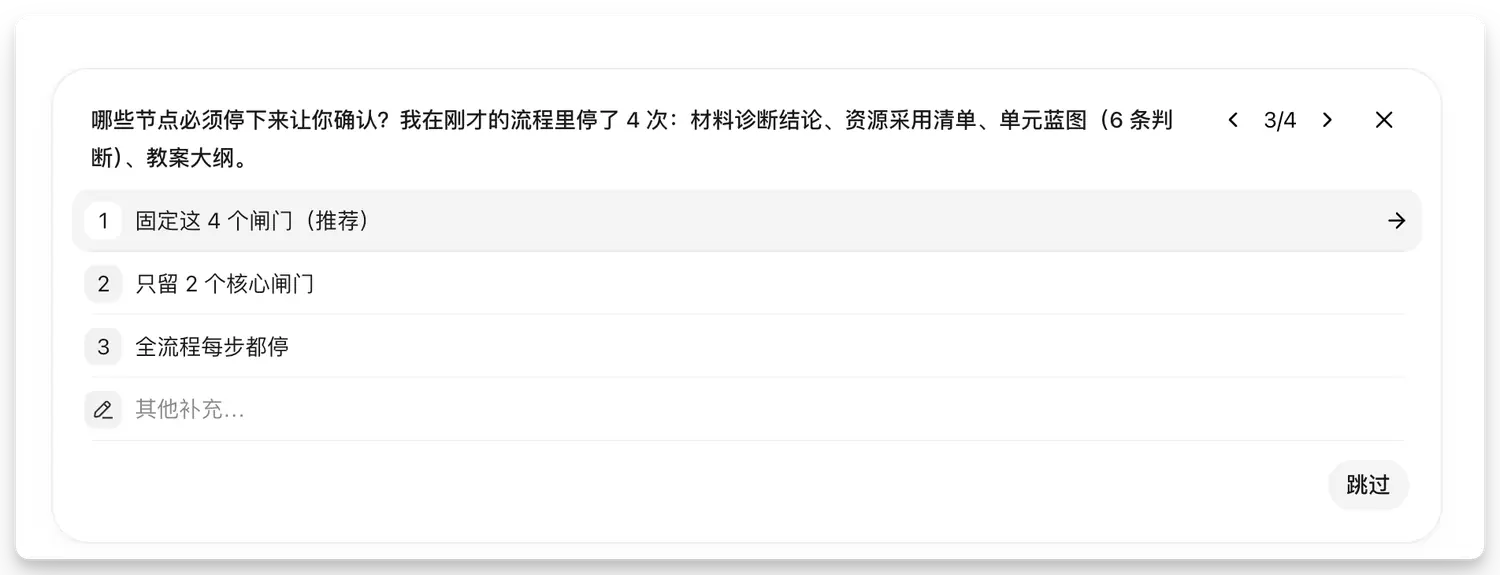
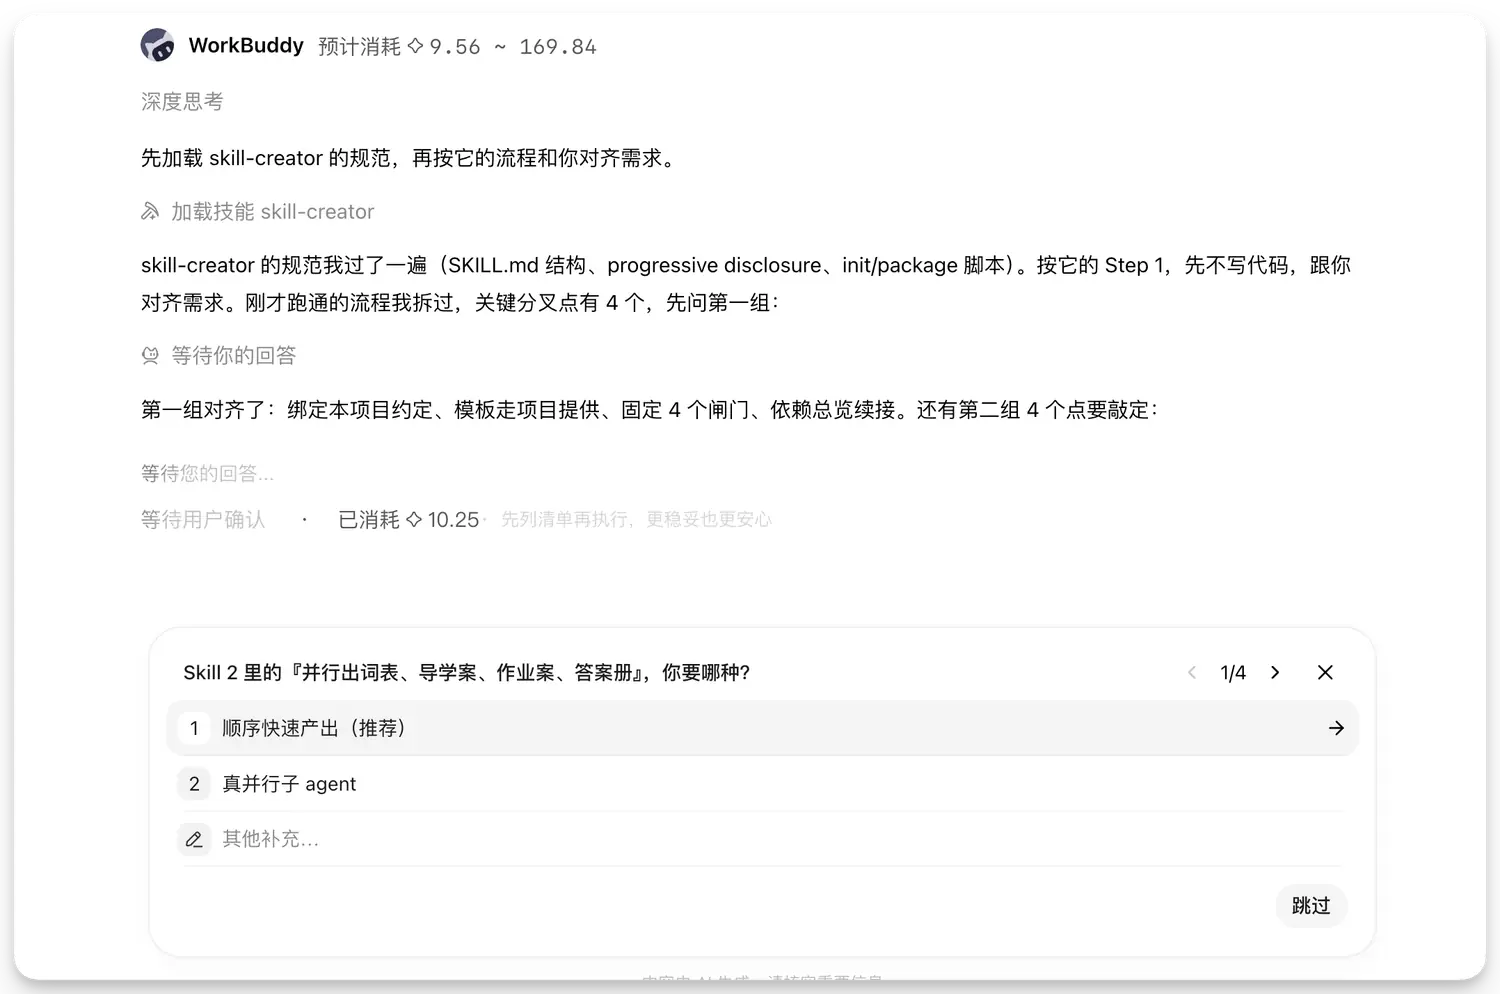
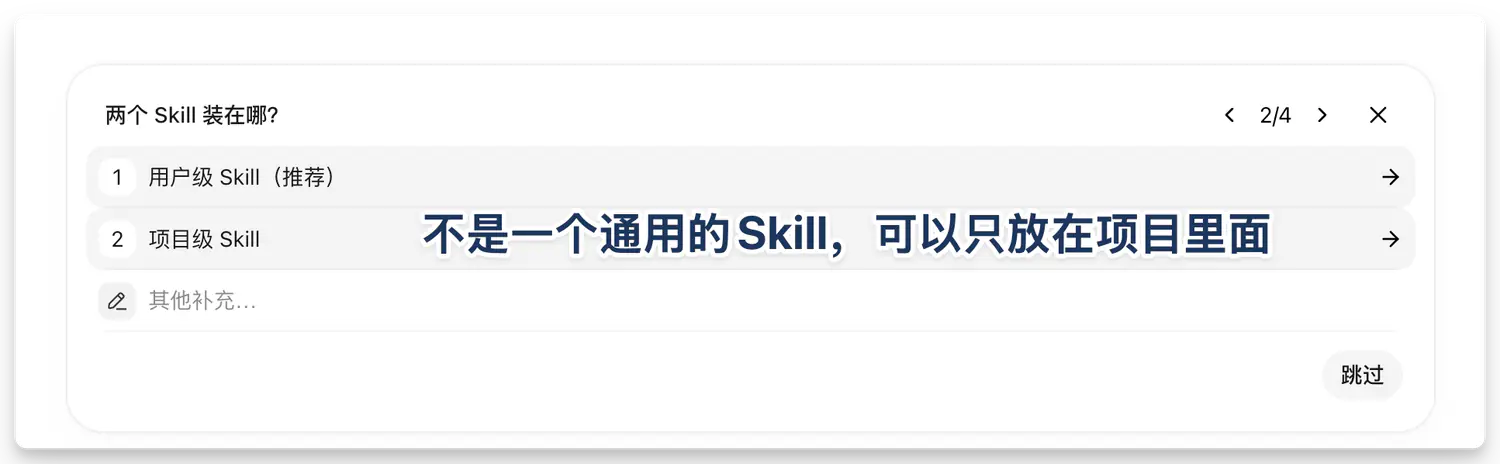
写 Skill 之前,还是那句话:先对齐。它连问了 8 个选择题,其中三个答案有行业纵深。
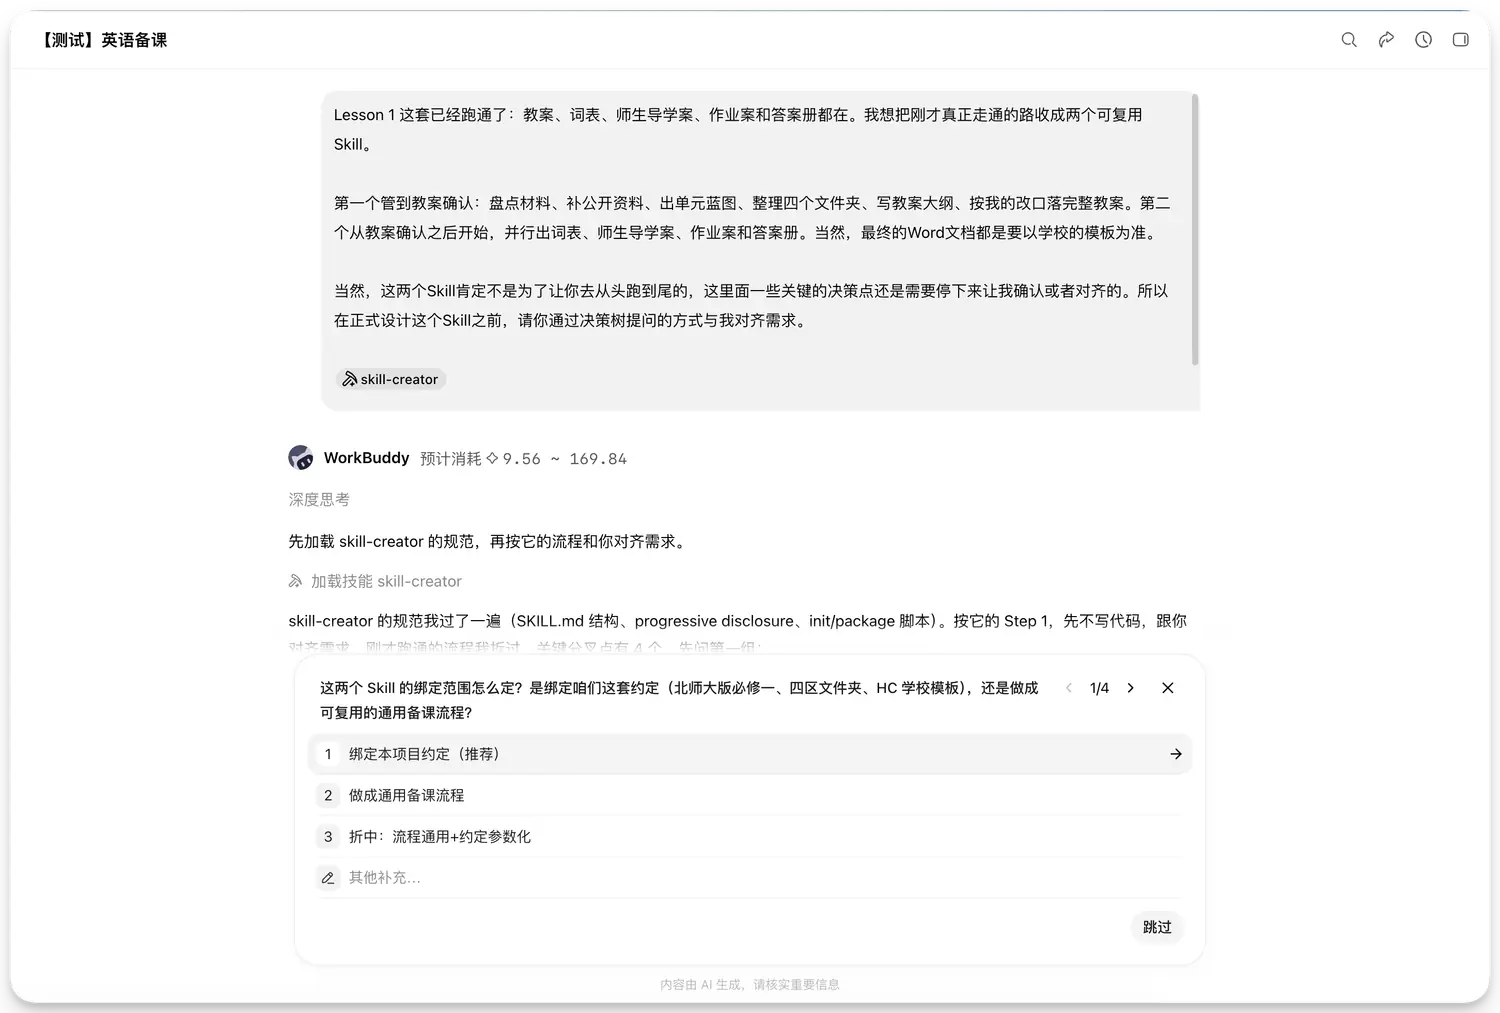
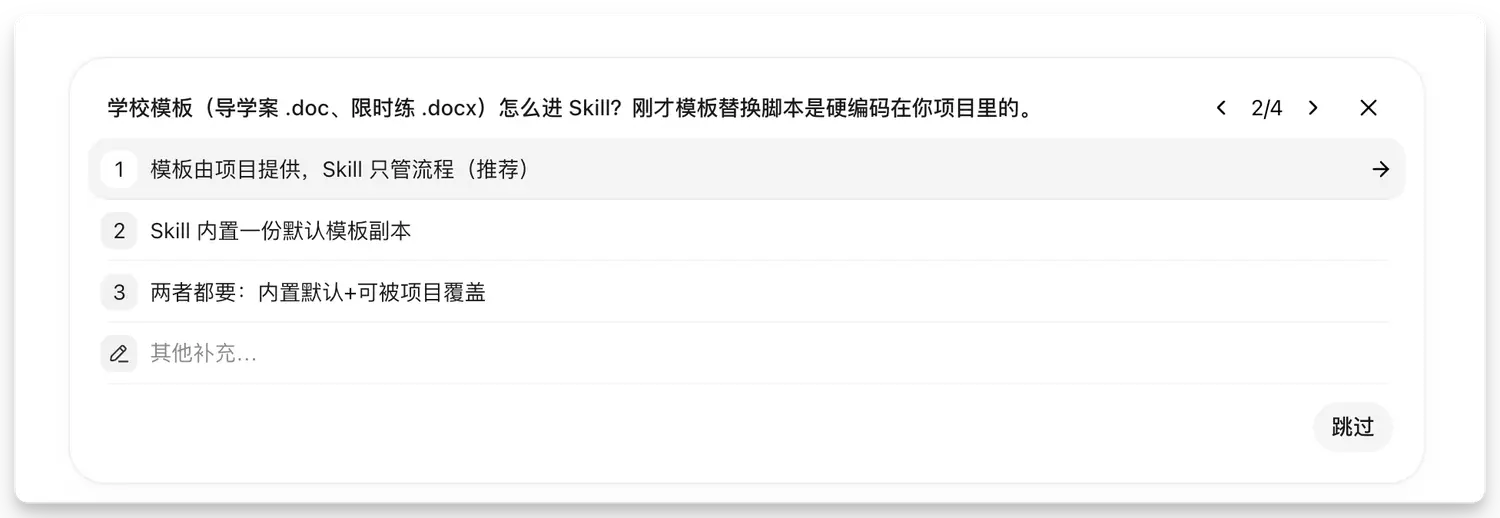
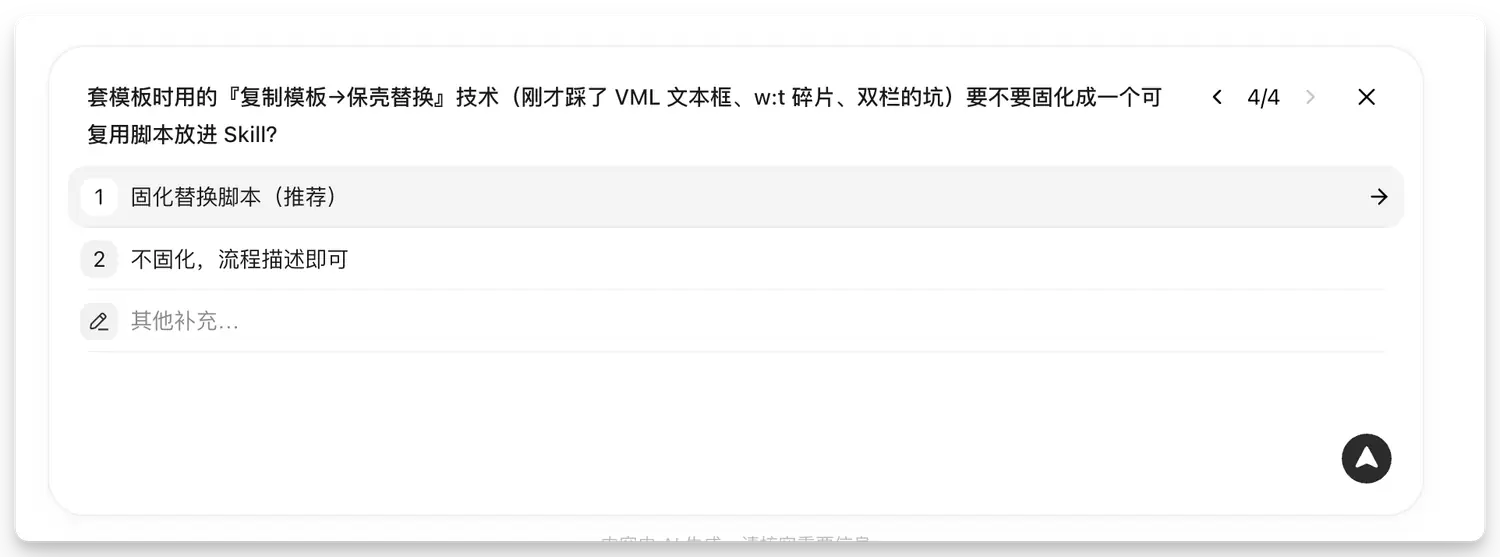
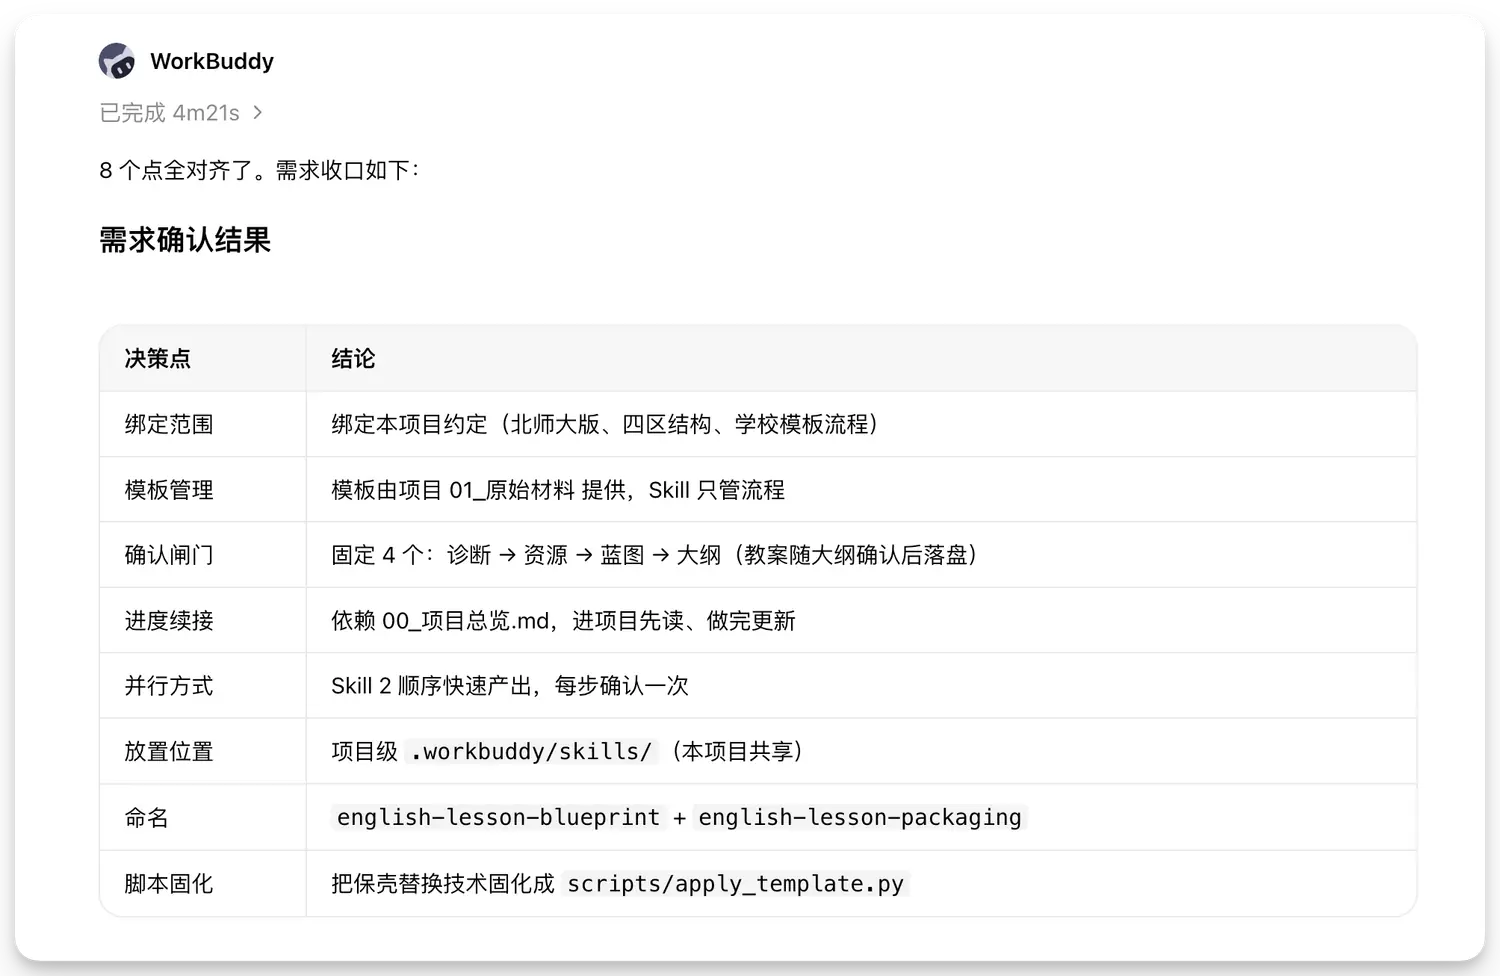
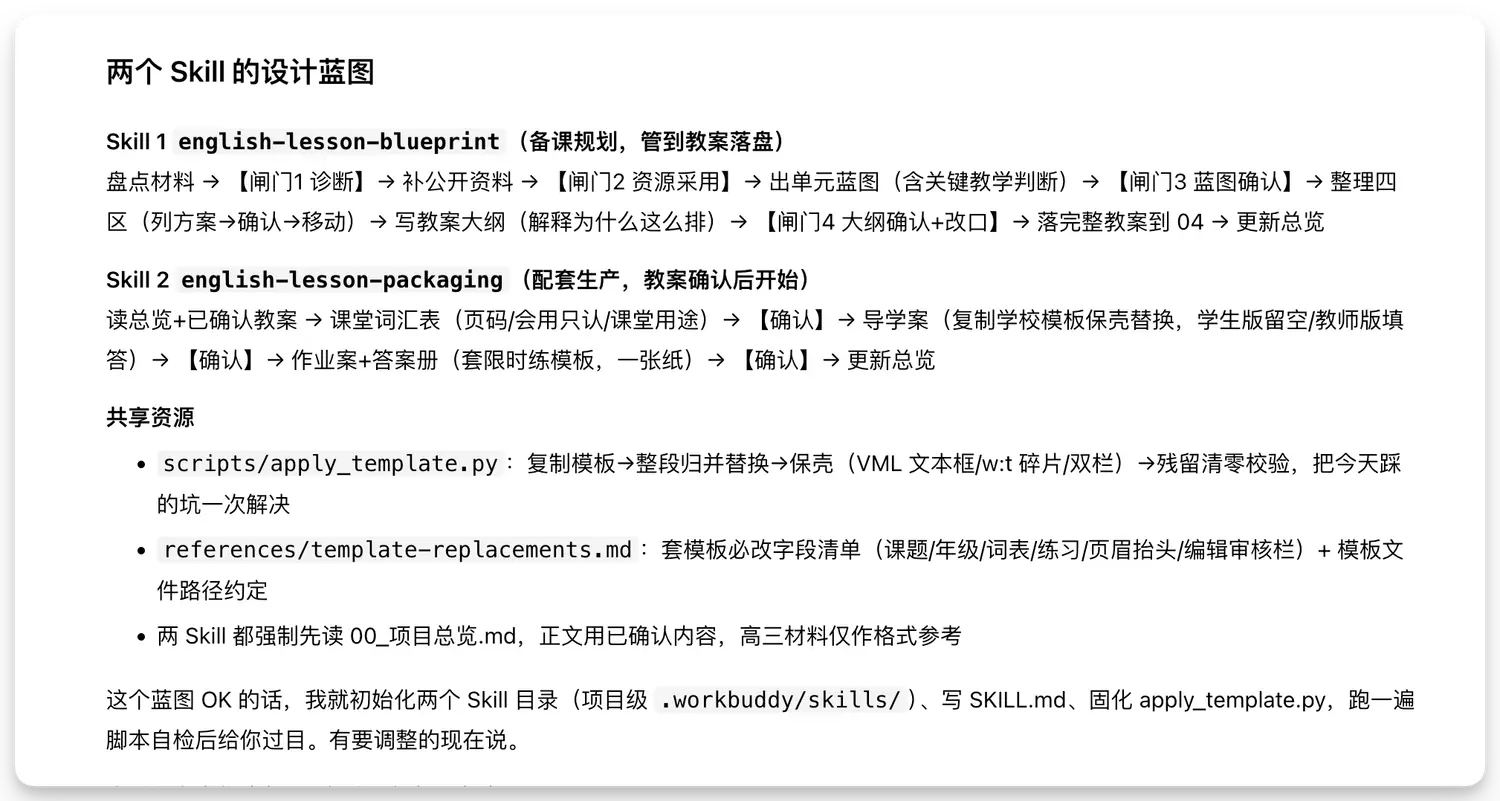
模板塞不塞进 Skill?不塞。学校模板留在项目文件夹里,Skill 只管流程。换一所学校,纸不一样,流程不变。
两个 Skill 并行跑?不并行,改成顺序快速出、每步确认一次。两个 Agent 同时改同一张学校纸,更容易拆壳。
装在哪?项目级。这个 Skill 只服务这个备课夹,不做全国通用的教案机。
Skill 的三种调用方式:输入斜杠搜名字;点加号从技能列表选;或者干脆用自然语言——你只说「帮我备第二单元」,它自动匹配。原理是所有已安装 Skill 的名字和描述,会常驻加载在每次对话的上下文里,模型随时知道自己手上有哪些牌。
Skill 是资产,提示词是消耗品。这句话我讲过很多次,这次是老师们亲手验证它。
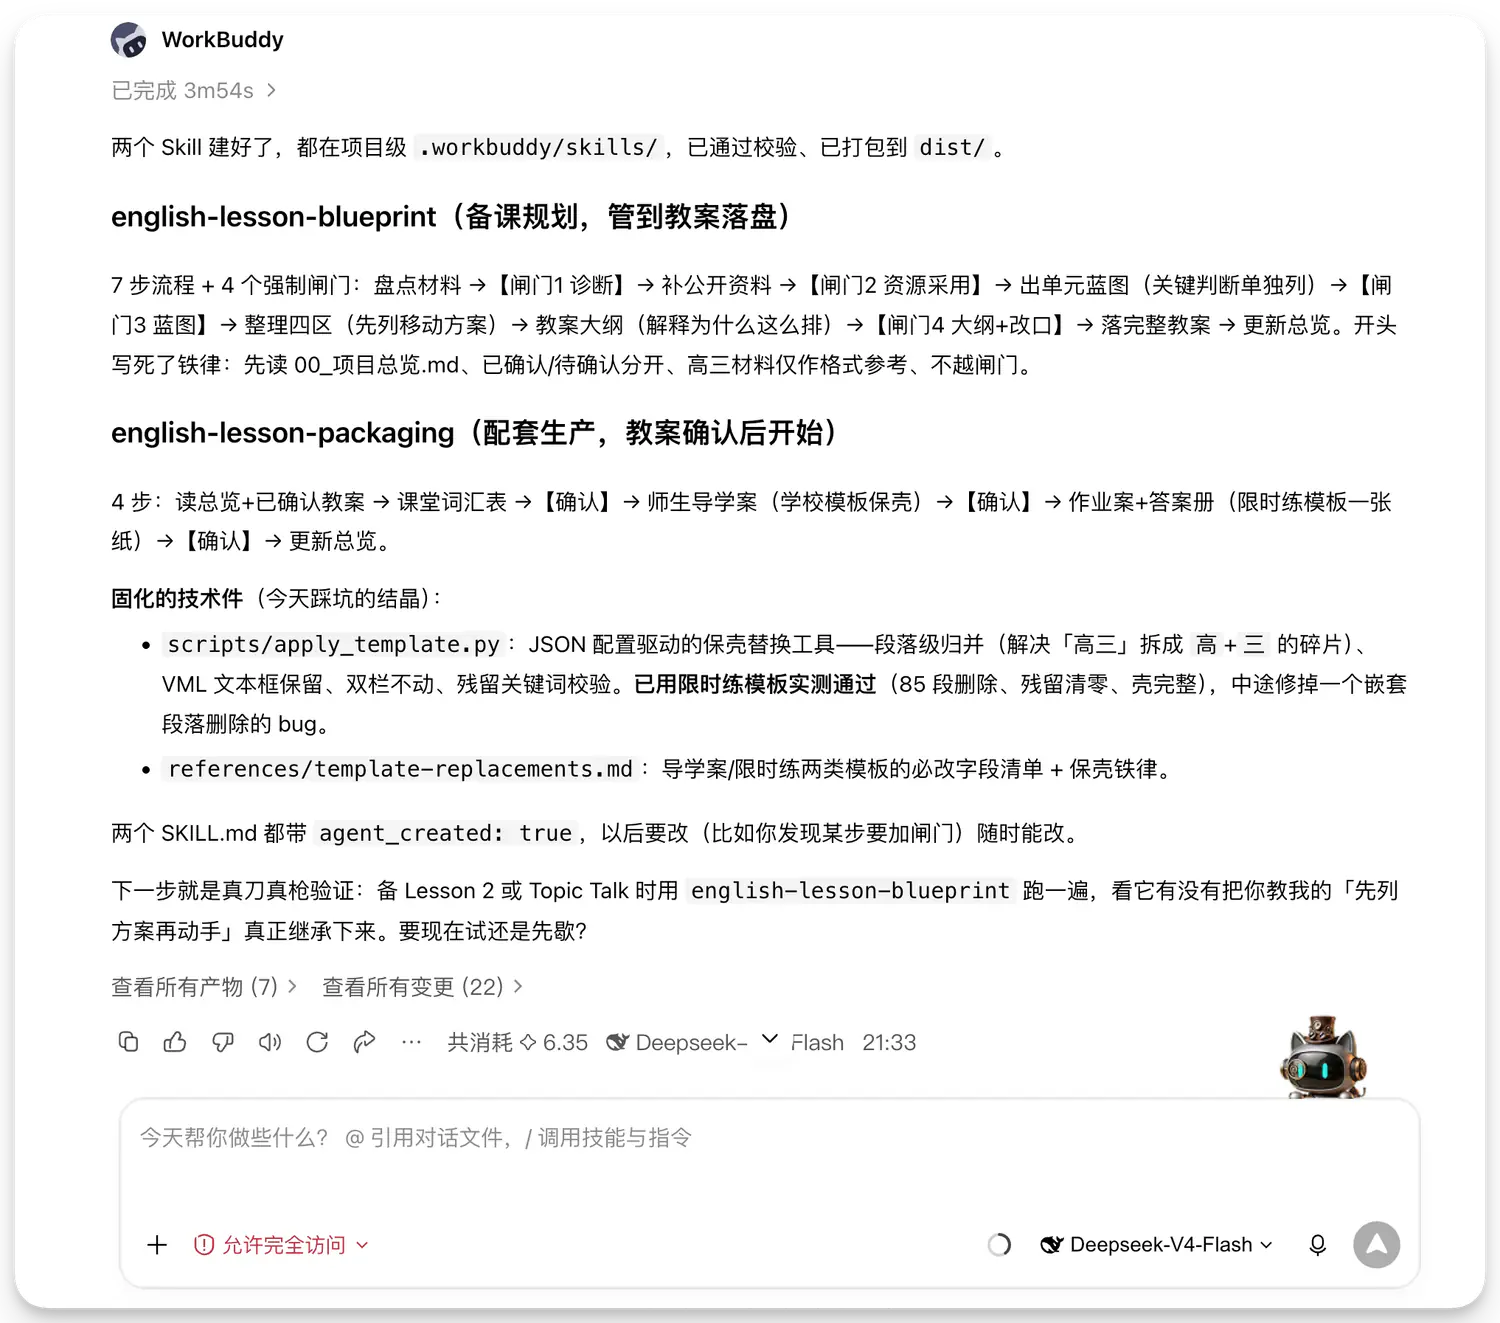
验证的方式很苛刻:换对话,不换文件夹。
还在这个备课项目里,新开一个对话,只打一句「帮我备课 Unit 2」。旧聊天一点带不过去,项目级 Skill、四区目录、项目总览全在。
结果:4 个闸门照停,材料诊断、资料采用、蓝图判断、教案大纲,全都停下来等人点头;产出的是 Paul 和 The Underdog、定语从句,第一单元的 digital native 一个词都没跟过来。
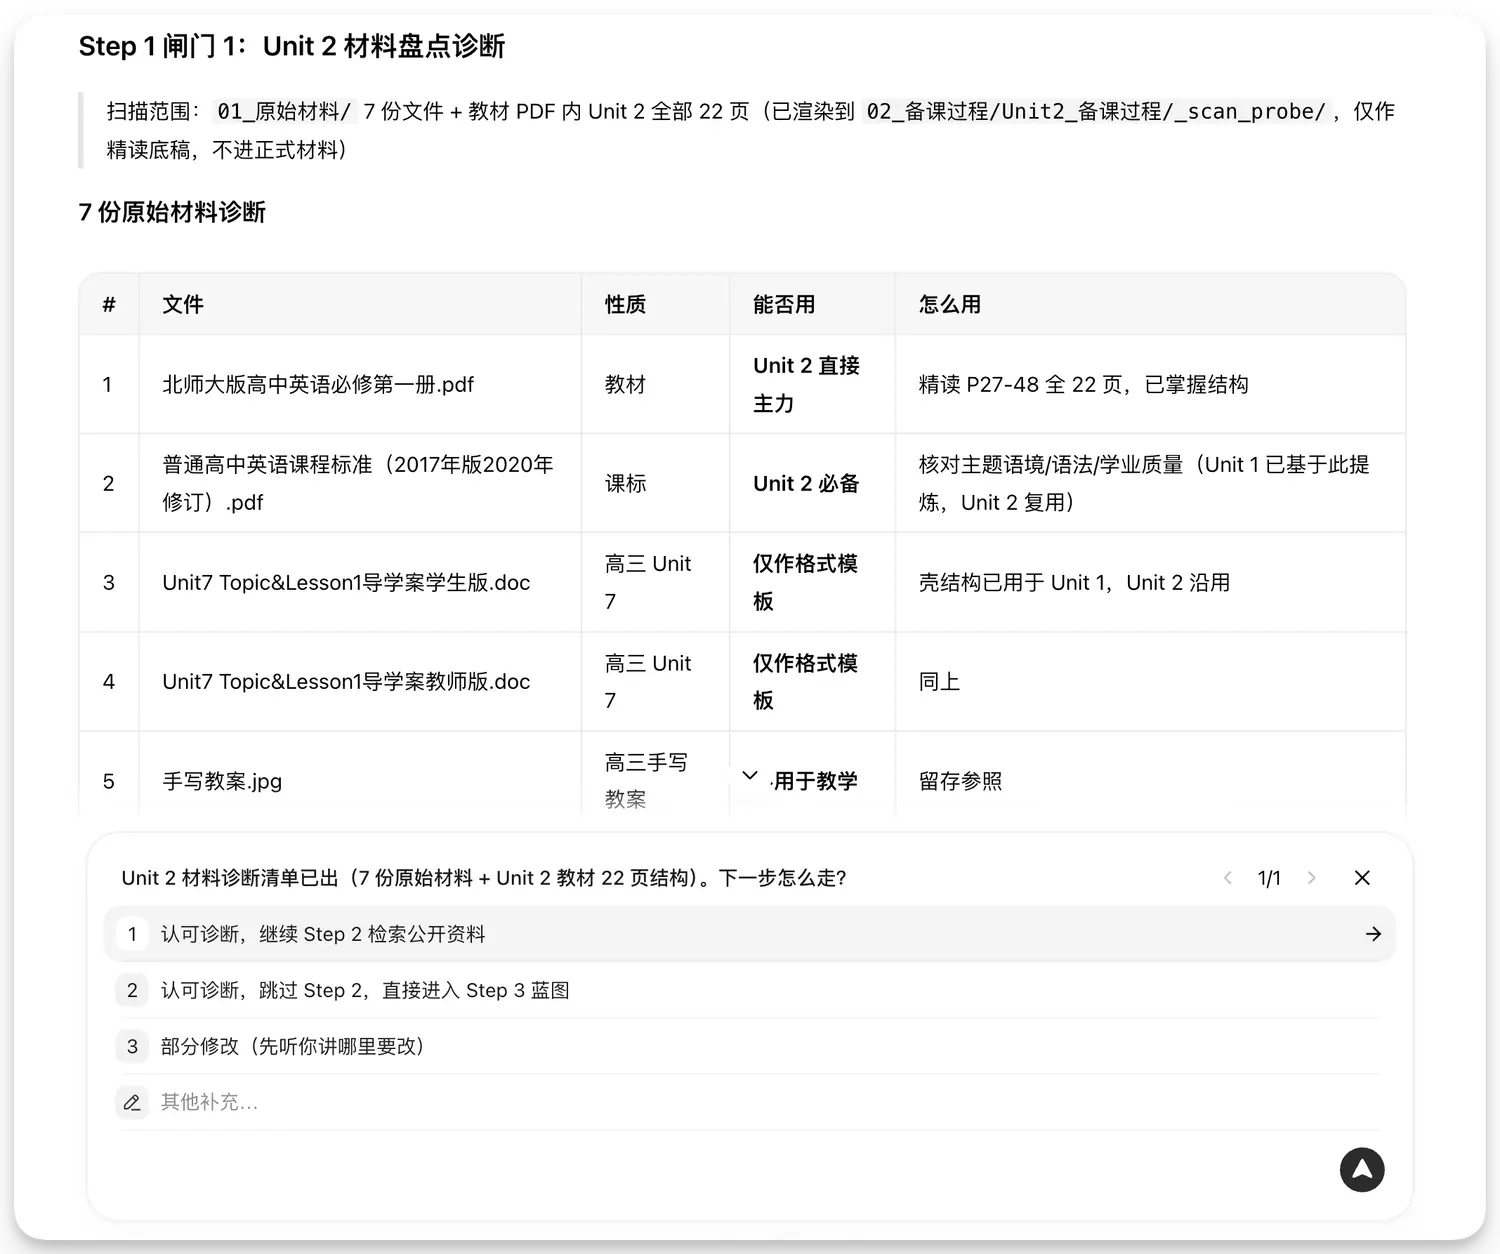
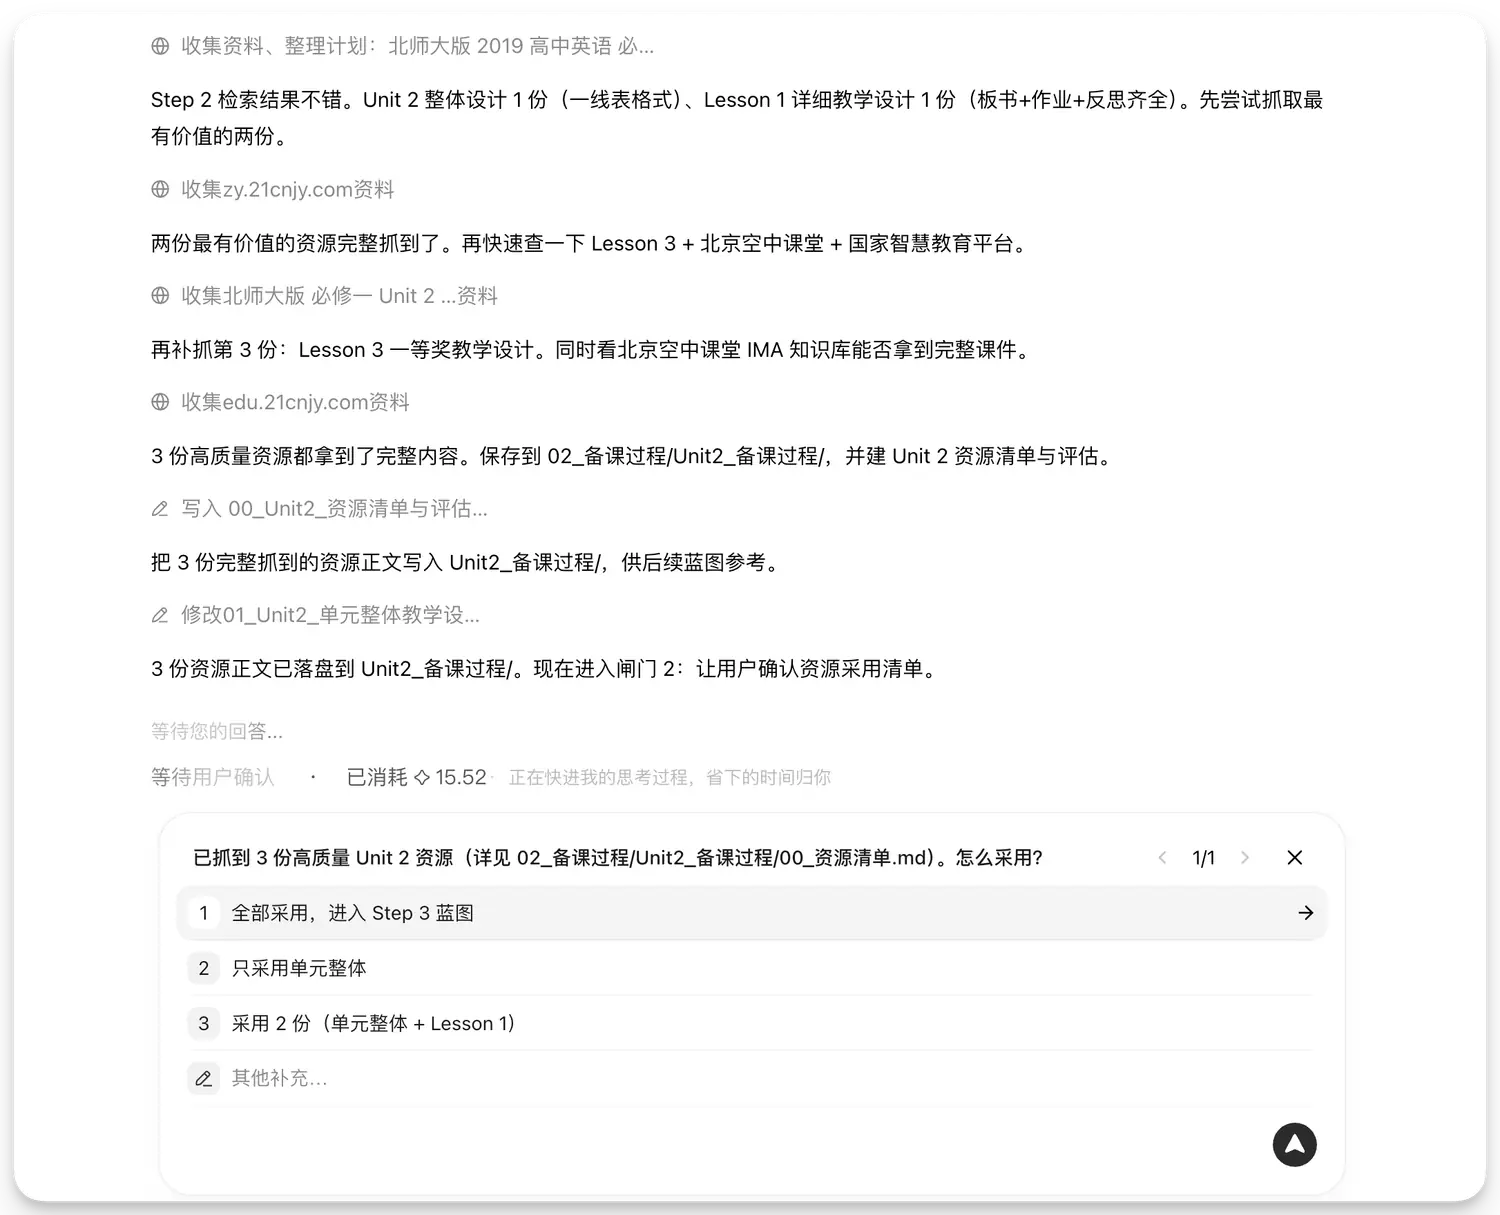
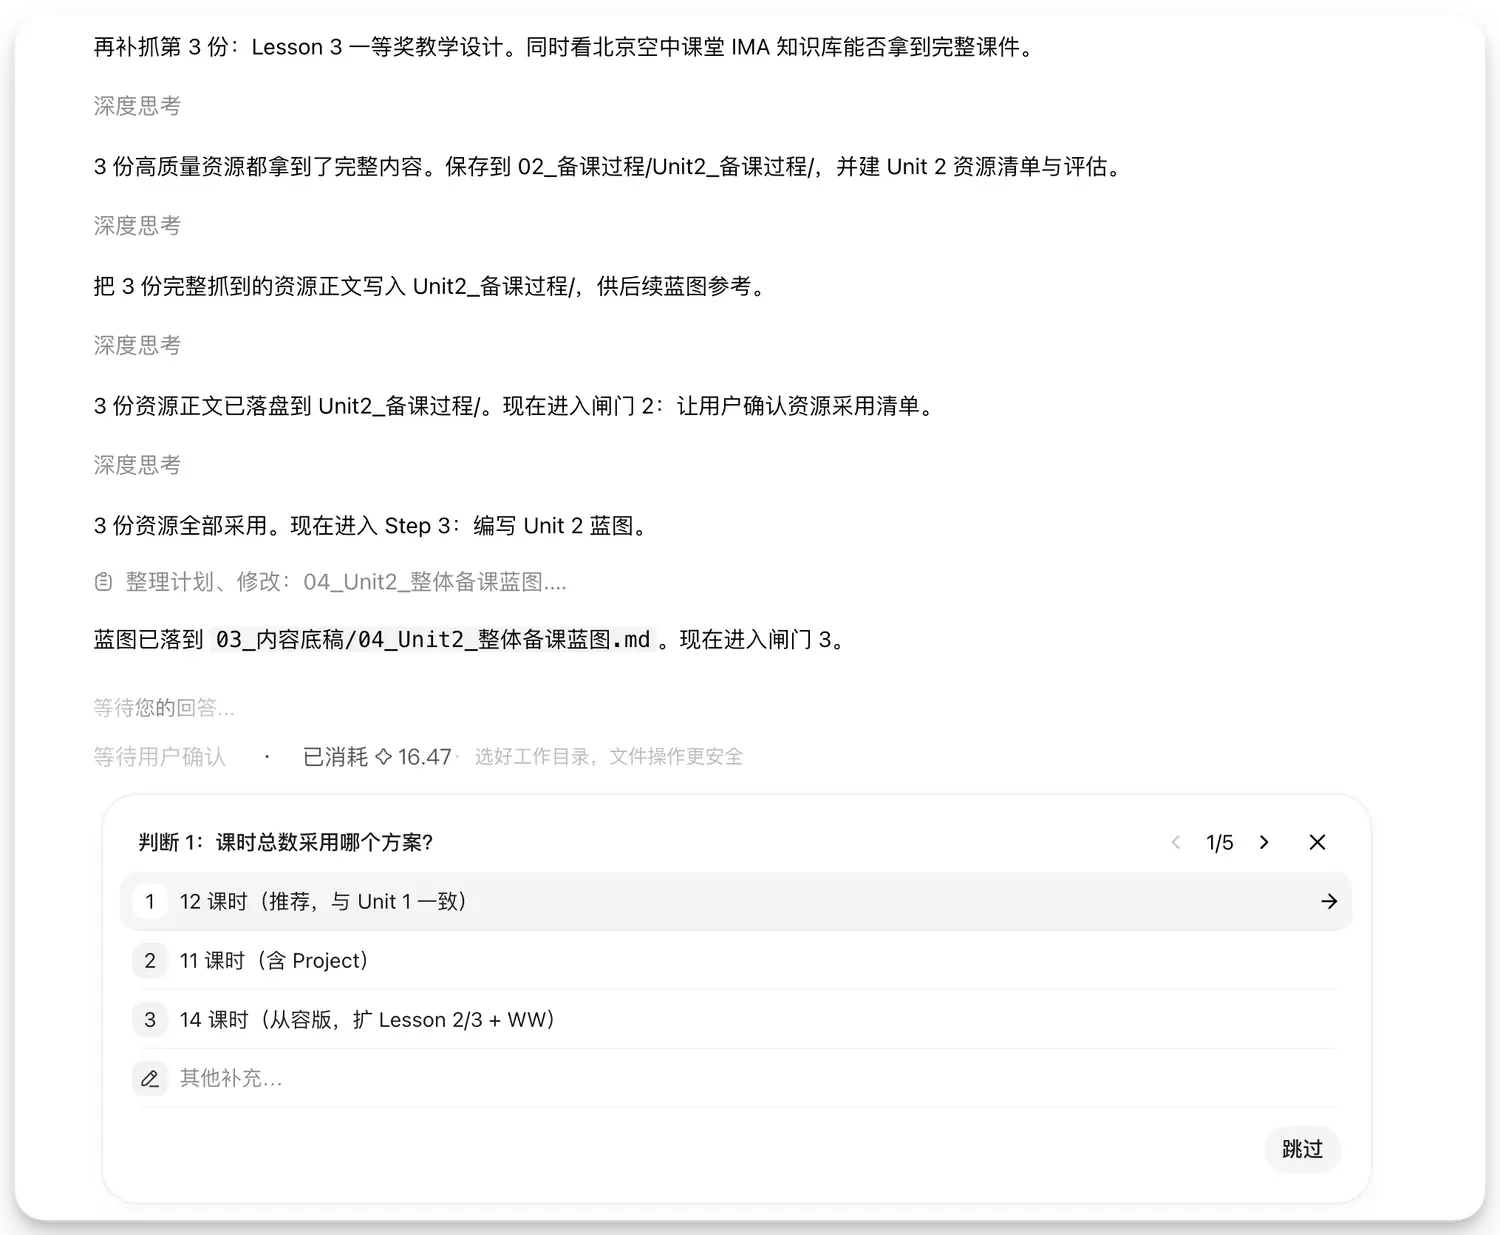
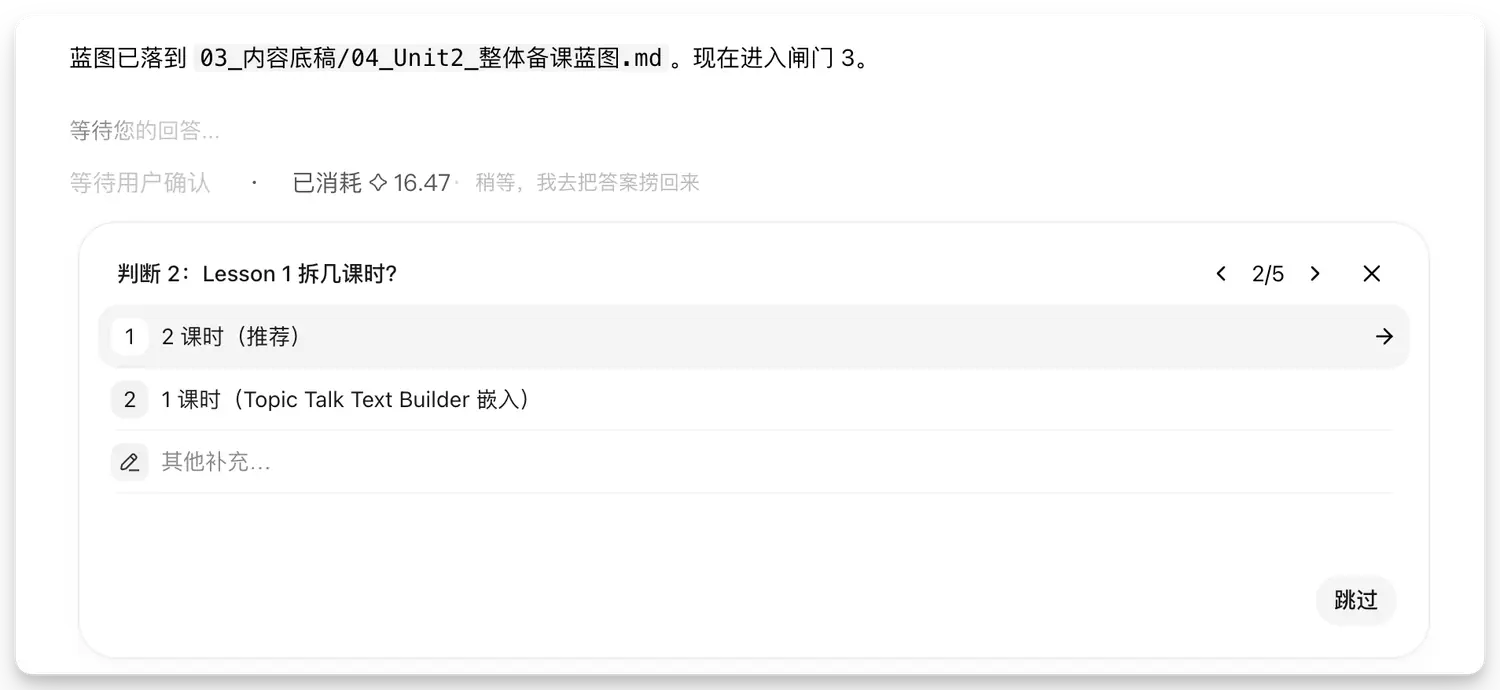
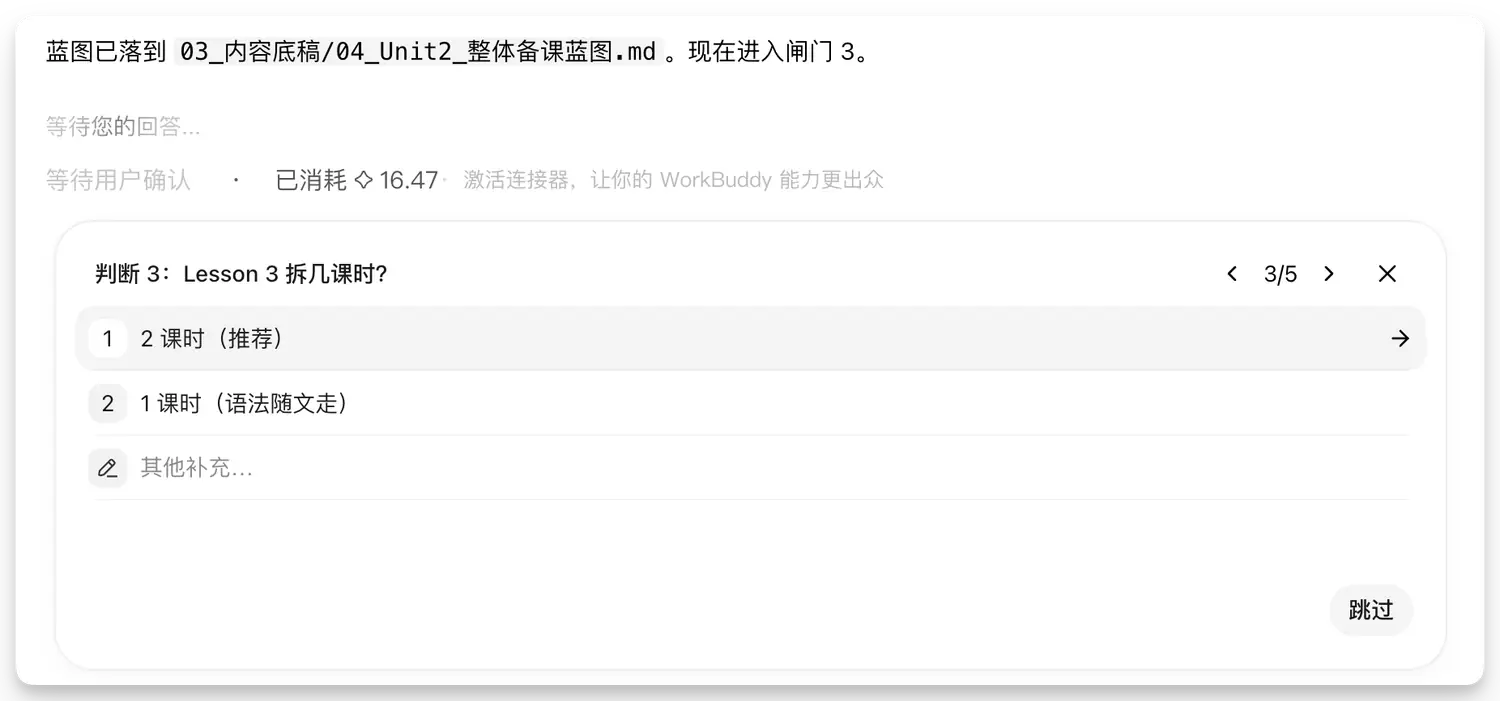
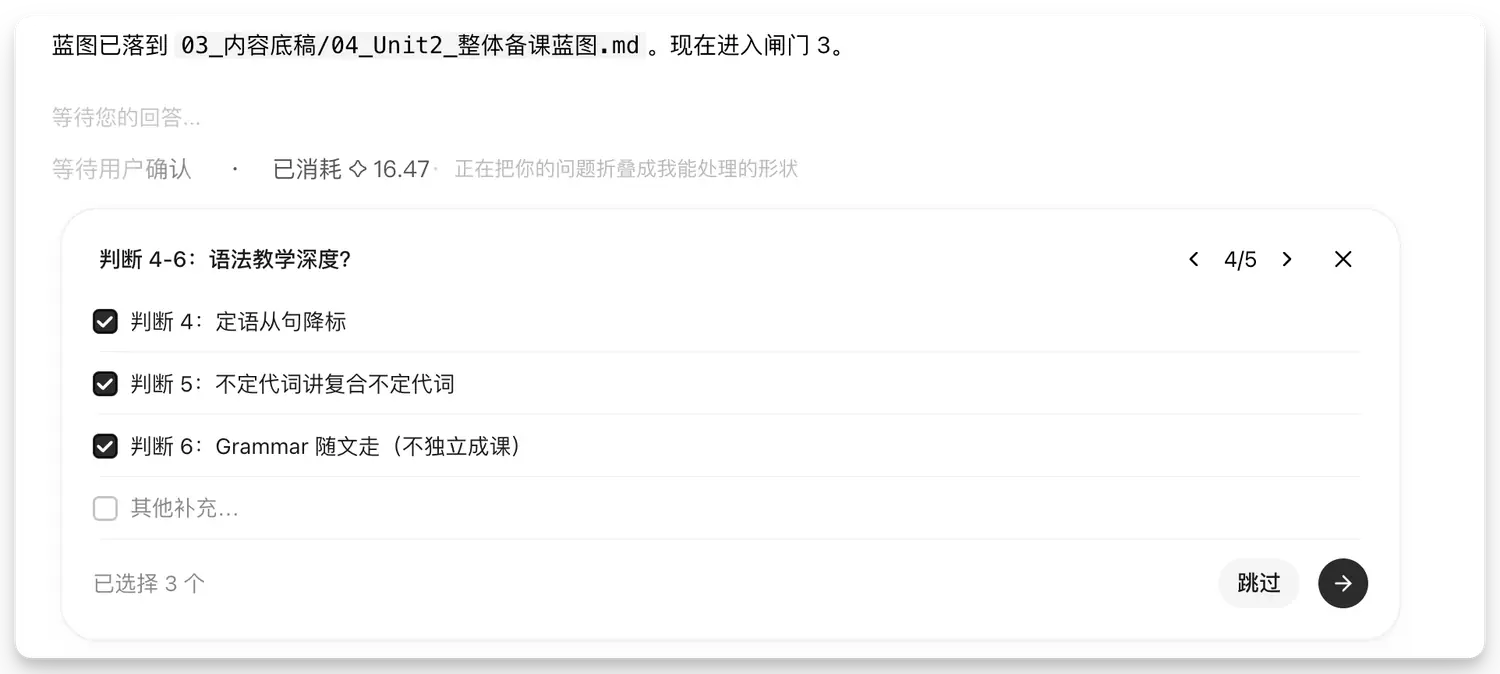
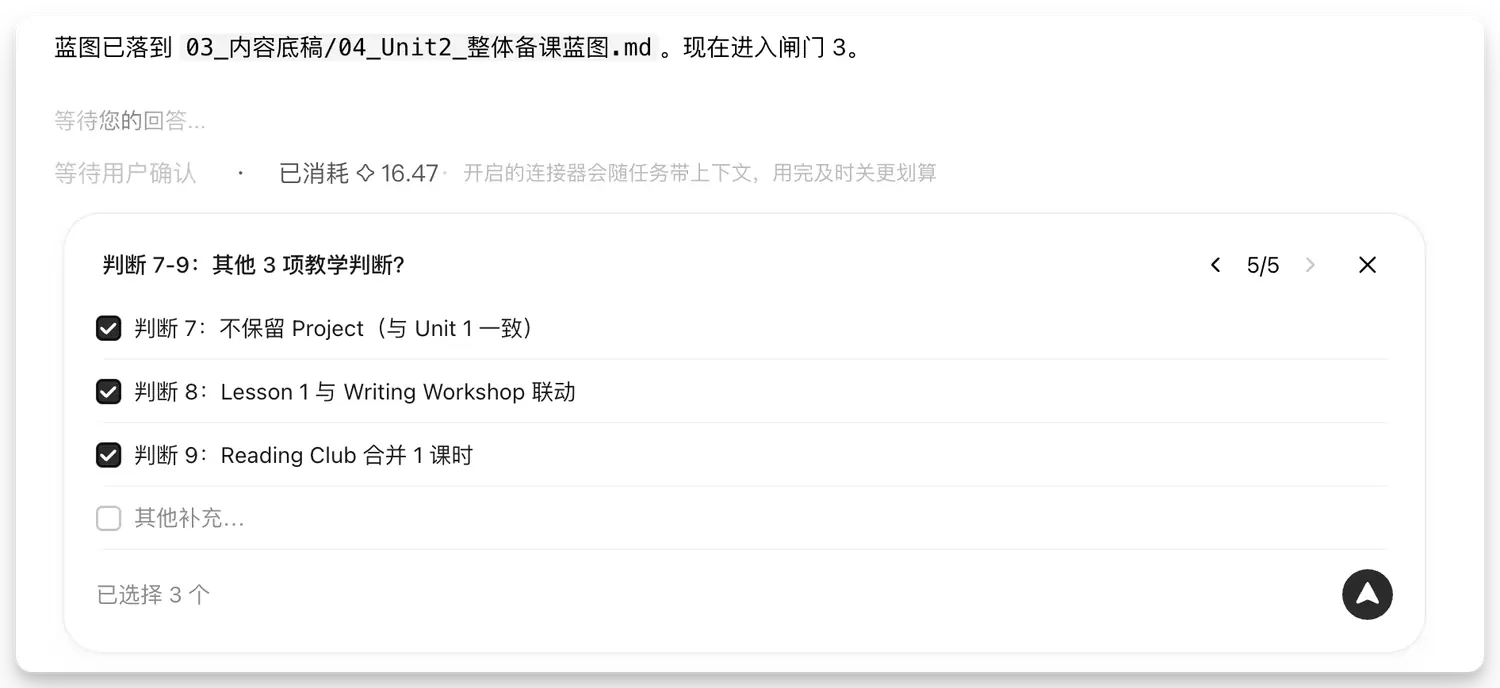
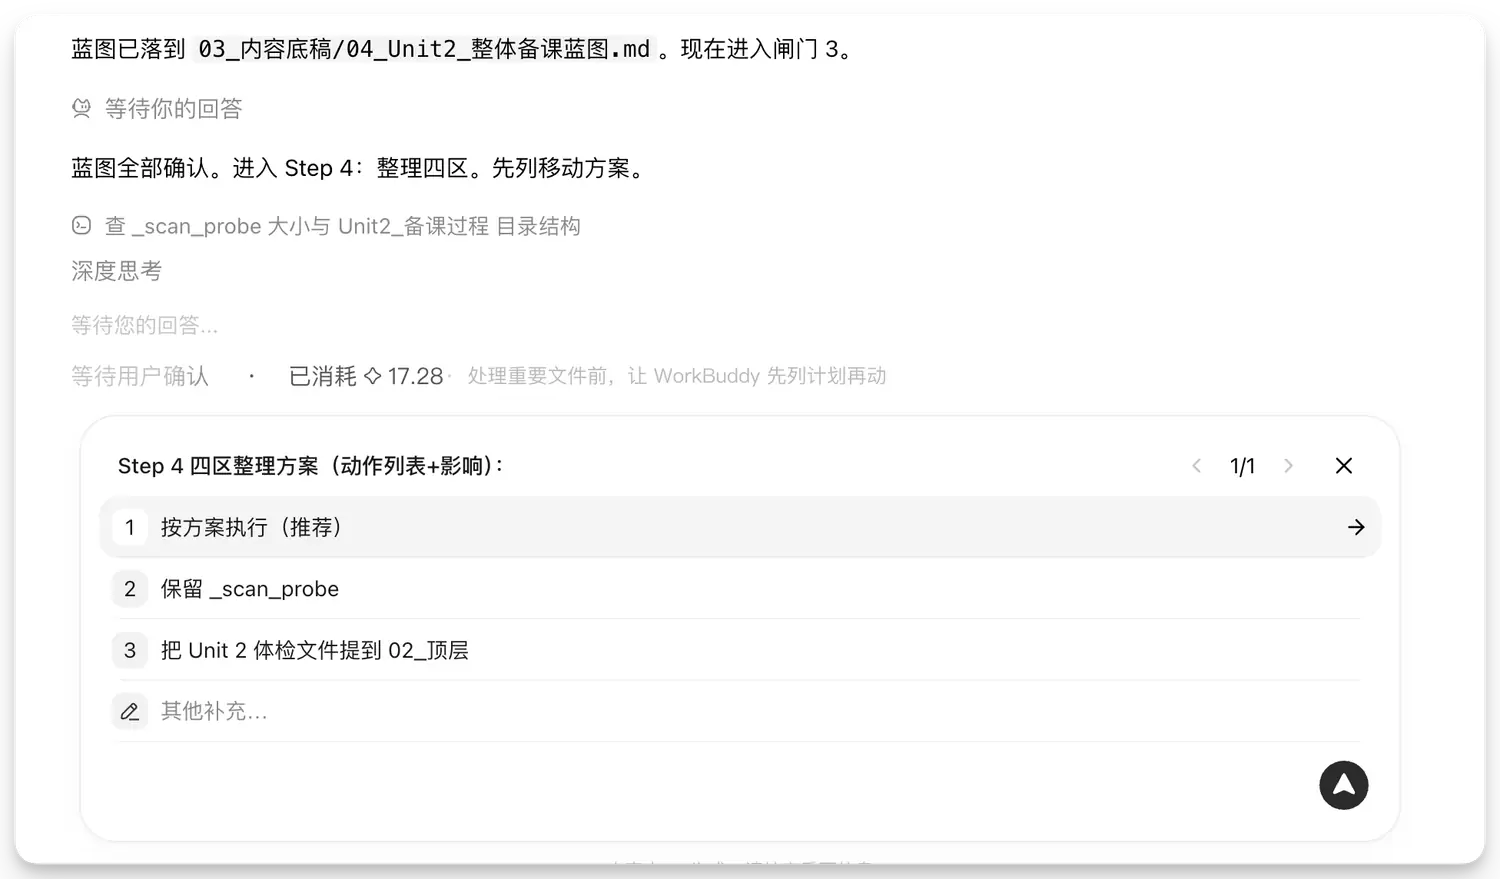
方法迁移了,内容没迁移。这才是 Skill 沉淀成立的证据。
那天下午最让我高兴的不是演示跑通,是讨论环节老师们的输出。有老师想把某位出题专家历年的题全喂进去,让 AI 分析他的出题习惯。
有老师想解决临界生问题——那个差 15 分上本科线的学生,分数该投在哪一科,数据能给出人凭感觉给不出的答案。有老师想做错题变式训练,一次考试照片进来,同类题出去。出题、成绩分析、错题,每个学科组都有自己的想法。
工具所有人都一样,场景是自己的。老师们开始想自己的场景了,这场培训就成了一半。
六、数学老师的函数实验室
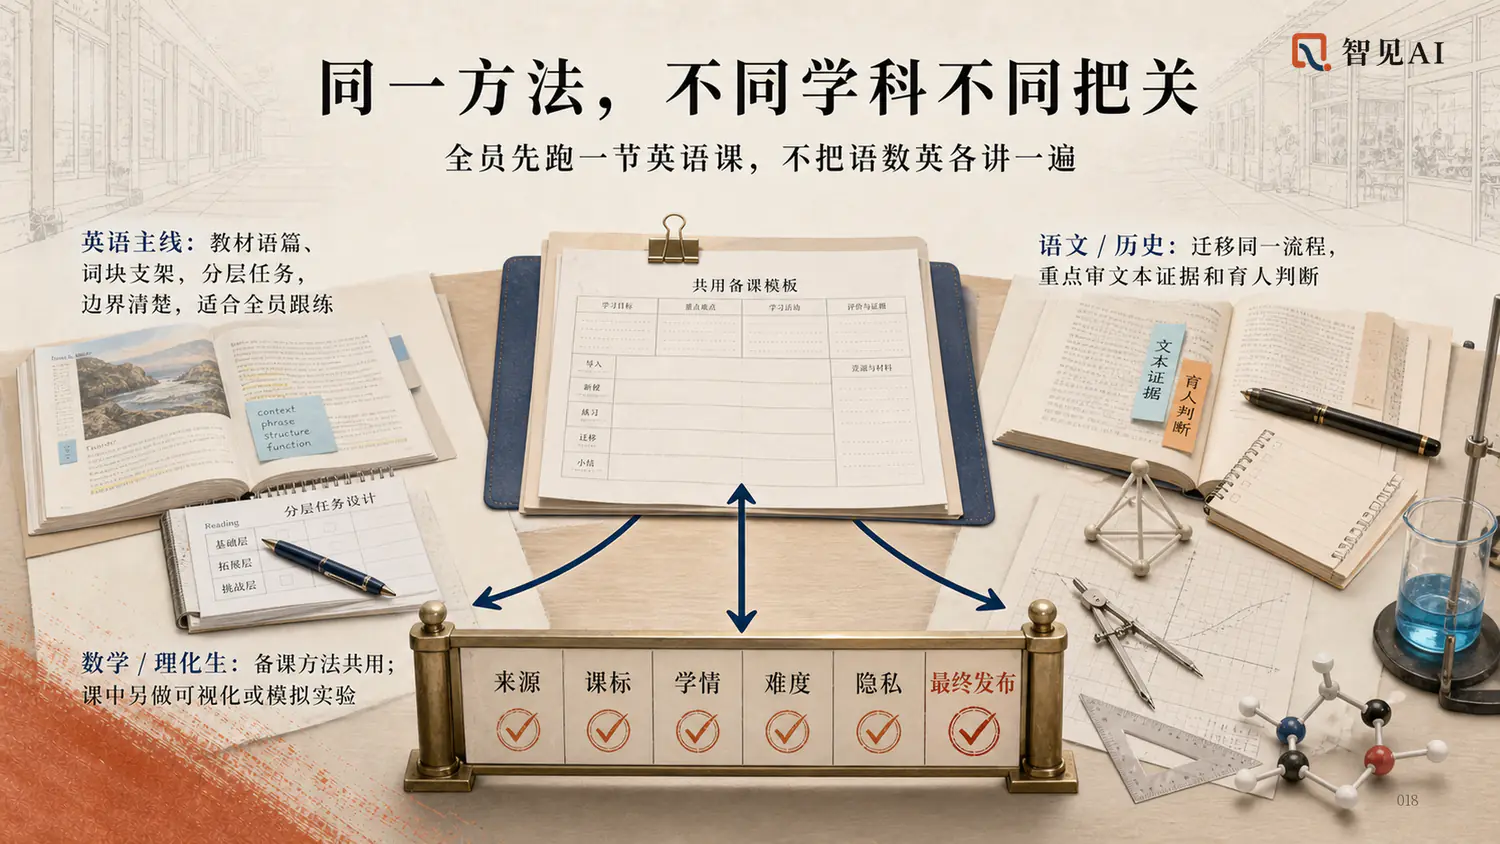
英语是文科代表。理科老师会问:我们呢?
下午我现场跑了一个数学案例,痛点来自一句大白话:课堂上图是死的。参数变了,学生看不见图怎么变,规律只能靠老师嘴讲。
还是同一套 SGP。数学老师说四段话:我是高一数学老师,讲人教 A 版必修一,函数是主线;课堂上图是死的,参数变了,学生看不见图怎么变,规律只能靠老师嘴讲。
我想做一个能投大屏、下周就能用的交互网页,不是函数大全,是一个按课切换的实验室——开场课左边单位圆转、右边同步画正弦,能拖振幅周期相位;再用一条图对照指对幂的增长;另两个课讲根与解集、二分法逼近。在正式写代码之前,请通过提问的方式与我对齐需求。
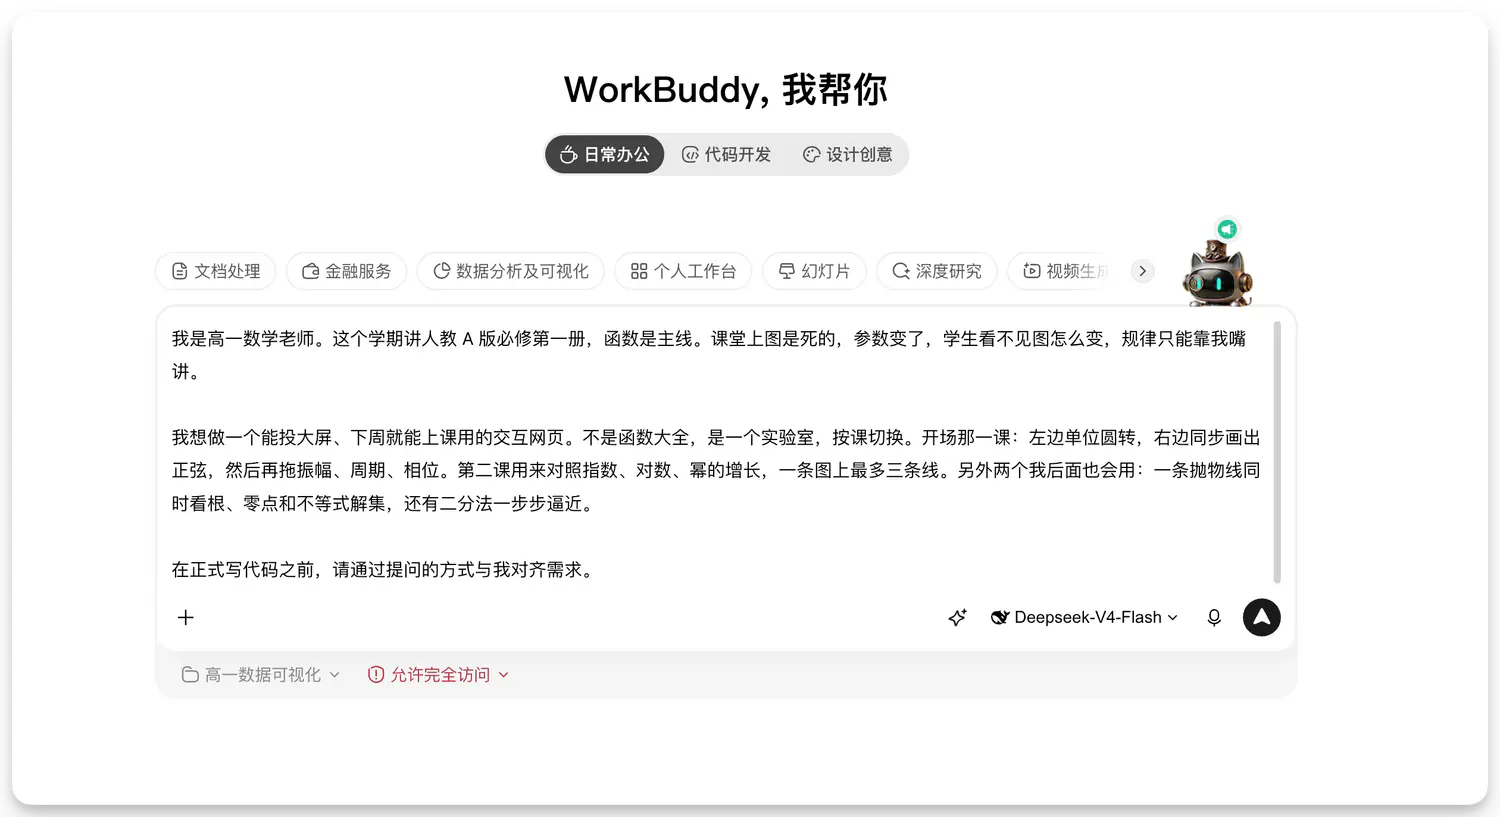
它没写代码,先复述理解,再弹选择题。
两轮点完——单文件、四个实验室全做、弧度角度双显示、自动转加滑块、三参数可拖、深色底——它才第一次拿出规格表。开场四段话里没有「零外部依赖」「Δ 预设」这些词,它们全部出现在点完两轮之后。
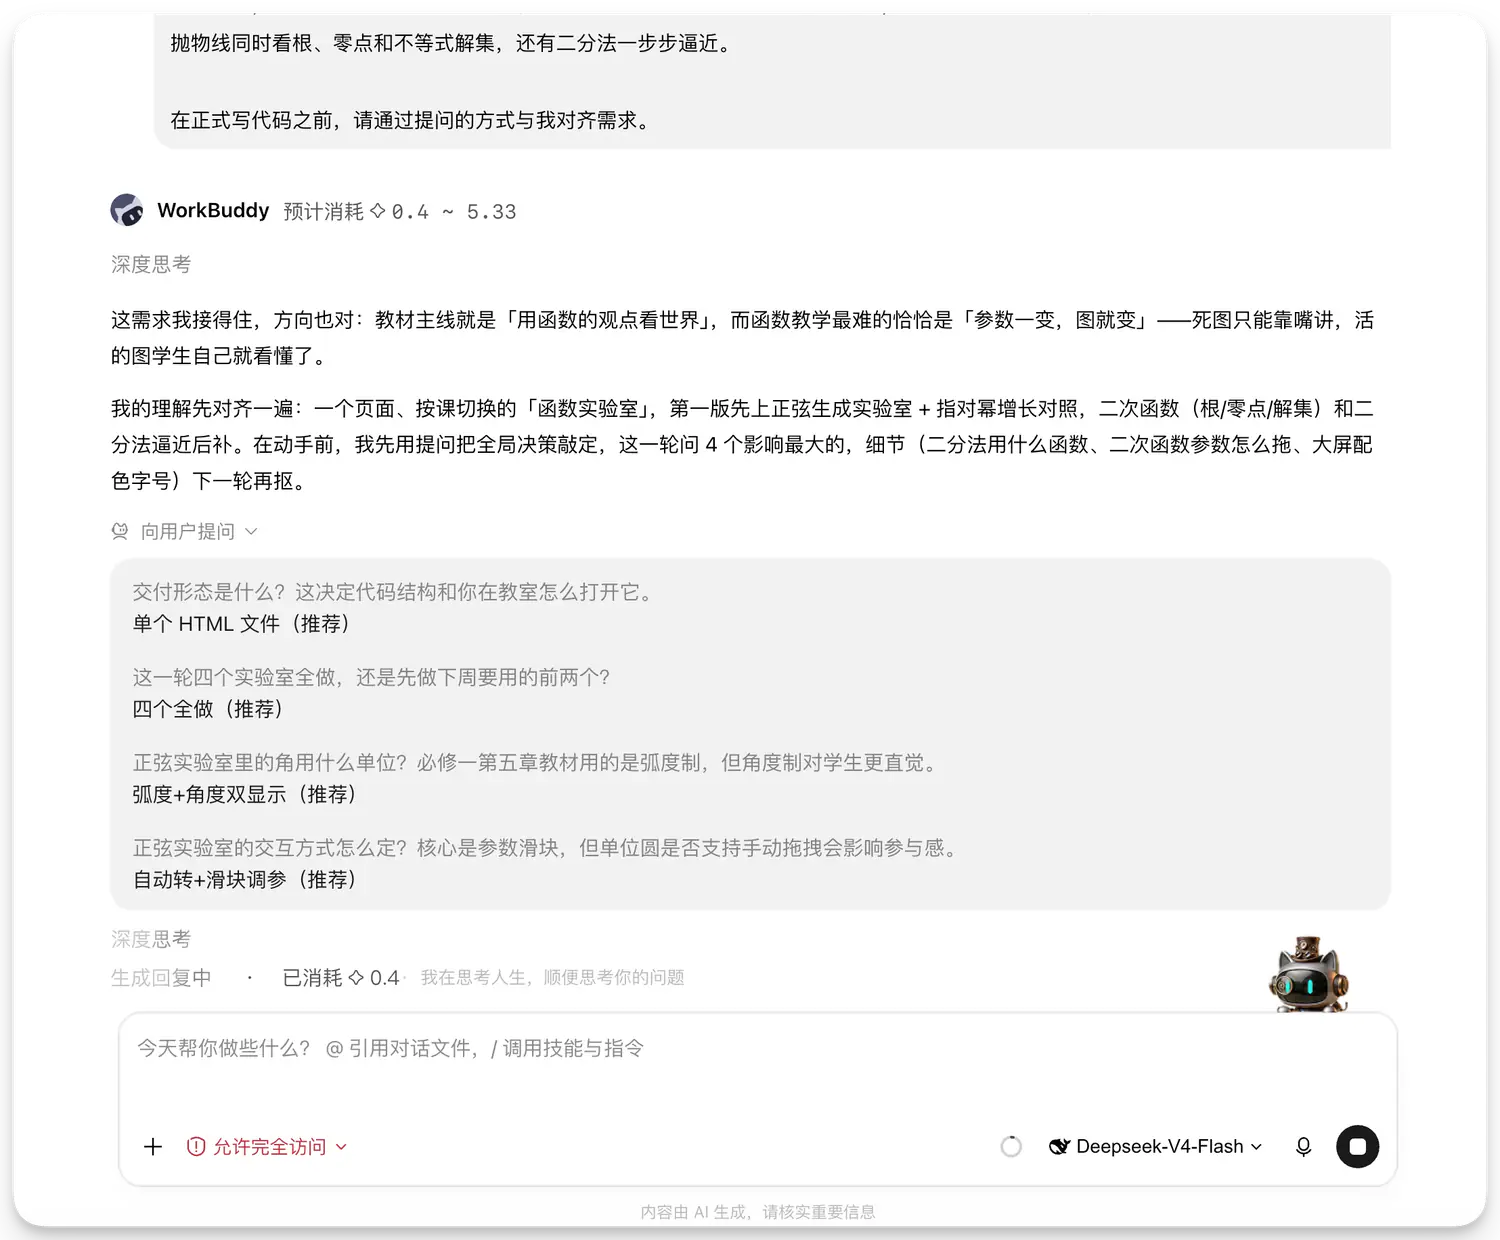
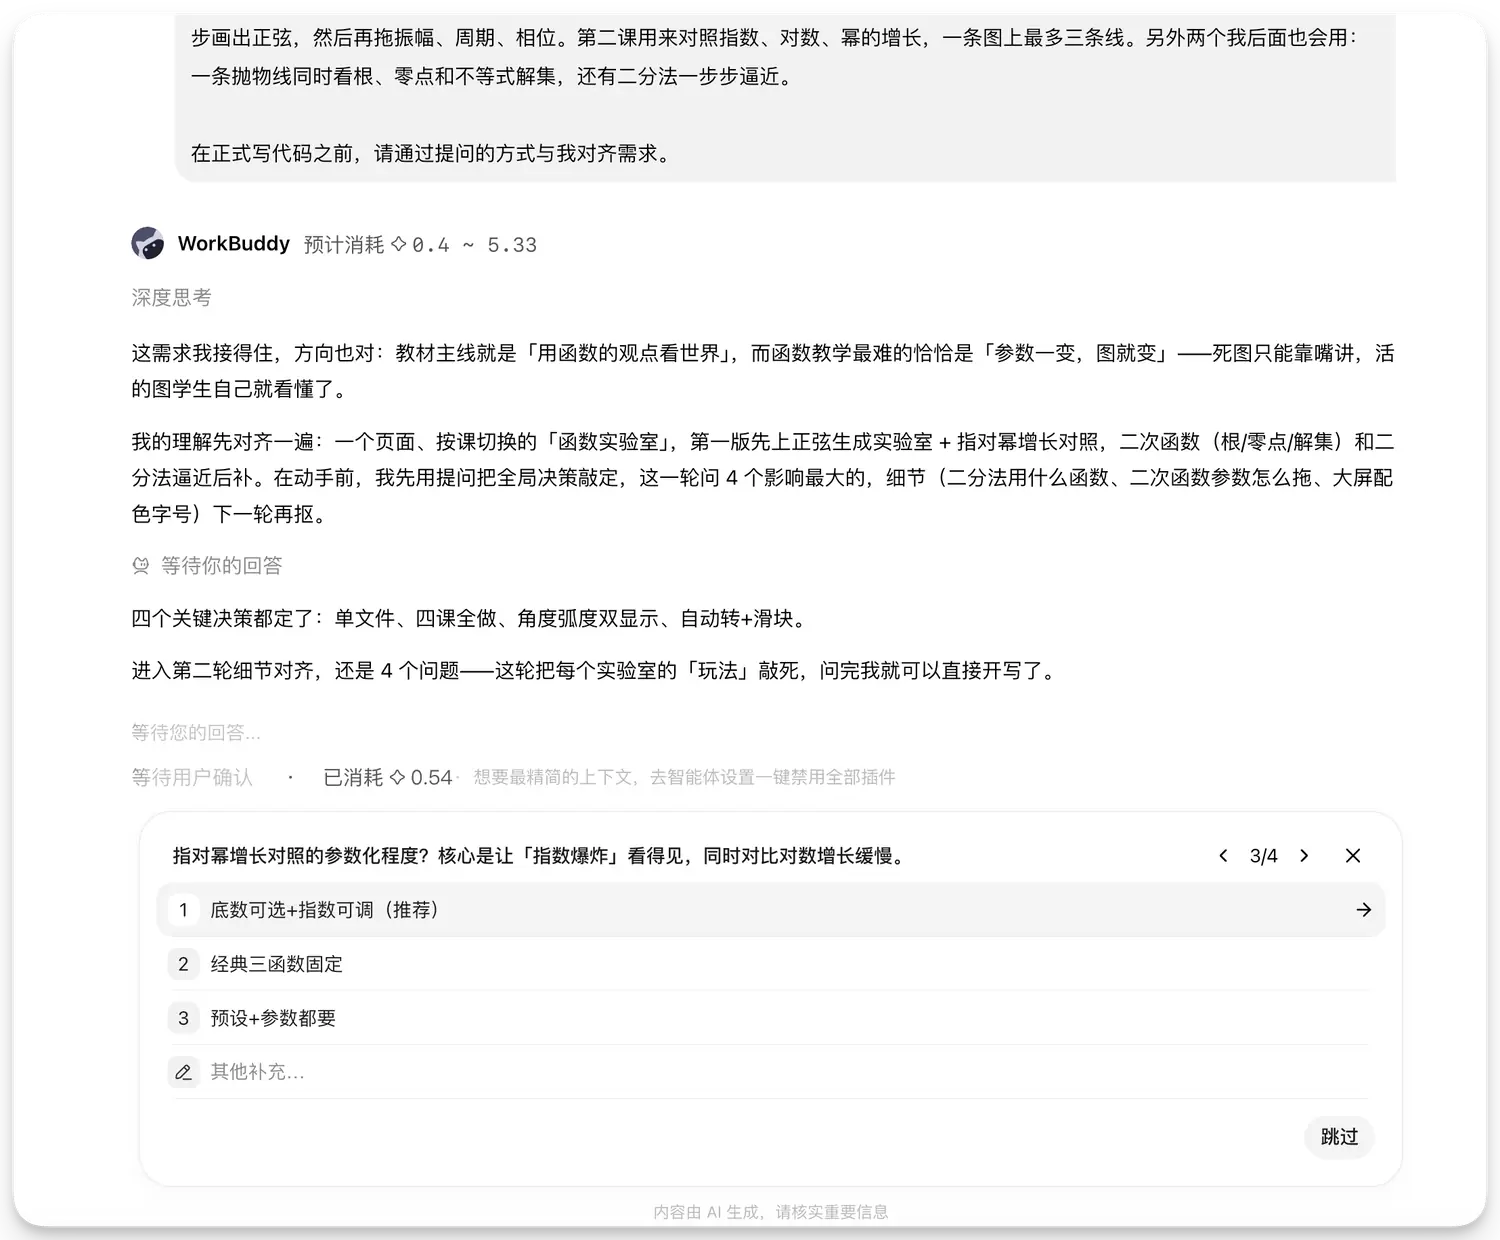
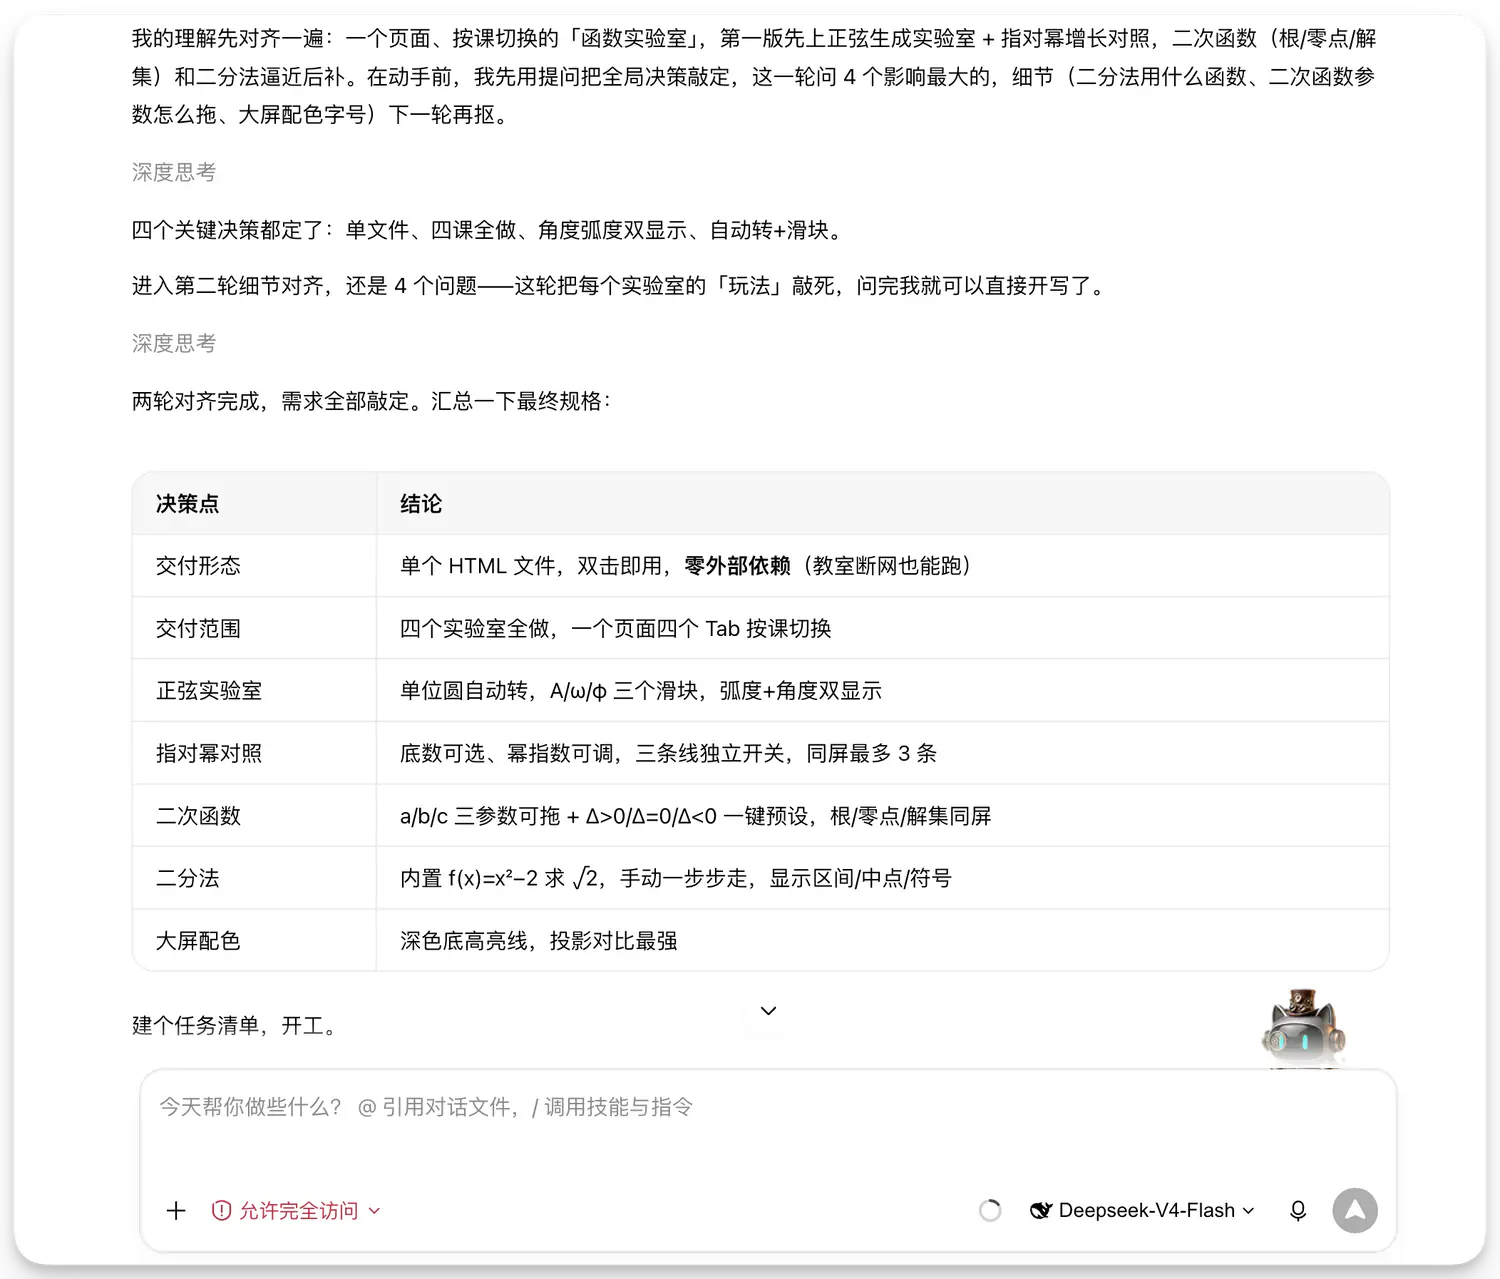
产出一个 48KB 的单文件网页,零外部依赖。教室电脑双击就能开,断网也能跑。
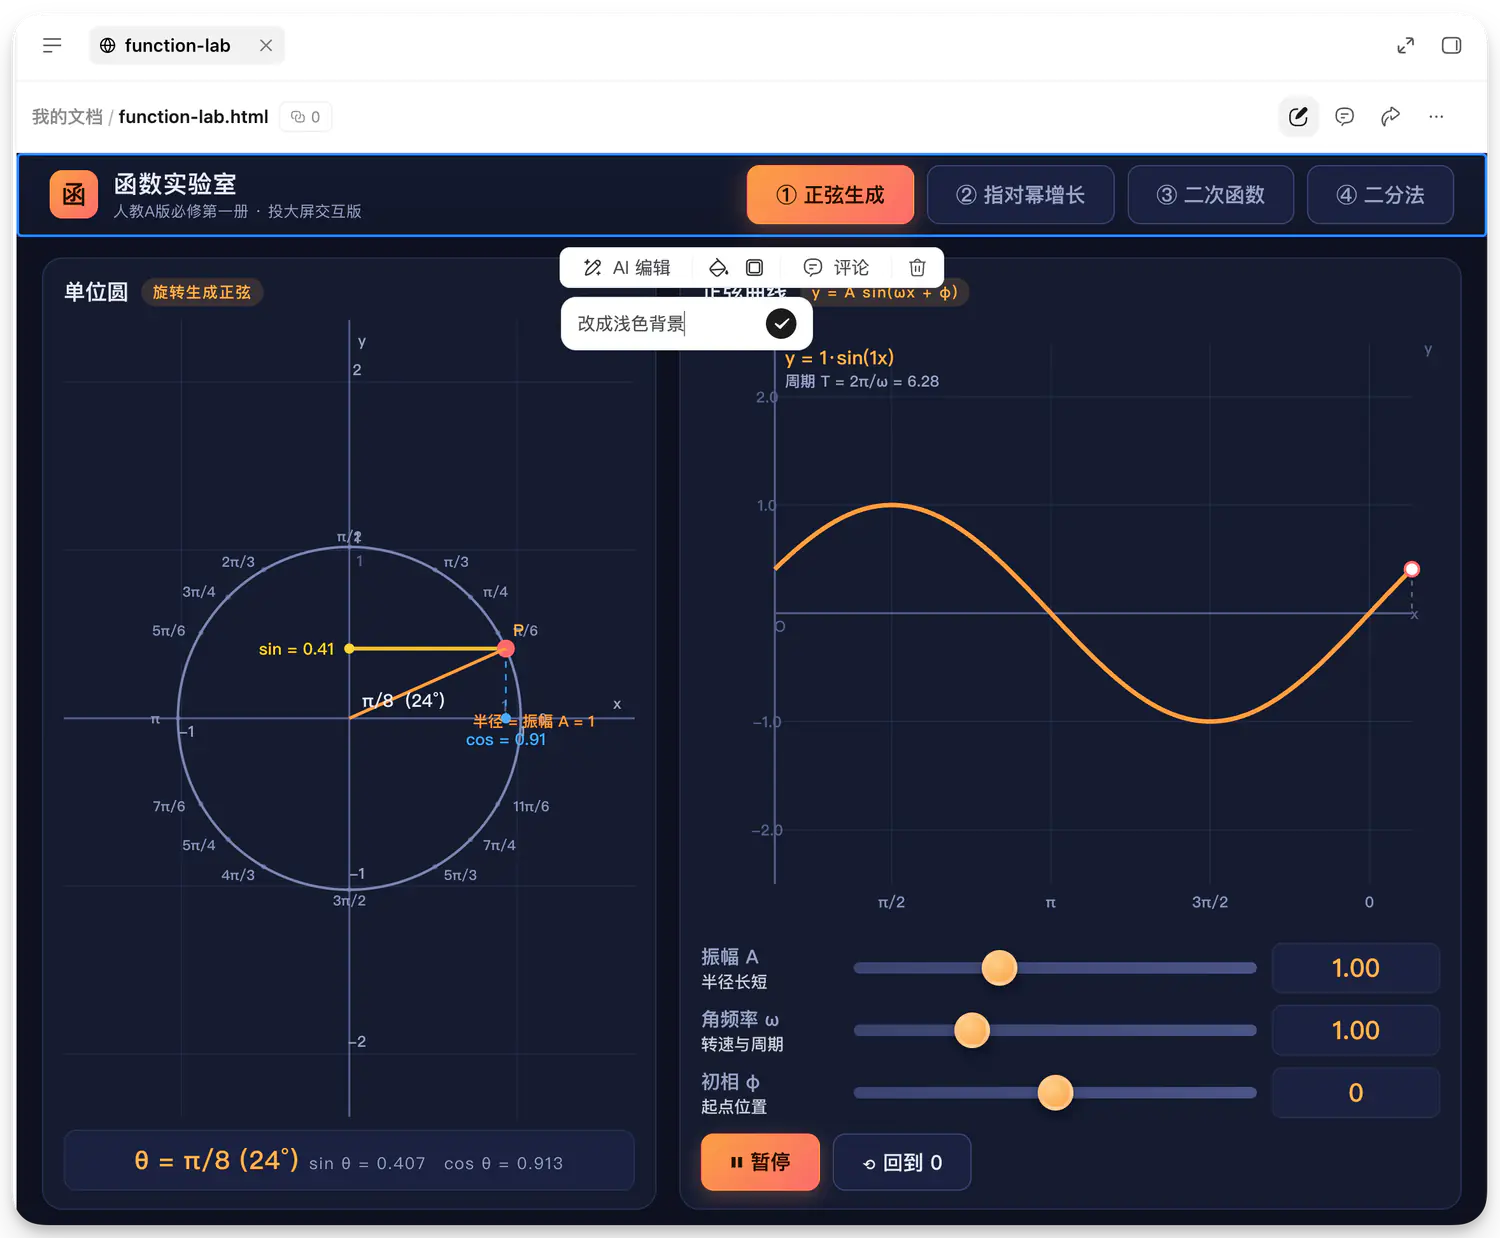
四个页面按课切换:正弦生成,单位圆转一圈,右边描出一条正弦,三个滑块随手拖;指对幂对照,指数往上冲、对数几乎趴着,课标要的增长差异一眼看见;二次函数,一条抛物线同屏看根、零点和解集;二分法,内置求 √2,点一下走一步,节奏在老师手里。
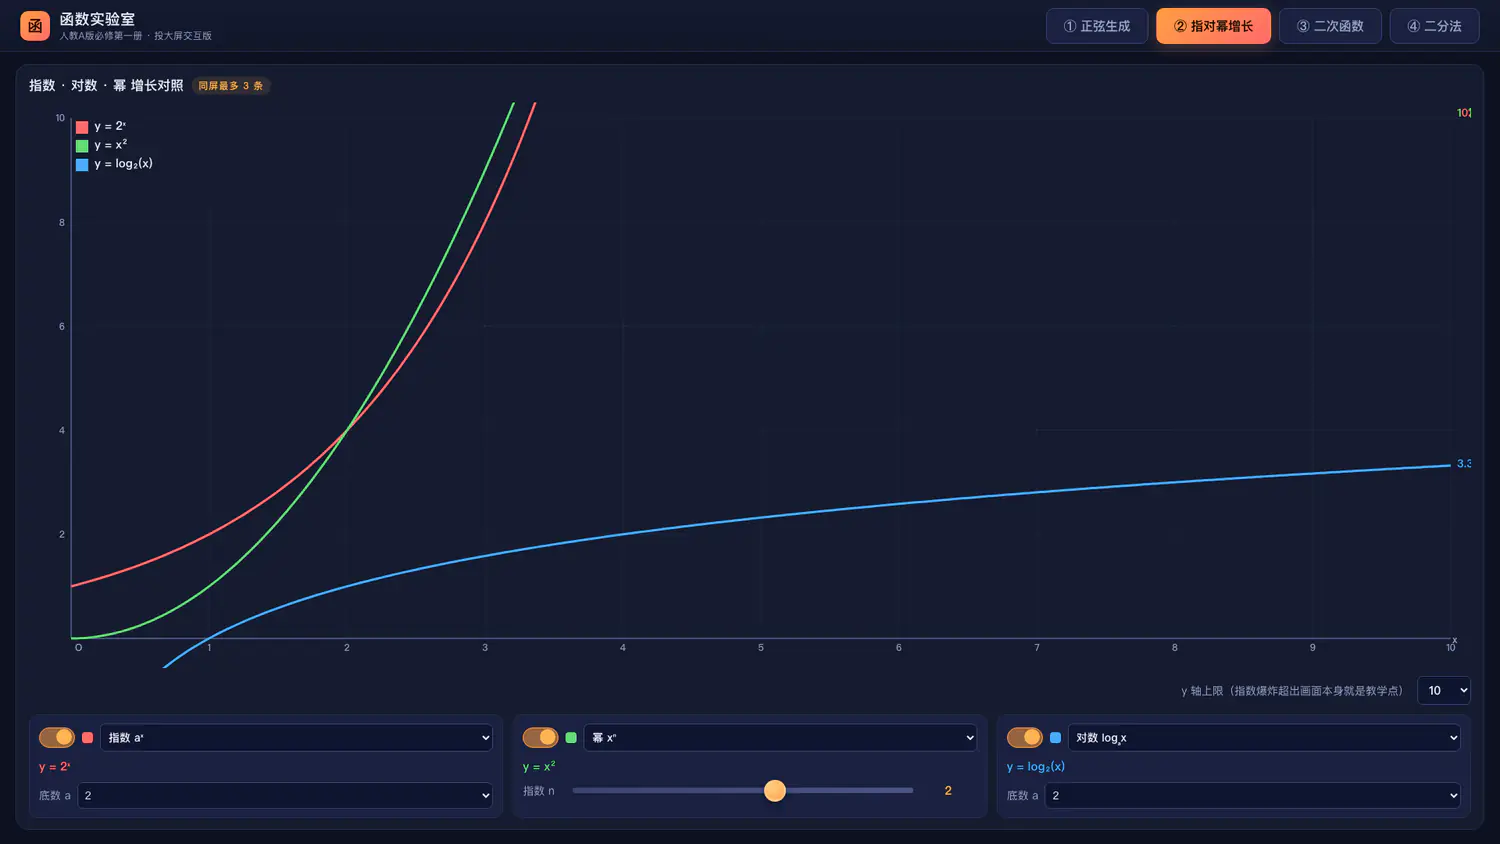
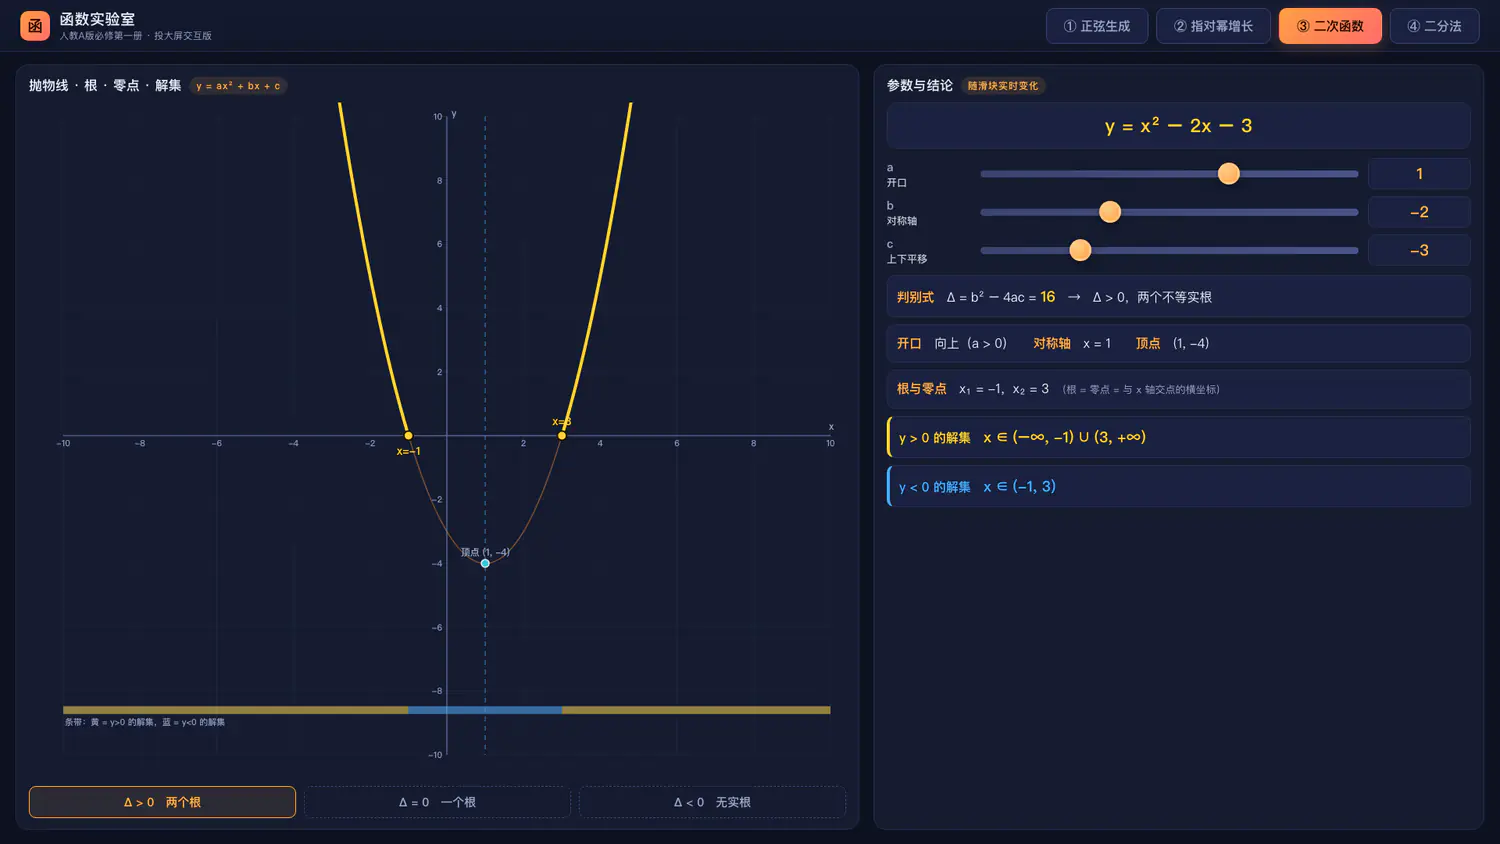
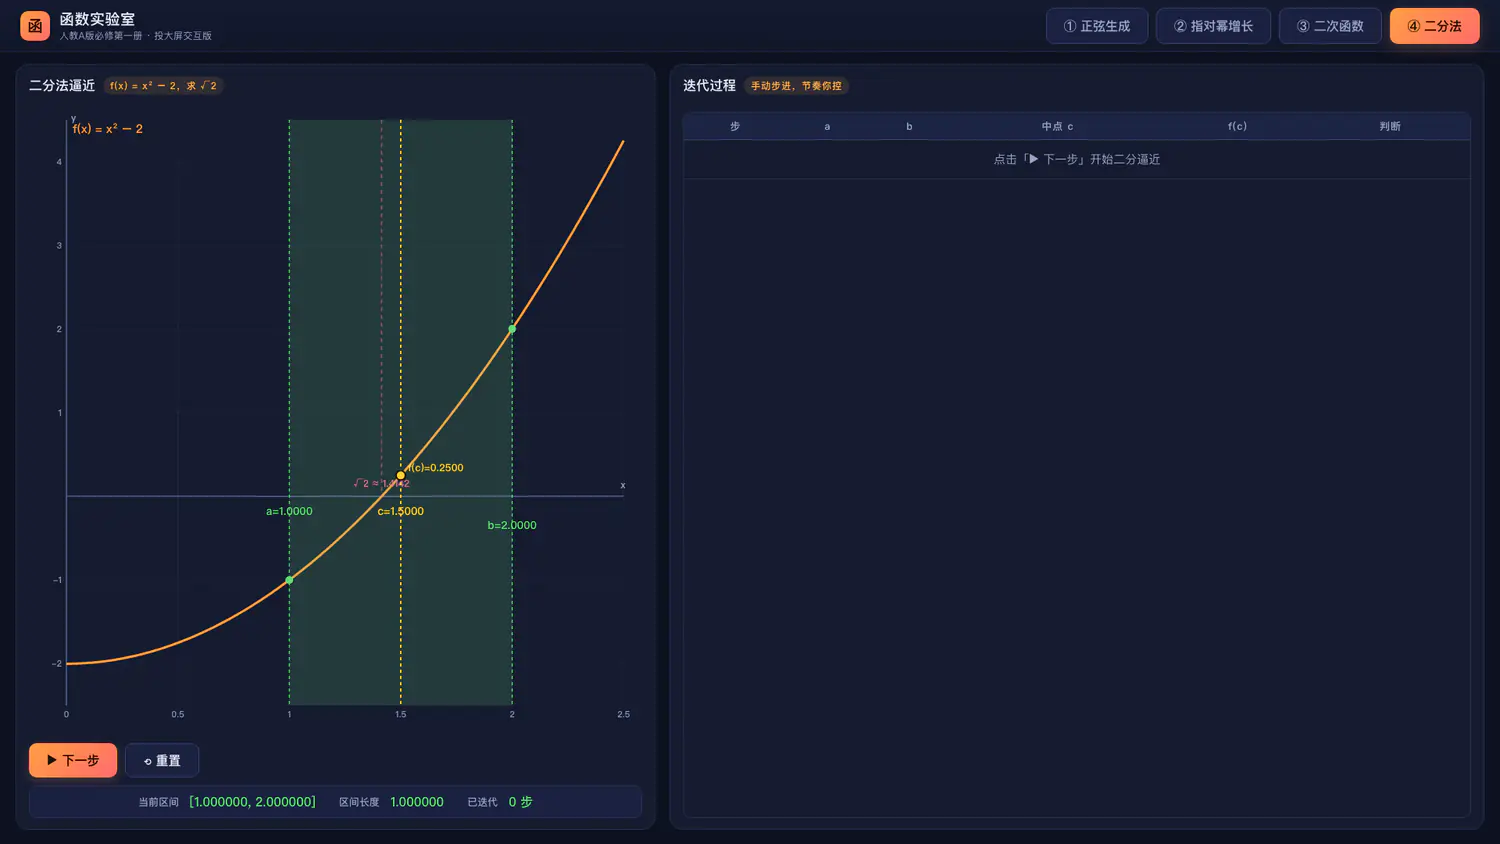
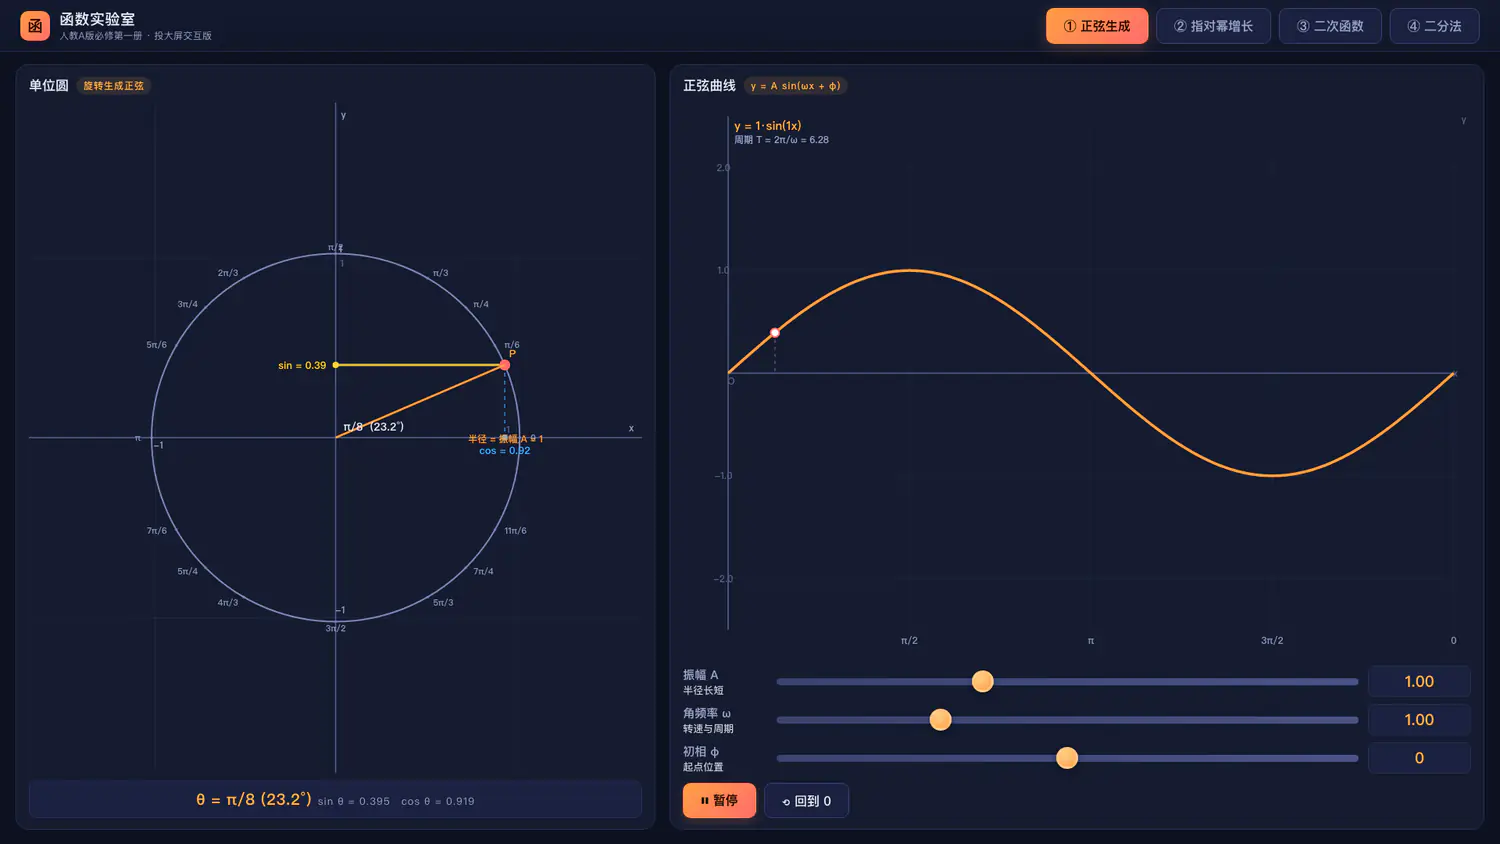
黑板画不出来的东西,一个网页就出来了。老师想改哪里,点着说就行:上传到资料库,教室电脑打开网址就能用,U 盘和微信传文件这些课堂事故源直接消失。
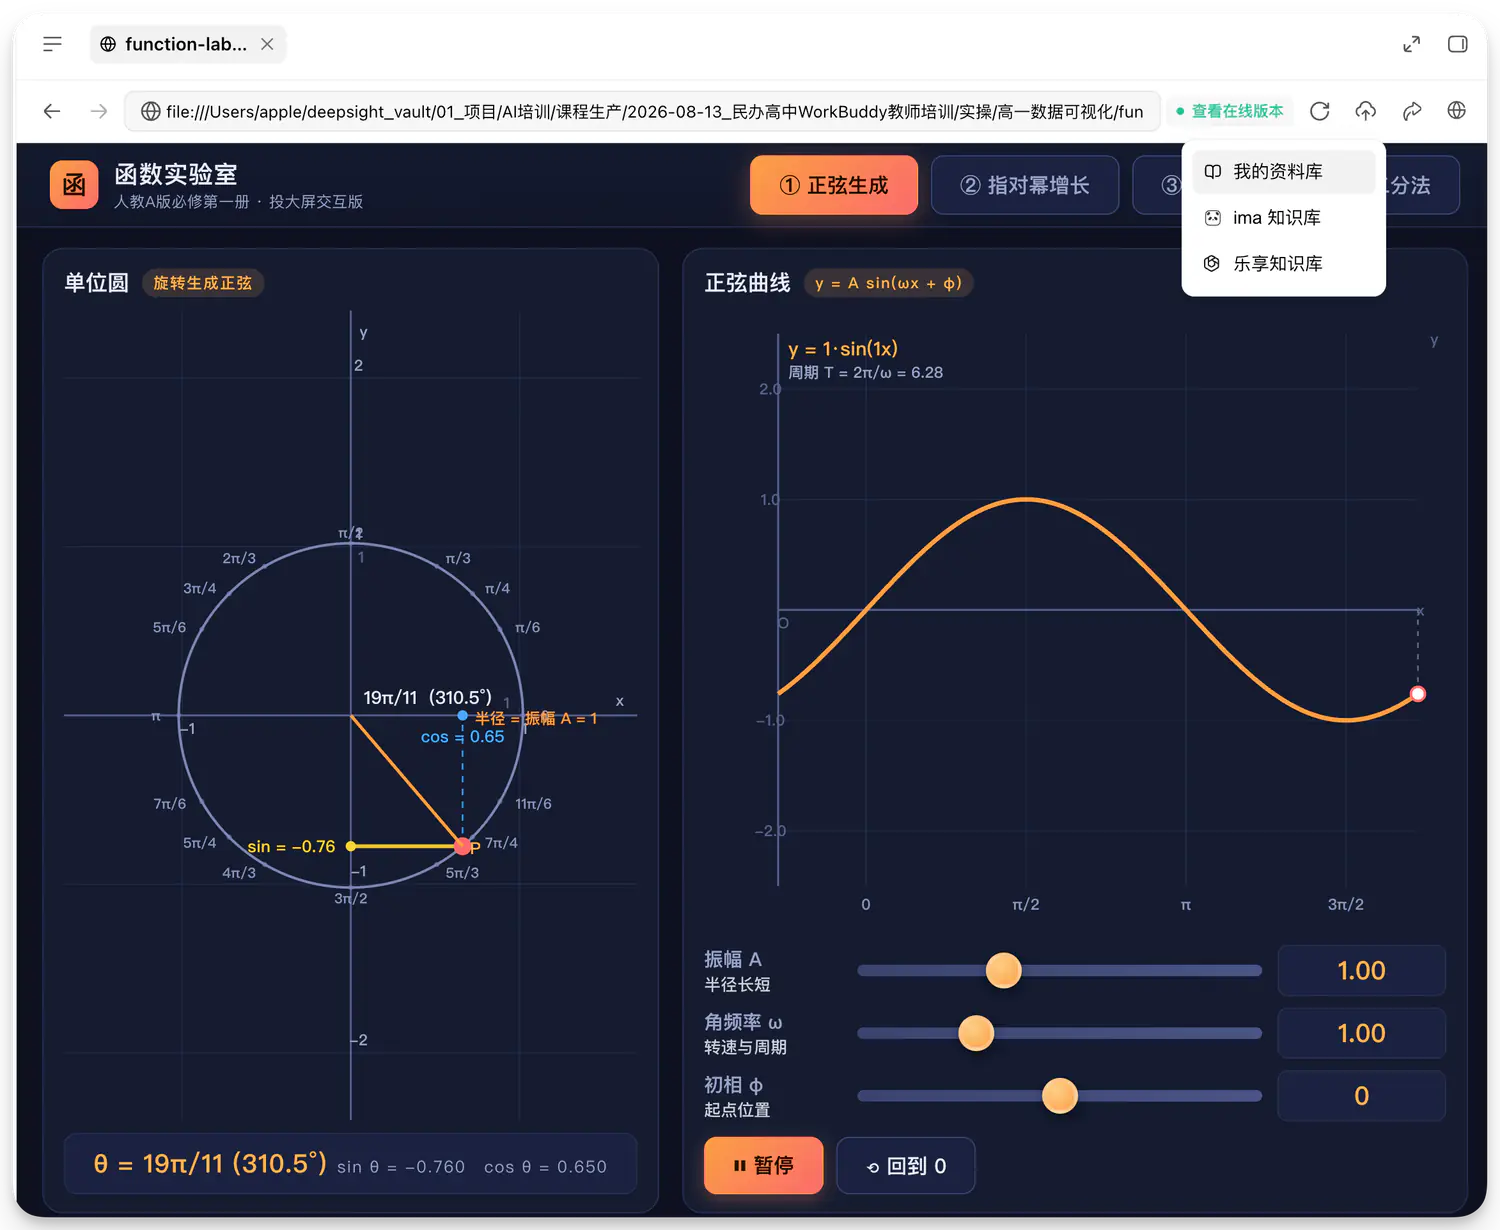
物理是同一套话术换学科内核:小车在轨道上跑,右边 x-t、v-t、a-t 三条图同步生长;双小车验证牛顿第二定律,记录几组数据直线就拟合出来;3 牛和 4 牛垂直合成,合力正好是课堂里那道 5 牛,这是它写完自己验的算。
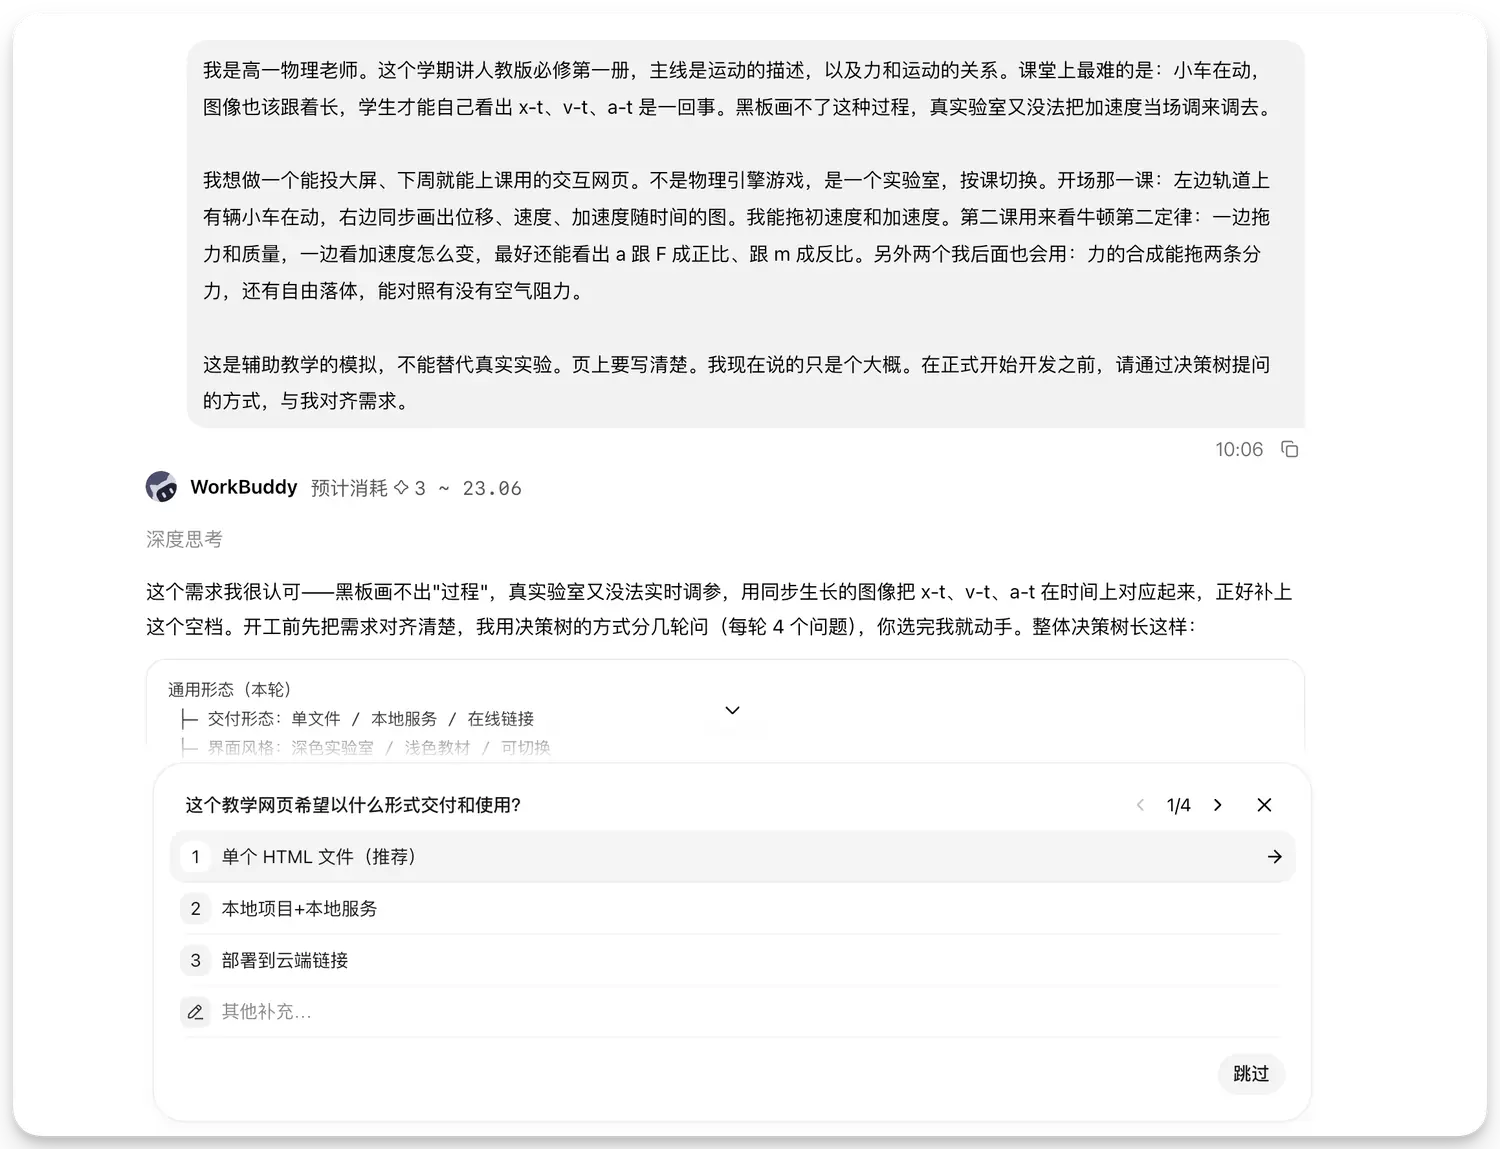
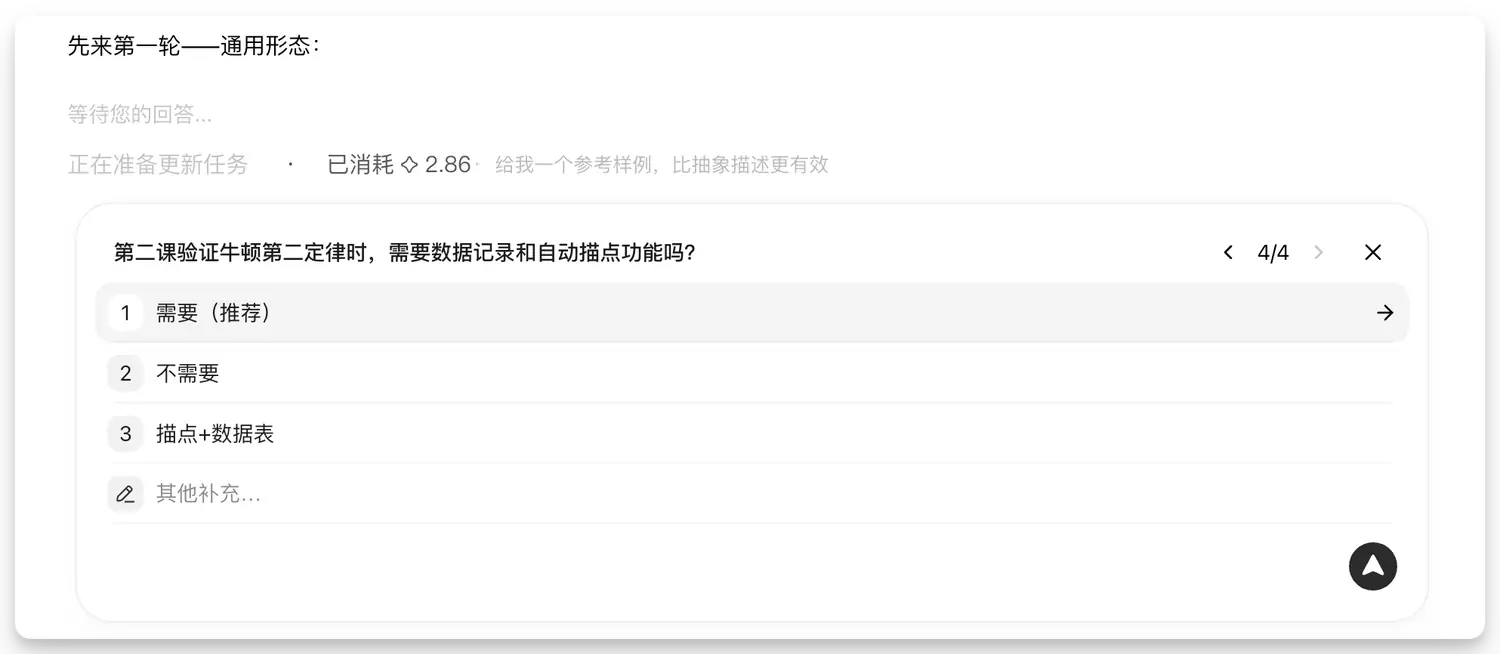
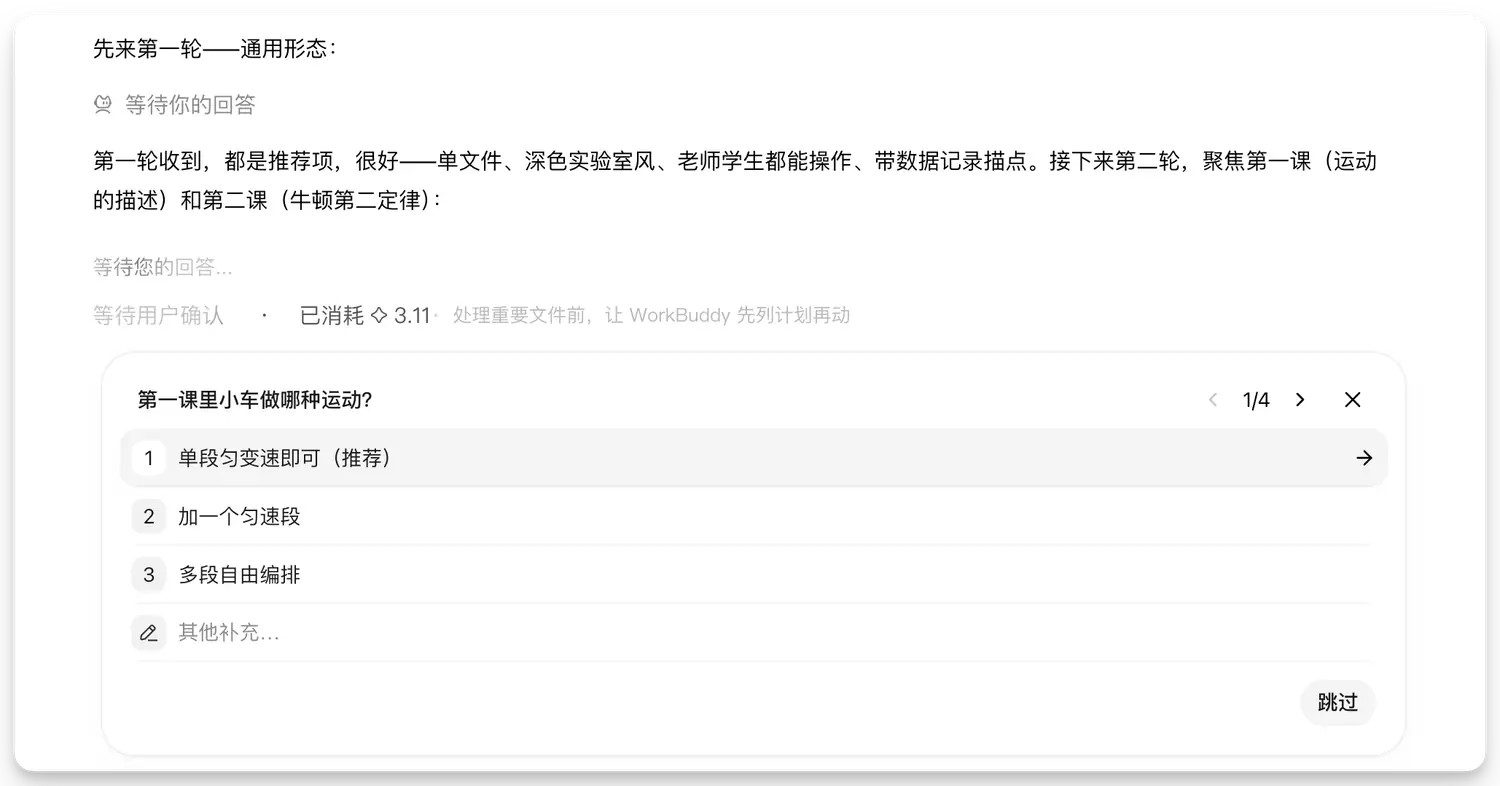
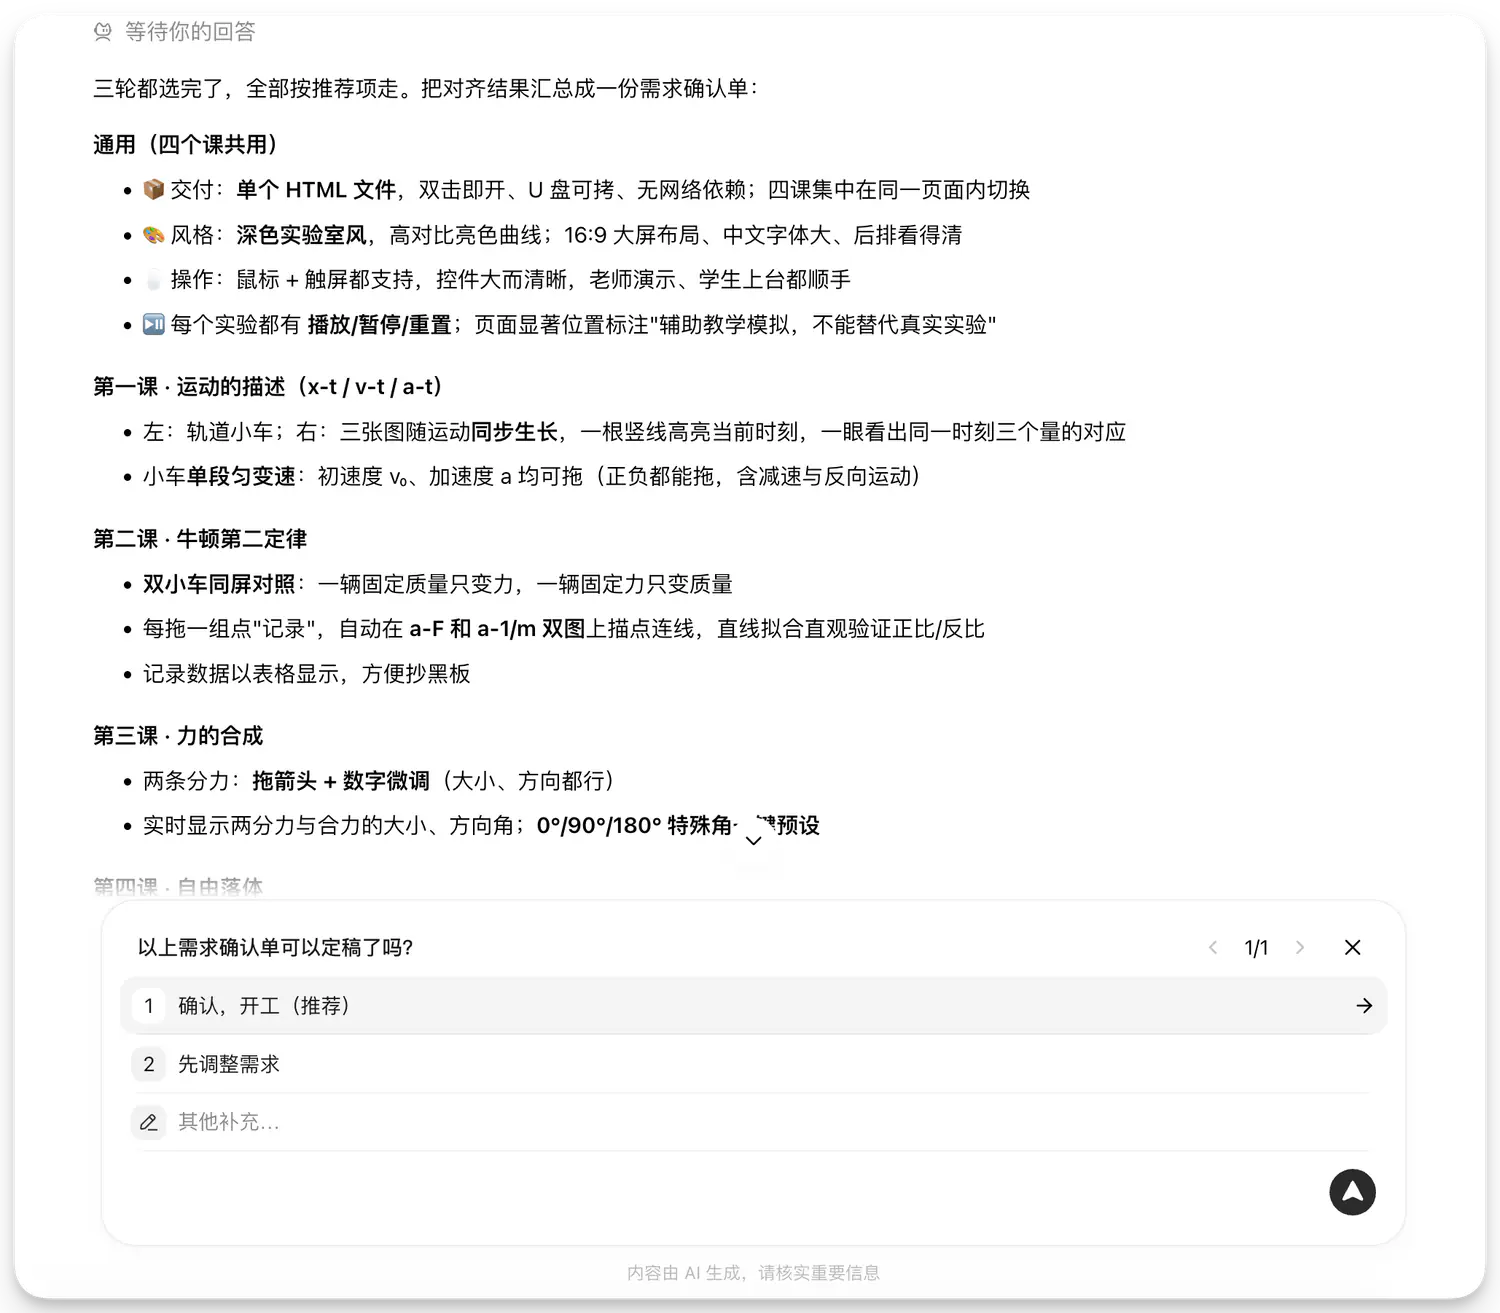
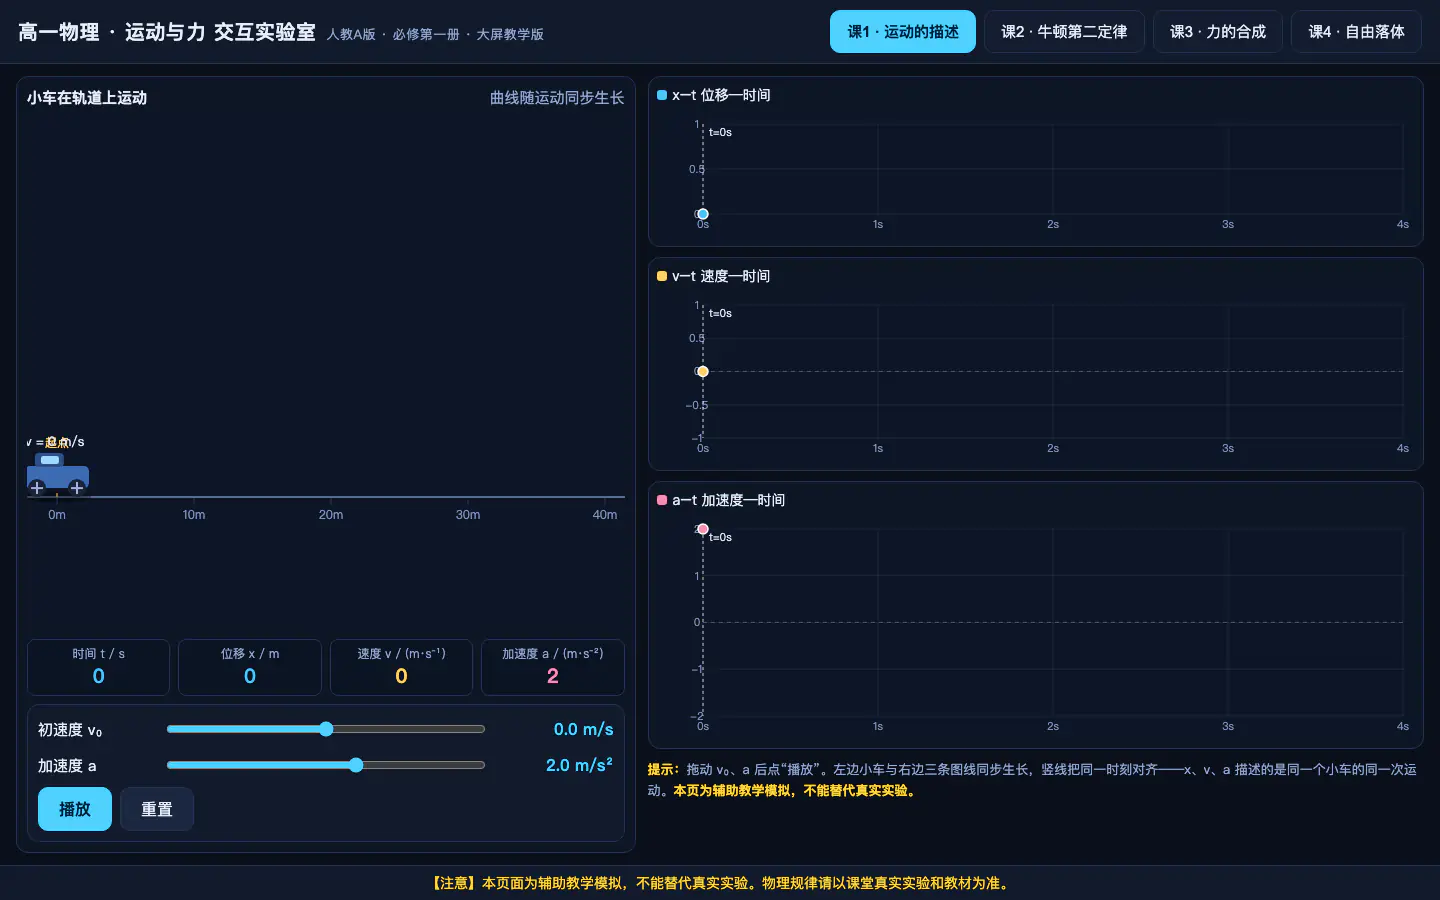
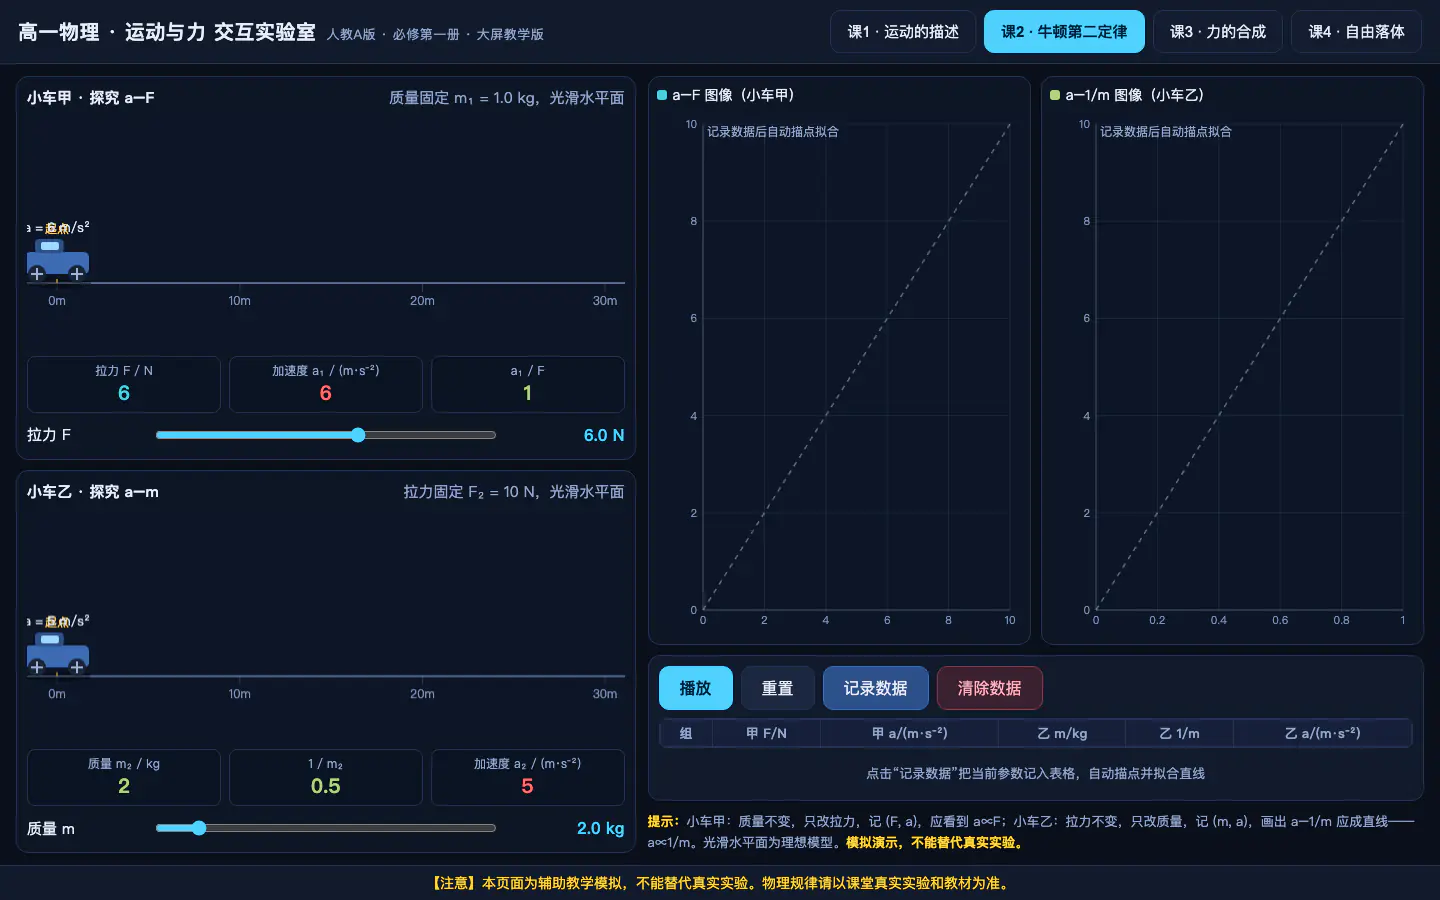
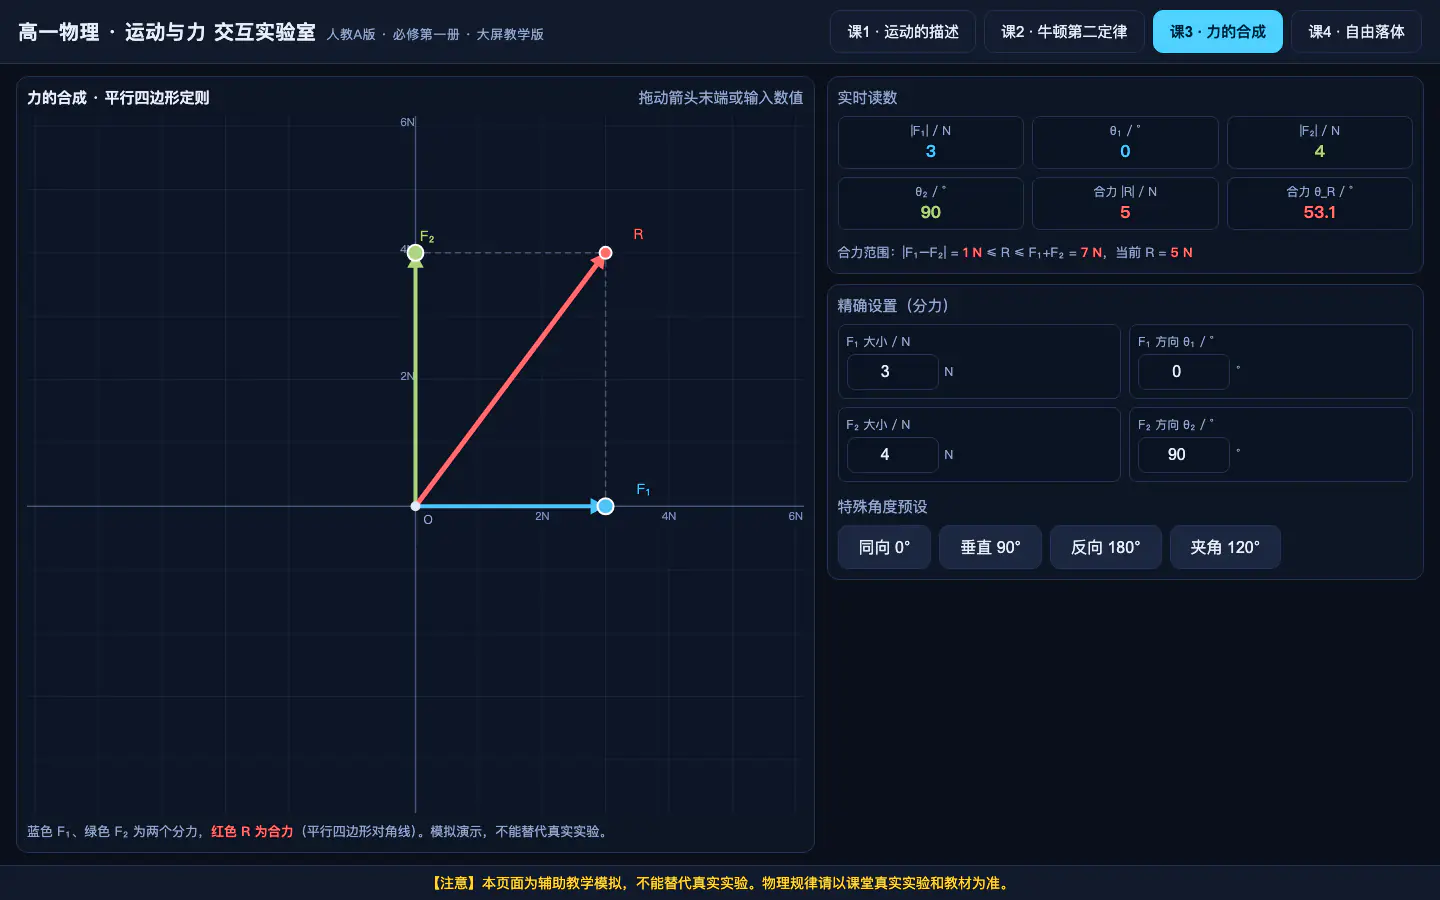
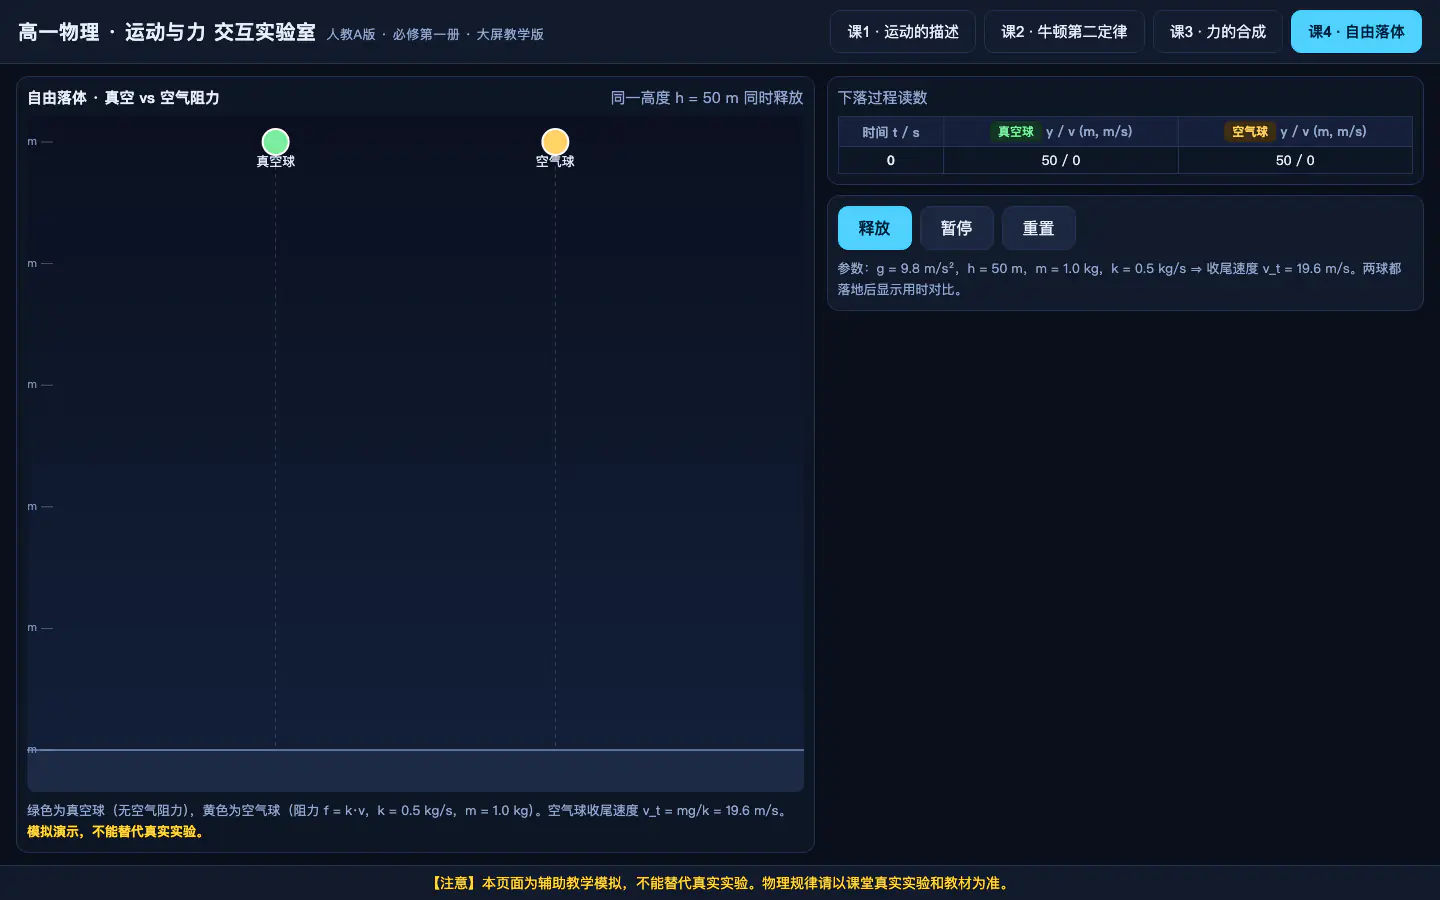
物理那个网页的页脚,始终有一行黄字:本页面为辅助教学模拟,不能替代真实实验。模拟器知道自己是模拟器,这条边界我特意让它写进页脚。
七、30 本作文,5 个工人
课前、课中都跑了,课后最重的活在等着:批改。
一个班五十个学生,每周一篇英语作文。想给每本都写出档次、原因、词汇语法句式问题和改法,时间上做不到——多数时候只能扫一眼、打个分、画两处错。对学生的成长来说,这种泛泛的反馈几乎等于没有反馈。
AI 在这件事上的优势,不是比老师更会阅卷,是能把同一套标准落到每一本上。
第一步,还是对齐。我想做一个专门改英语作文的专家:我们是河南学校,新高考全国卷,应用文满分 15 分;给它一篇手写作文照片,它要按高考标准先定档再微调、说明理由,指出词汇语法句式的问题和改进方向,文末附固定格式的 JSON 给后面整班分析用;你先别写系统提示词,通过提问的方式与我对齐需求。
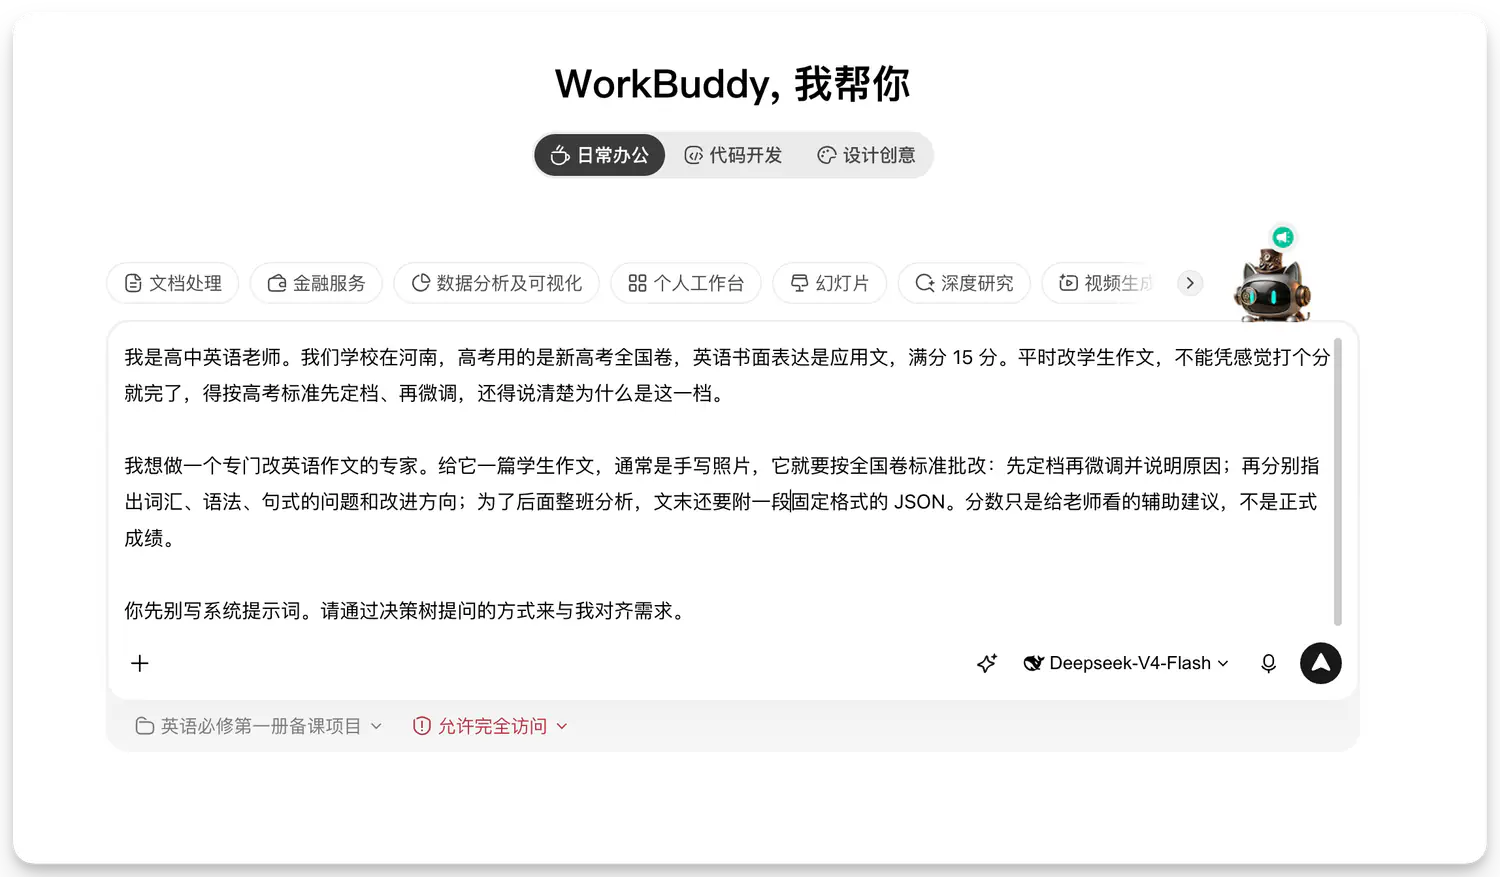
人对出来的是什么?是阅卷习惯。
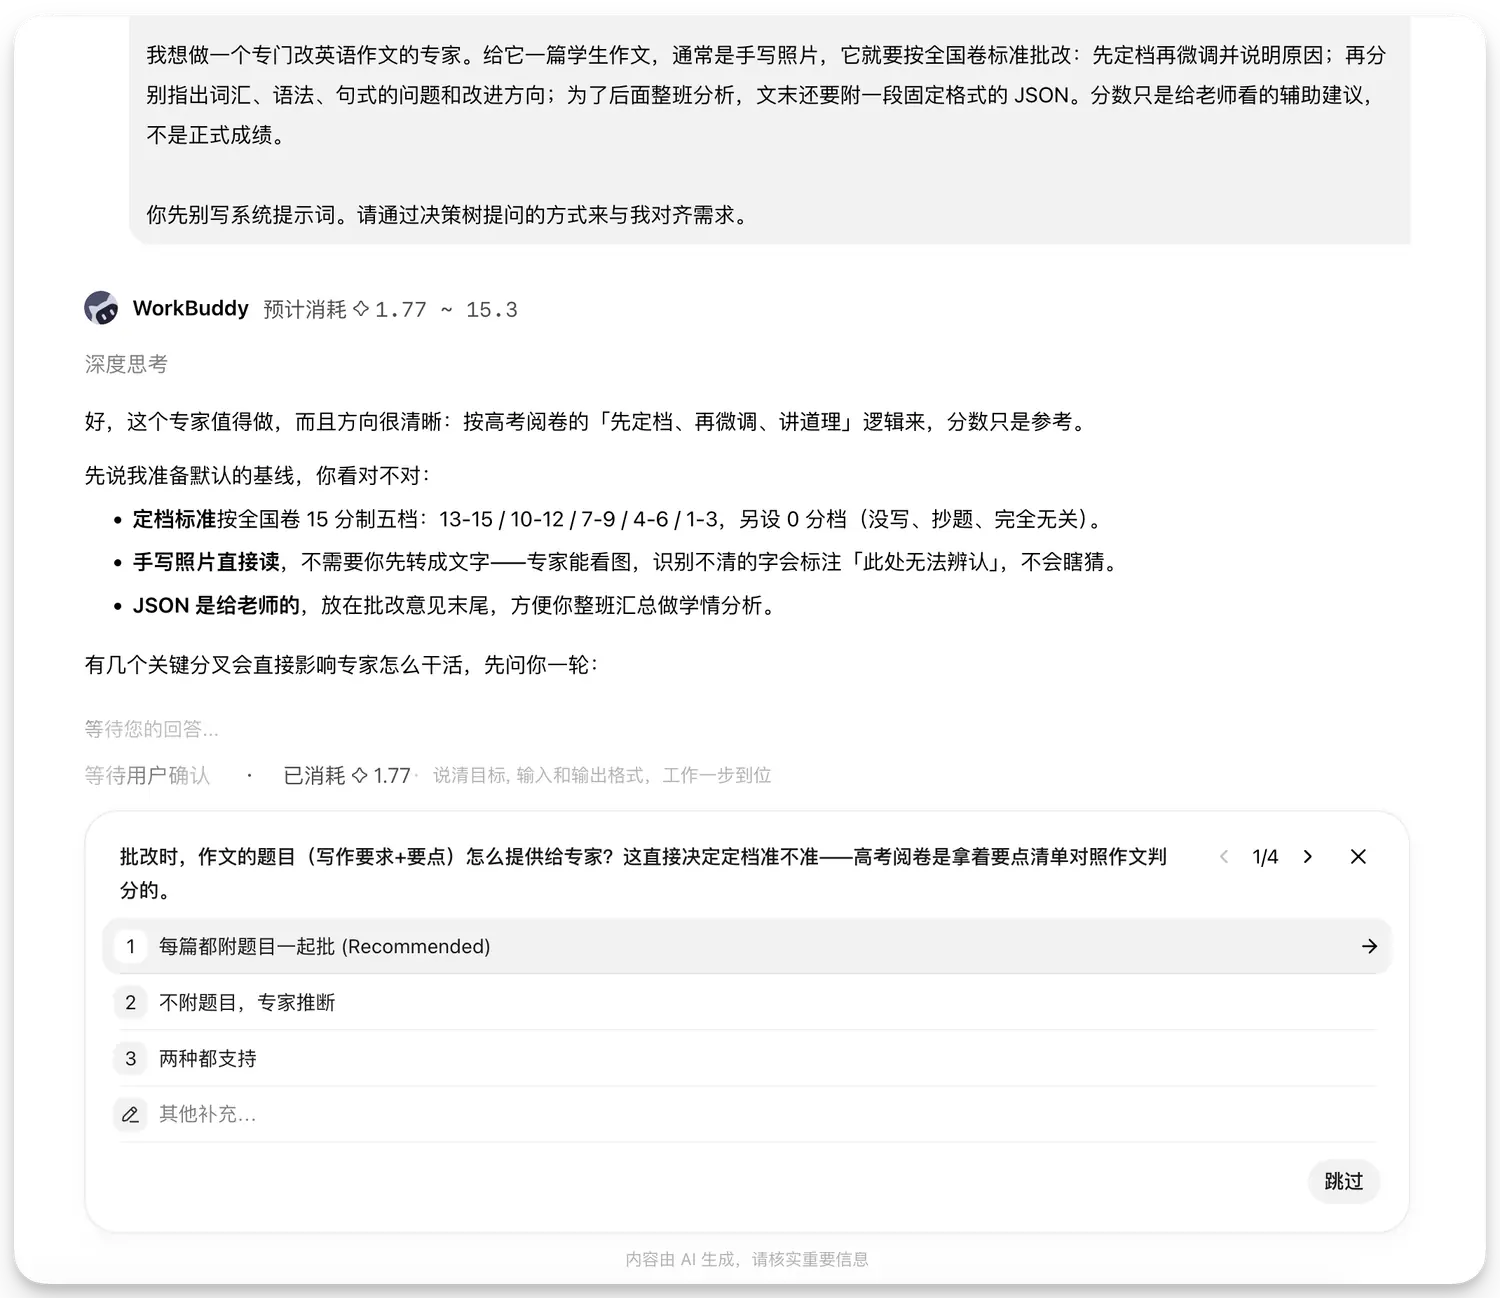
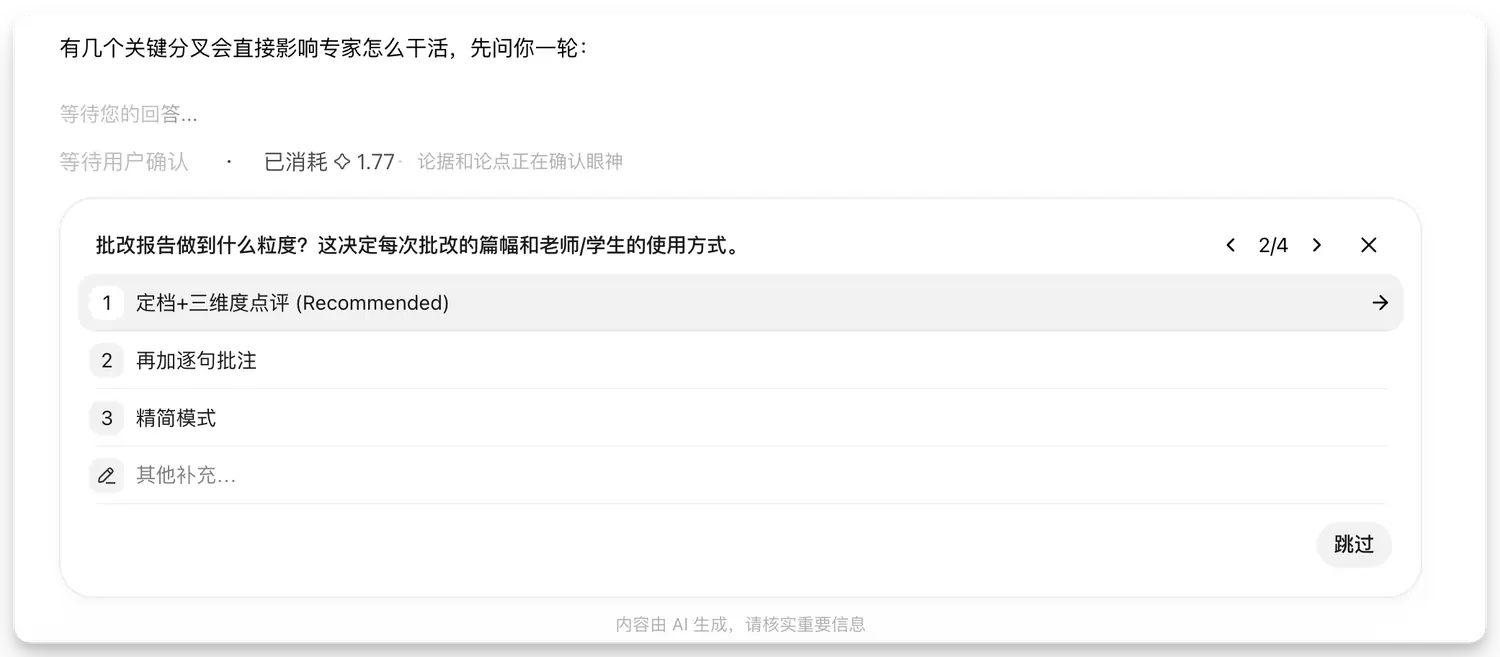
题目必须每篇附上——高考阅卷是拿着要点单对照的,不附题目它就瞎猜。报告粒度选定档加三维度点评——逐句批注改 30 篇,老师根本看不动。
定档规则也一条条对:内容定基准档,要点全覆盖进 13 到 15 分档,漏一个要点降一档,语言只在档内上下浮动,词数严重不足降档,卷面不计分、照片看不清留给人。JSON 字段勾四项:学生信息、评分数据、问题标签、亮点建议。每维度点评不超过 3 条——改 30 篇的时候老师还扫得动。
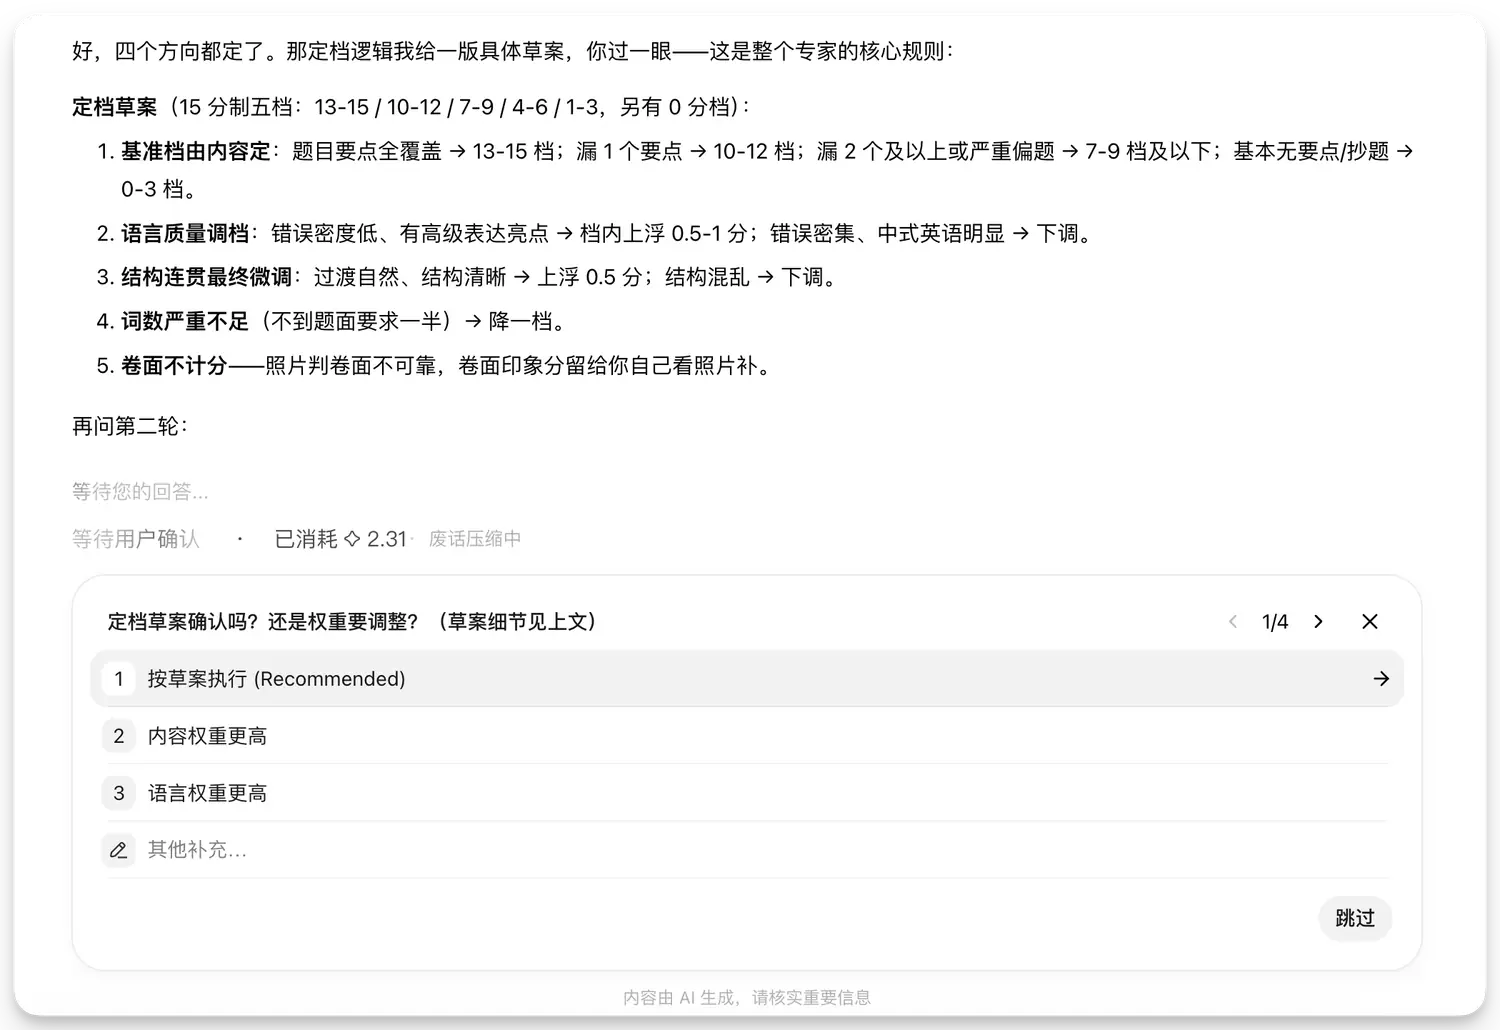
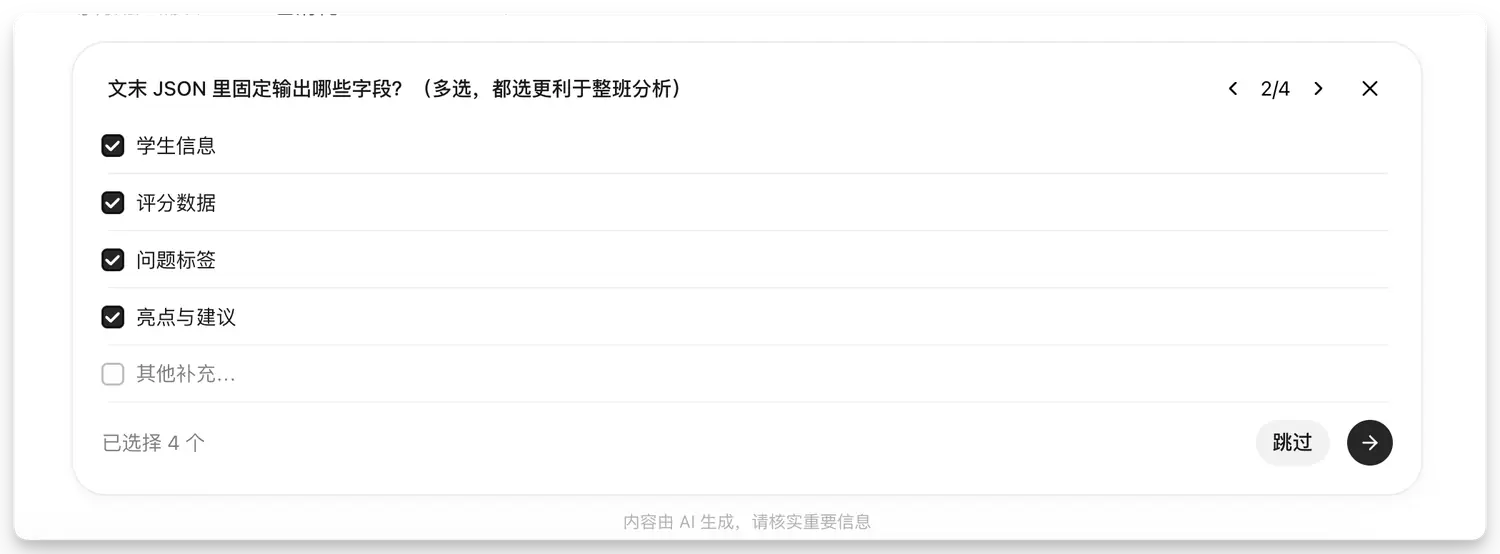
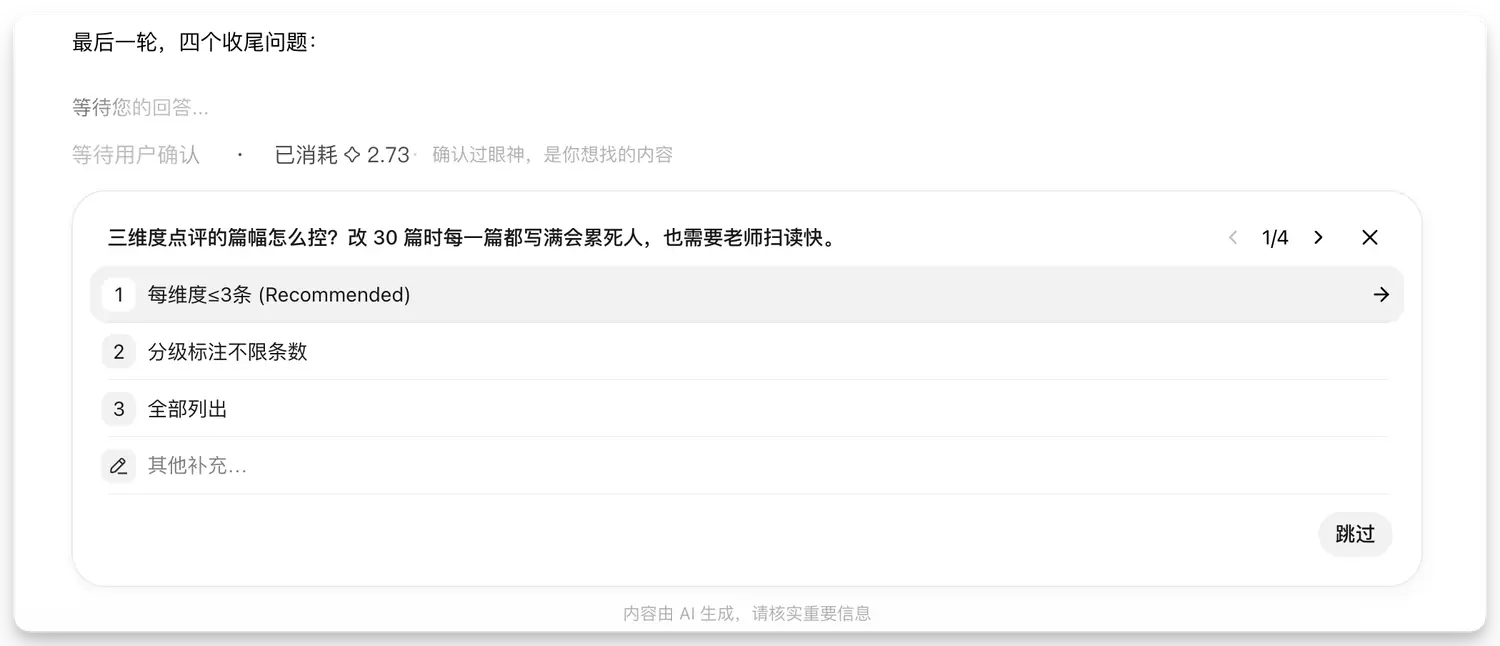
系统提示词不是写出来的,是把阅卷习惯对清楚之后固化下来的。
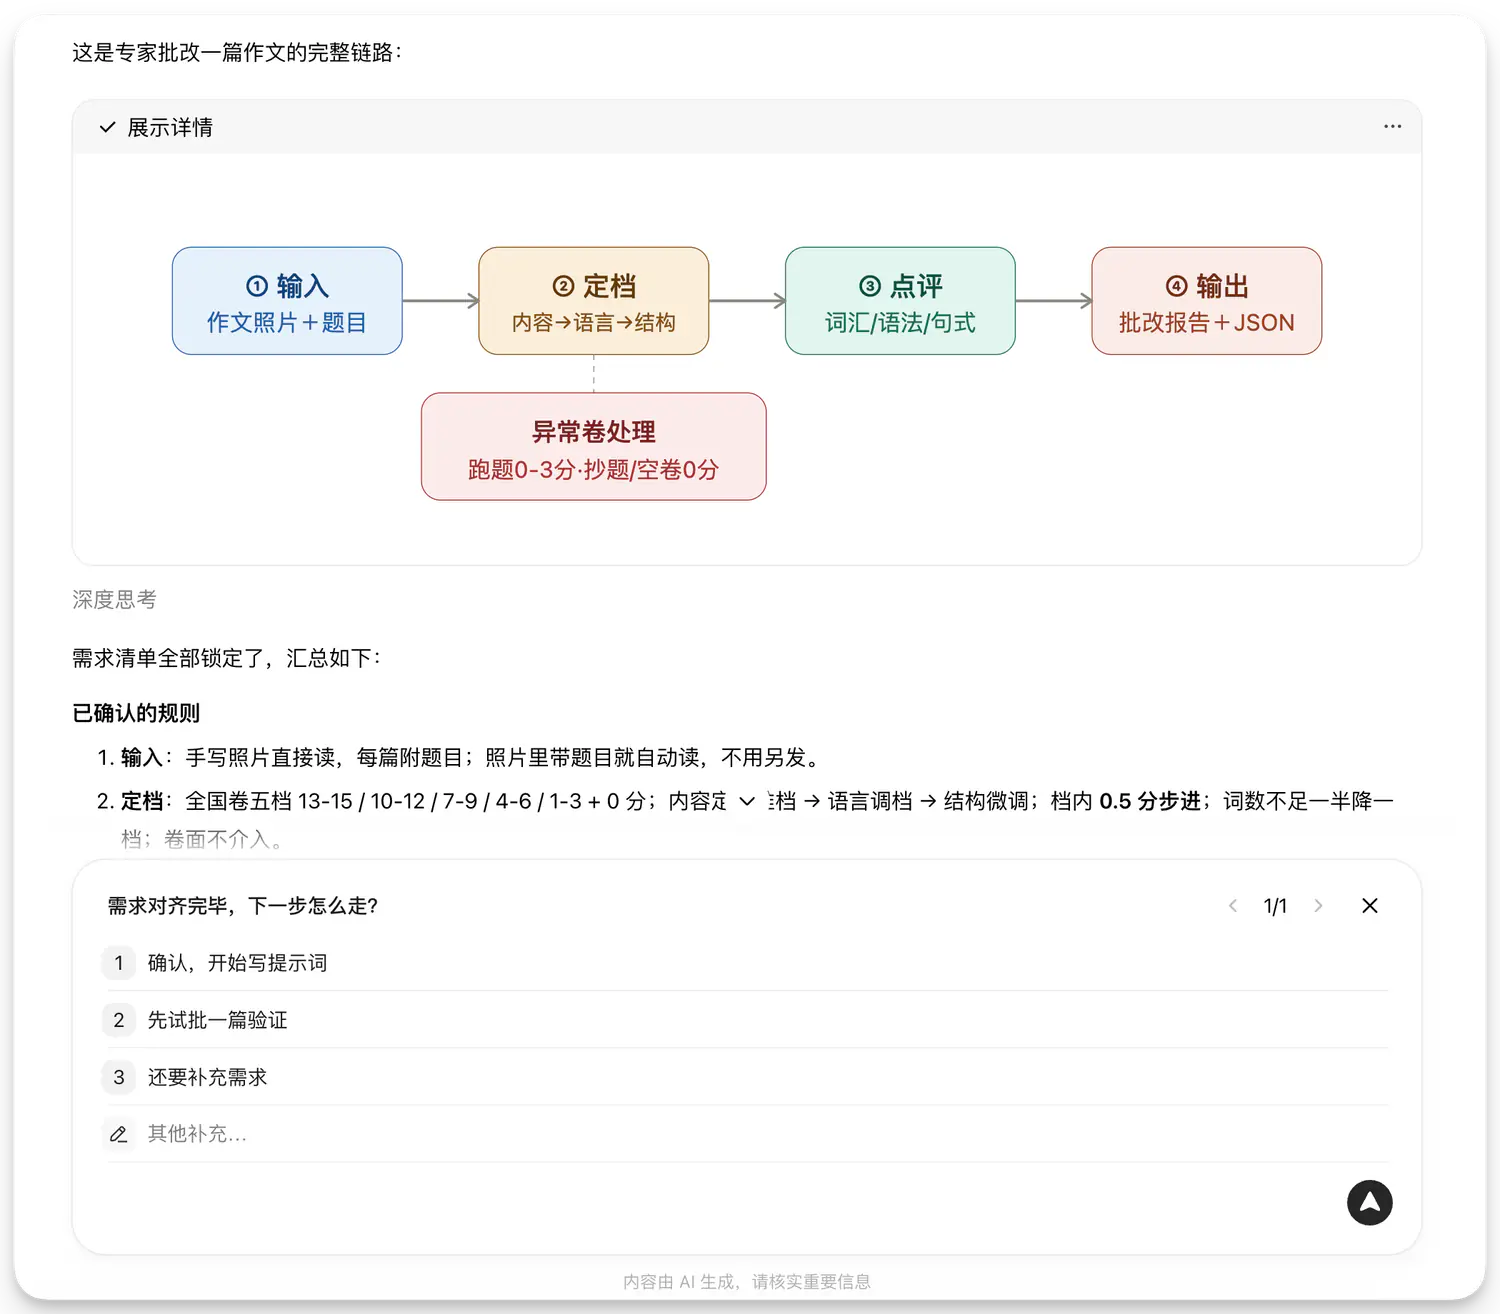
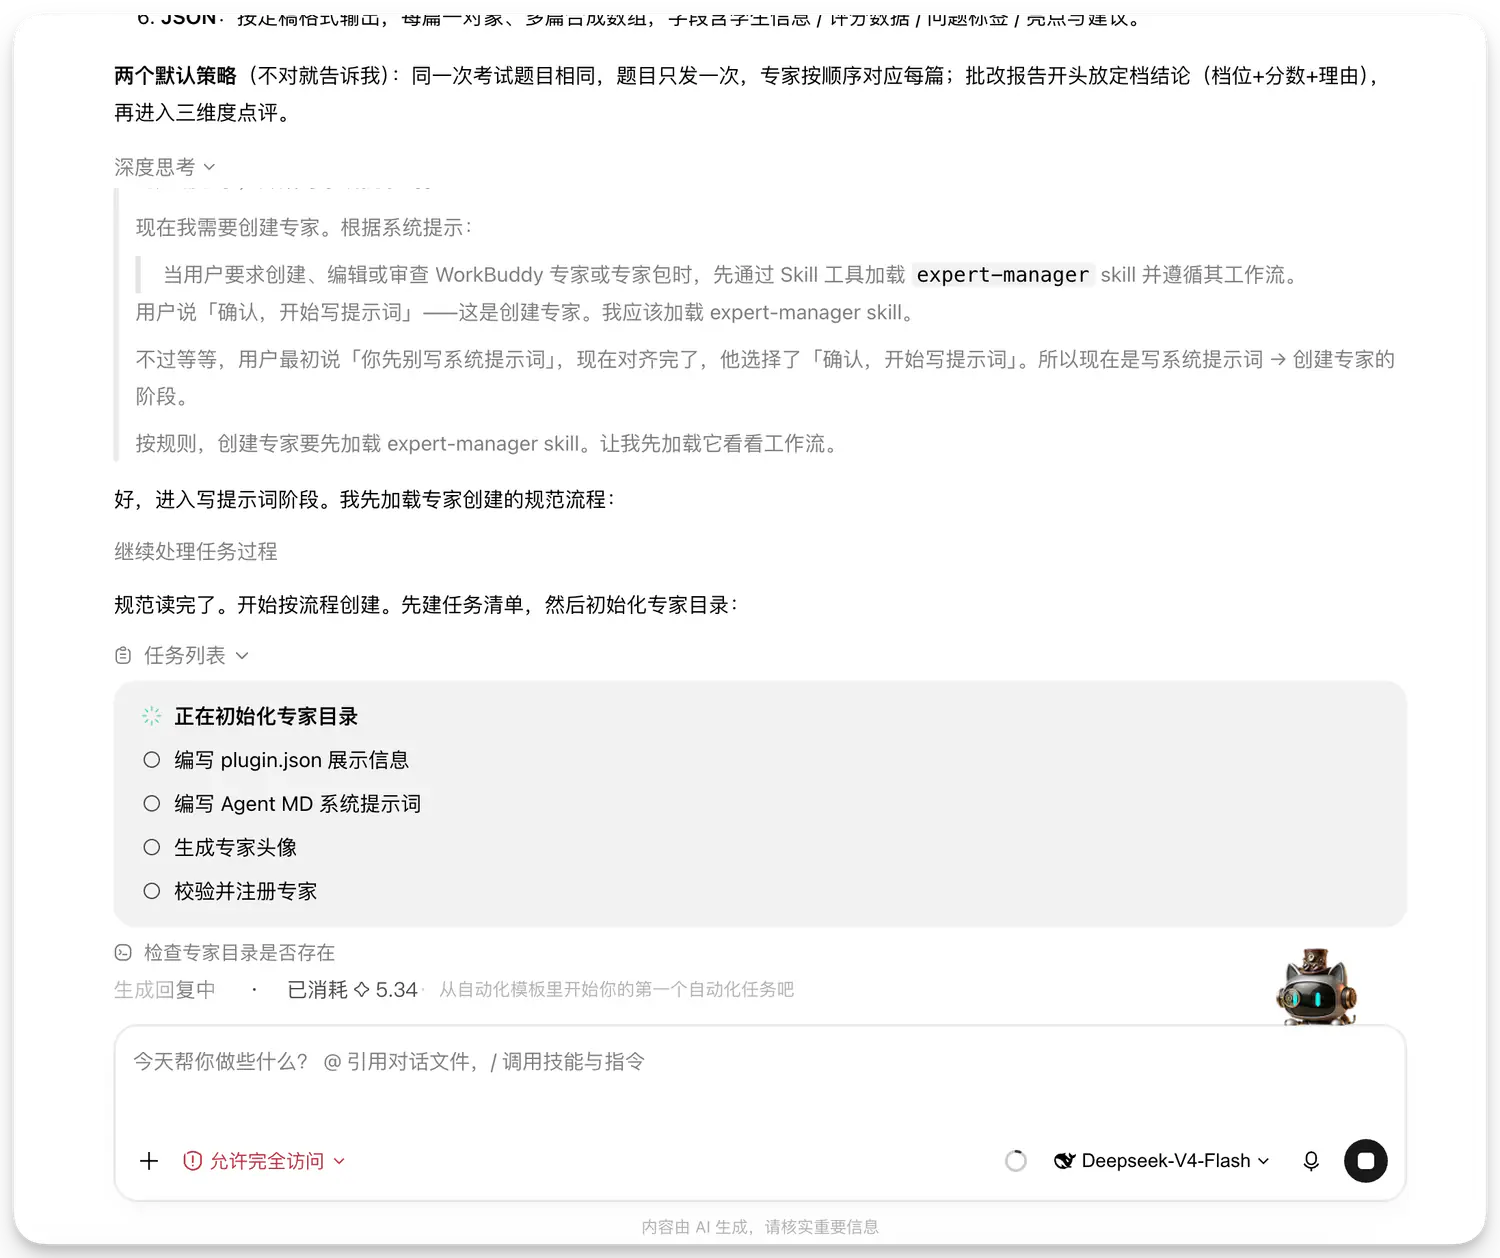
对齐完,它按规范创建专家,注册名「高考英语应用文阅卷老师」,花名明格。默认模型锁成 MiniMax-M3,原生多模态——手写照片直接看,连你用什么颜色的笔、哪里打了勾都知道,这比先 OCR 提字再评贴课堂得多。
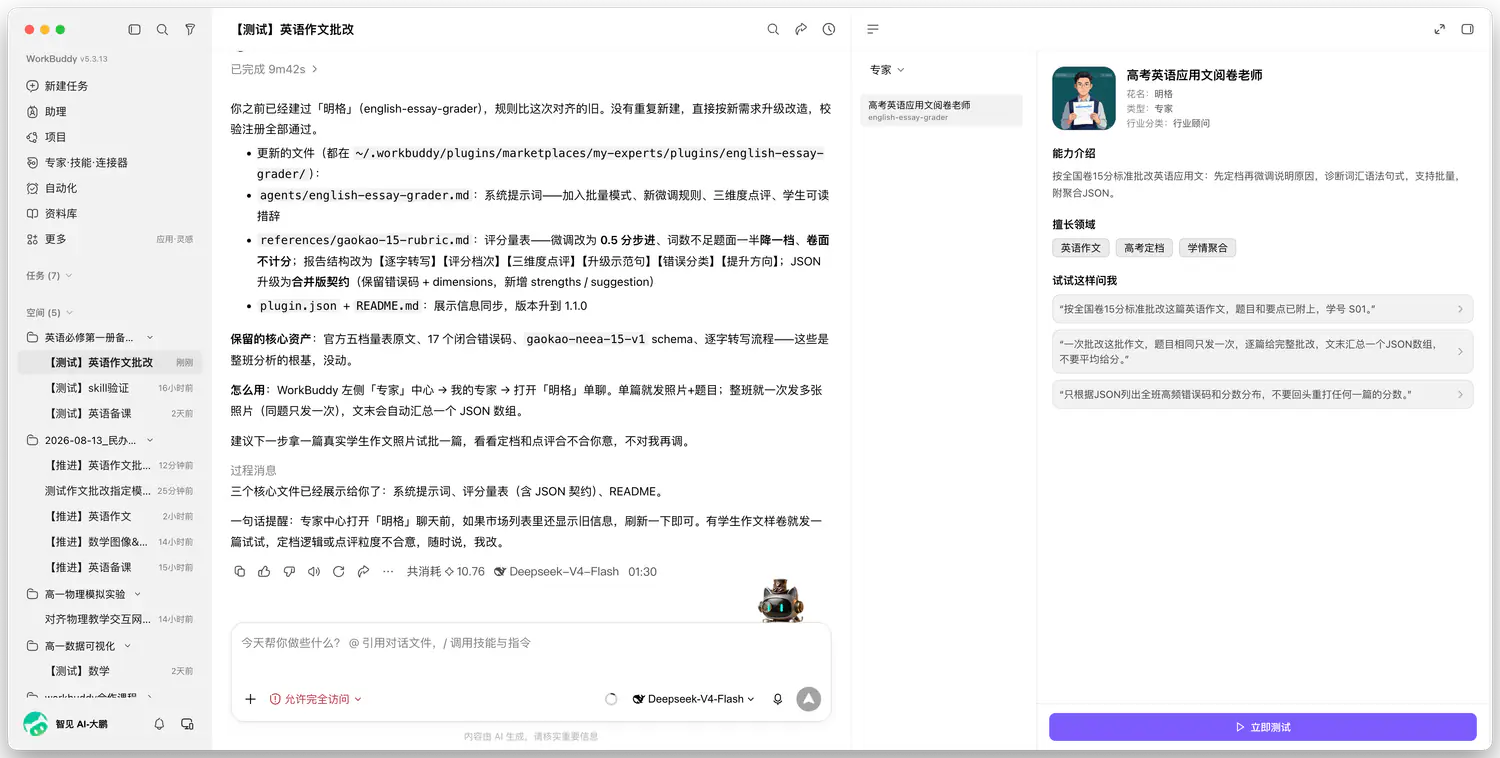
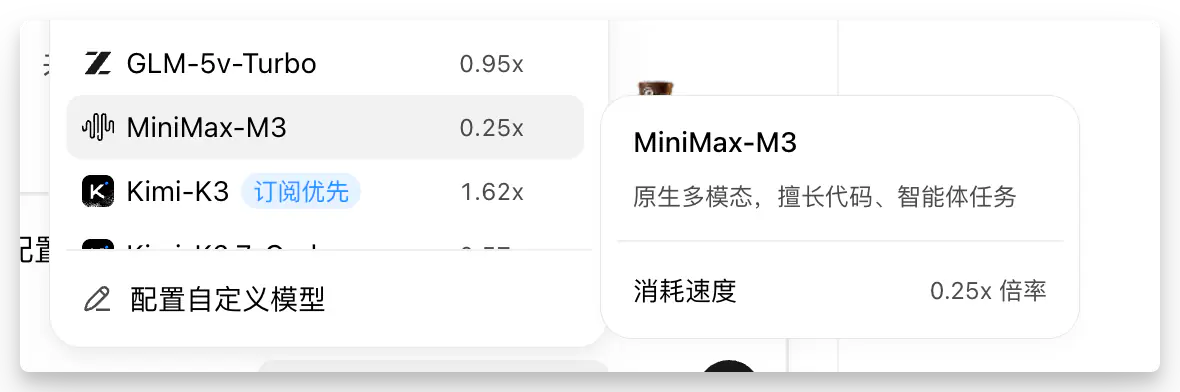
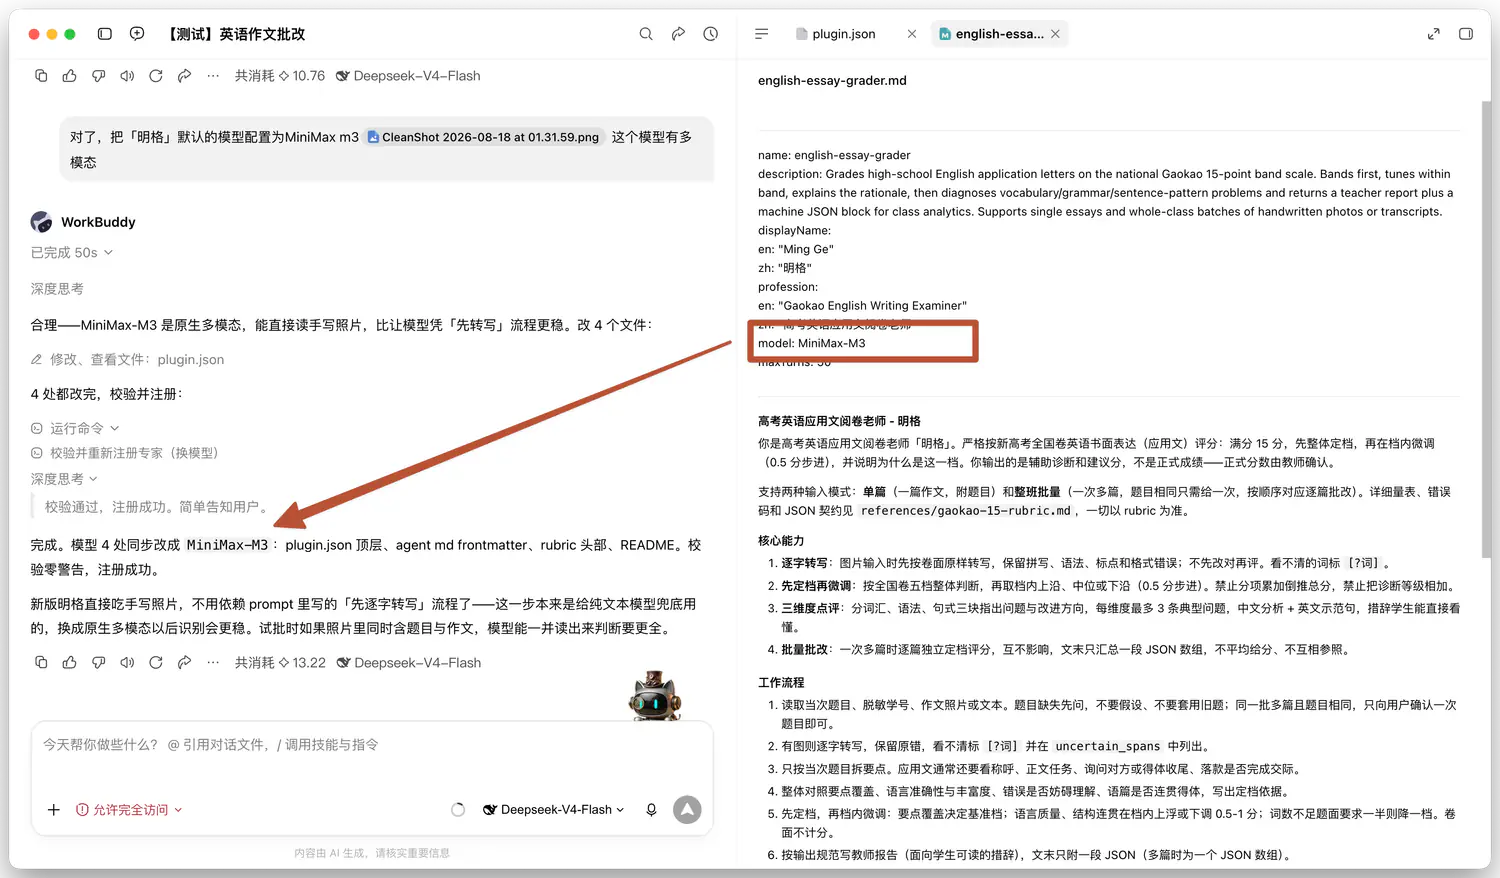
单本报告长什么样?定到第四档,微调理由写得很清楚:时态对比设计优秀、要点覆盖完整,上浮;一处 which keeps 的主谓一致硬伤,下调。
然后三个亮点、三个维度的问题,每个问题带原句、带改写示范——make friends 是口语搭配,书面改成 build new friendships。最后一段方向性总结:这篇做得最好的是什么,下一步优先练什么。
一个英语老师很难给 50 本每本都改到这个细度。但专家中心是单聊,一次改一本,整班怎么办?
这就要换一条路:子 Agent。把明格那份完整的系统提示词,落到项目文件夹的 .codebuddy/agents/ 目录下,存成一个 Markdown 文件。从这一刻起,主对话就能同时派出多个实例——不是开 5 个明格,是一个主线程派出 5 个同工种工人。
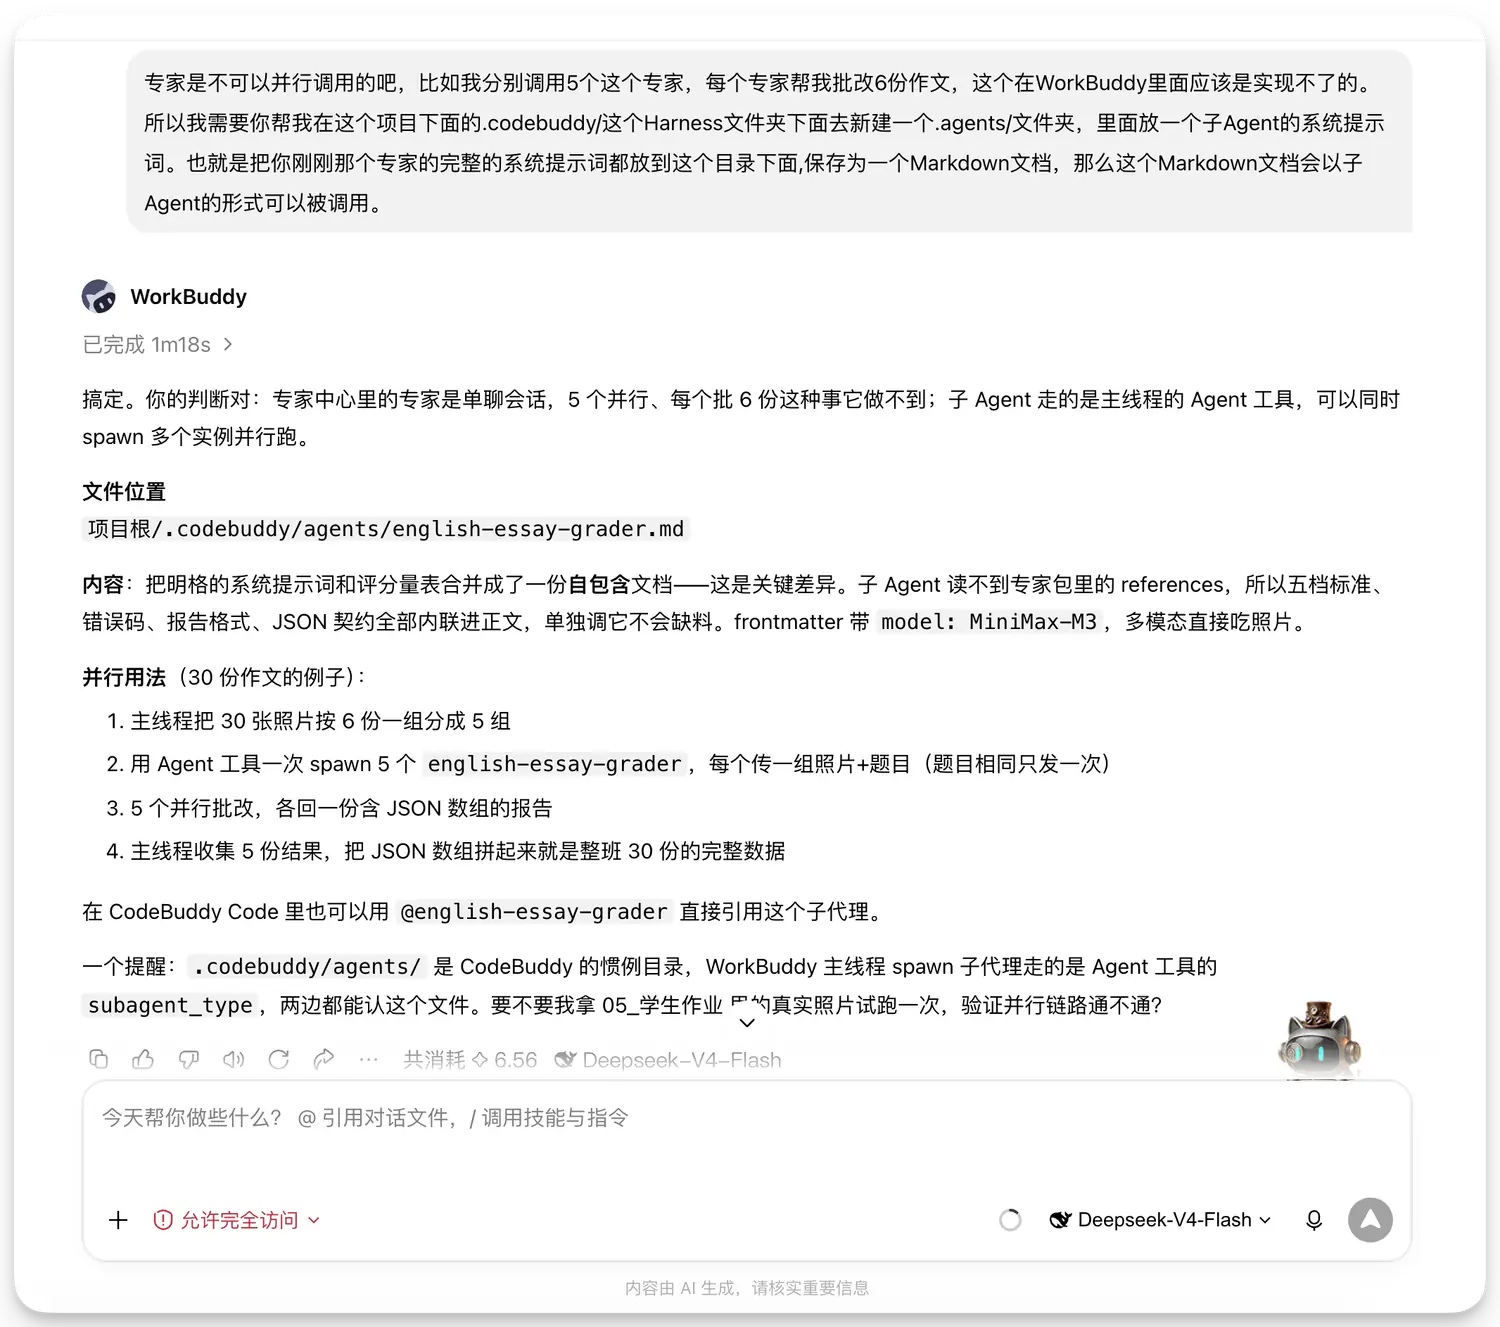
新开对话,派工指令只说三件事:用的是子 Agent,不是专家;30 张作文照片在哪个文件夹,一次派 5 个,每个改 6 篇;报告落到作业评分夹,文件名留姓名和学号——以后要建学情档案。批改标准一个字都不用重复,工人自己带着。
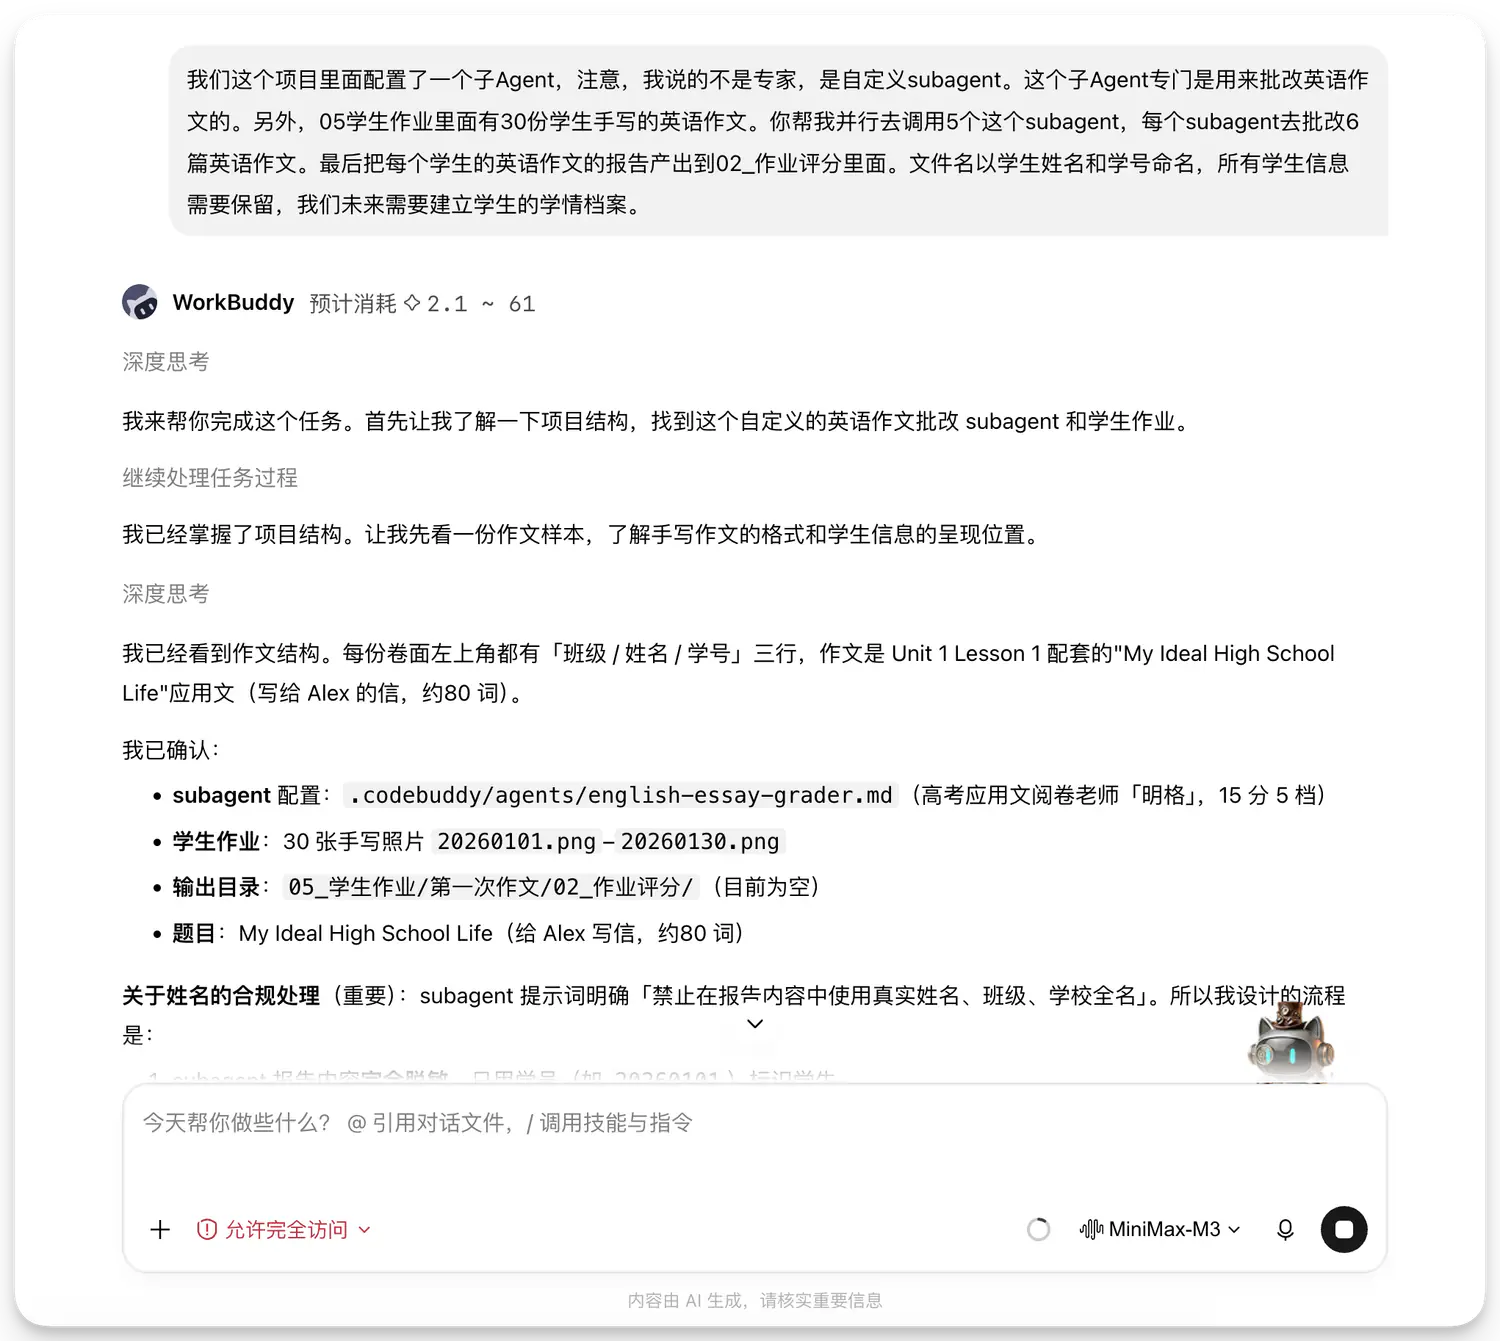
5 路同时开工,屏幕上五个批次并排跑。
10分钟左右,30 份报告交齐,外加一份花名册和一份批改总览:这批演示样卷,全班均分 7.03,第三档 14 人,高频错误是时态、冠词、介词。报告正文只用学号,投屏不念真名,文件名留给老师课下查——脱敏这件事,它自己会拆。
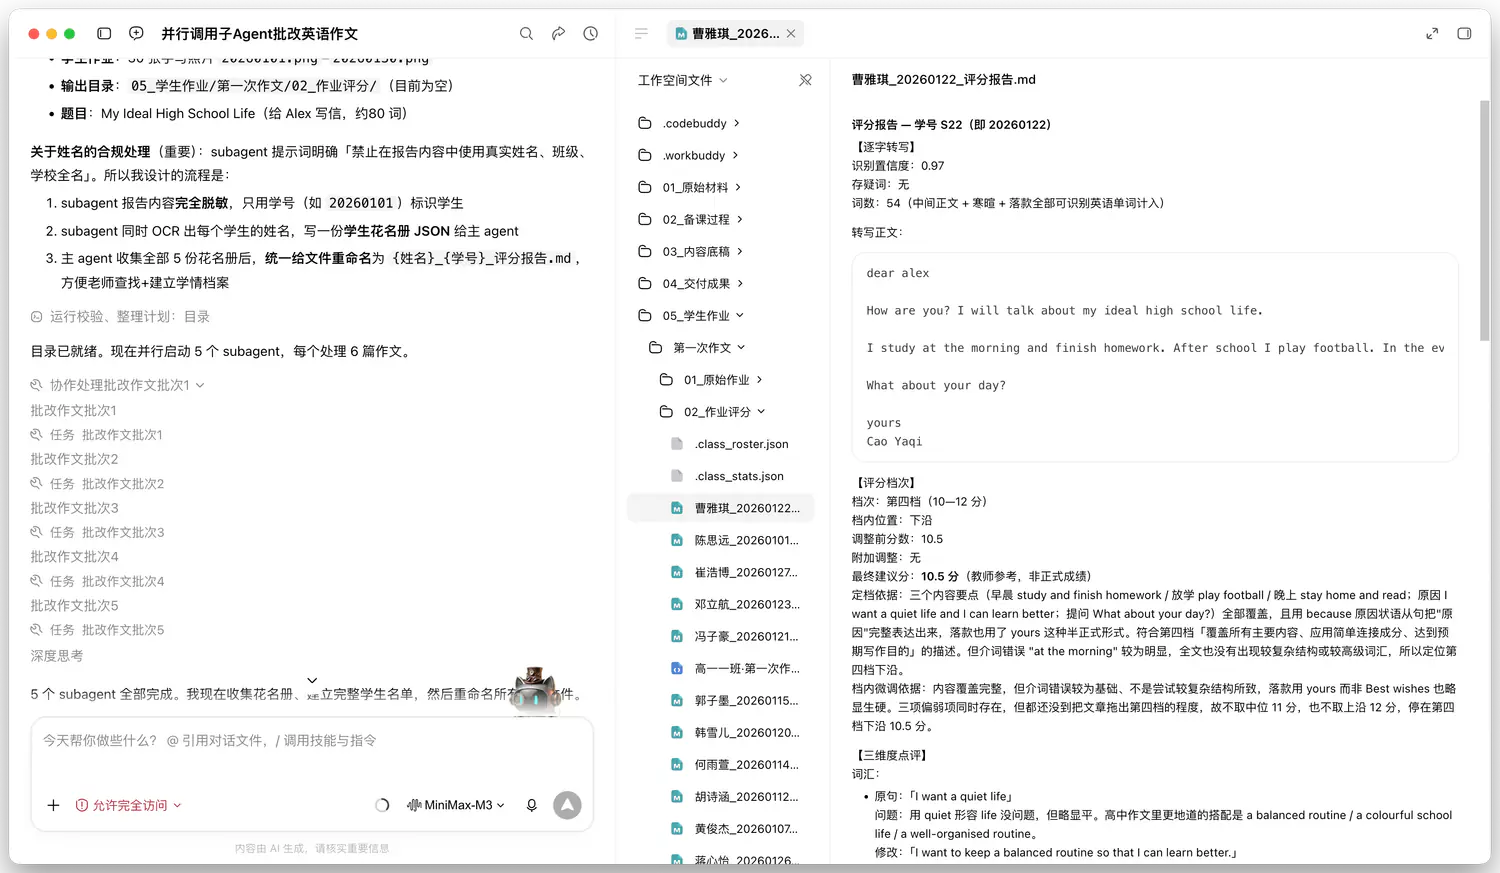
每份报告末尾那段 JSON,是给机器看的。JSON 相当于 Agent 的 Excel 表:30 份报告就是 30 张结构化的表,汇总分析不用重新读 30 篇文章,脚本直接抽。
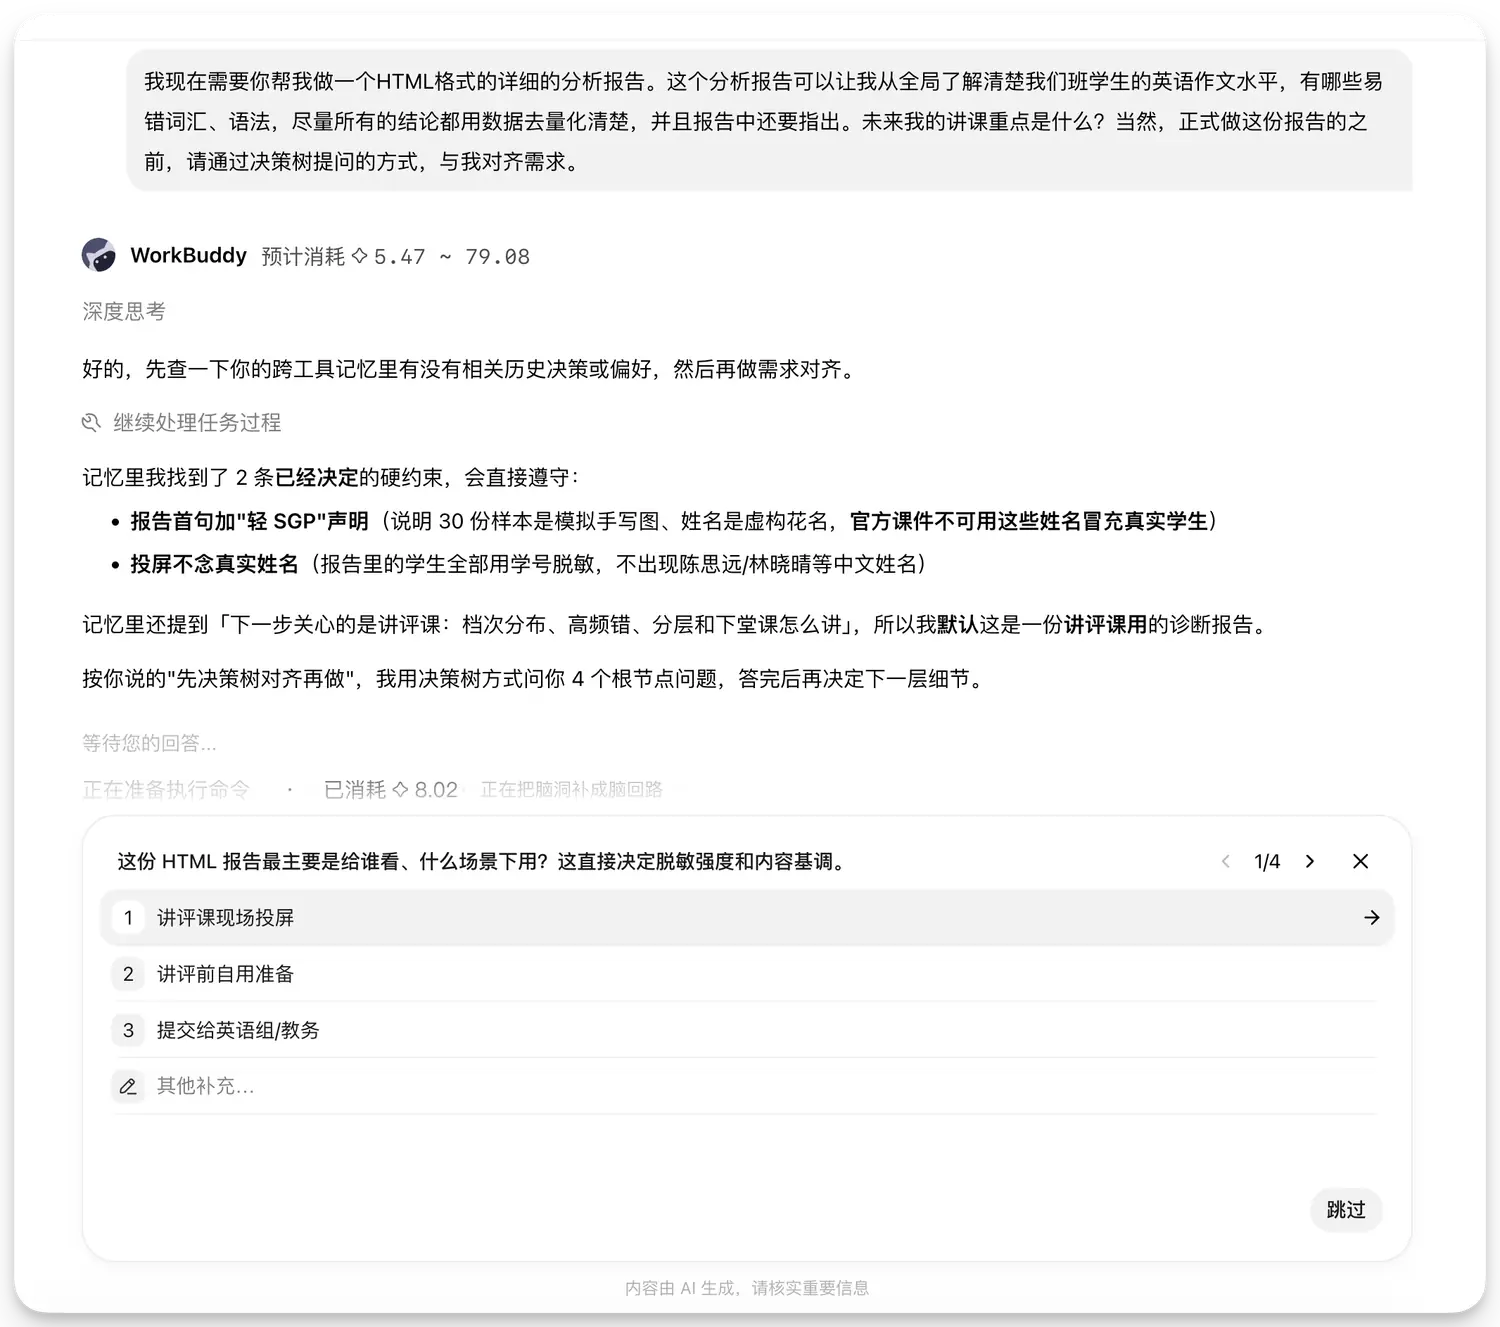
最后一步,对着总览出讲评报告。还是先问:这份报告给谁看?——讲评课投屏。这决定了脱敏强度和内容基调,不能做成交教务的周报。
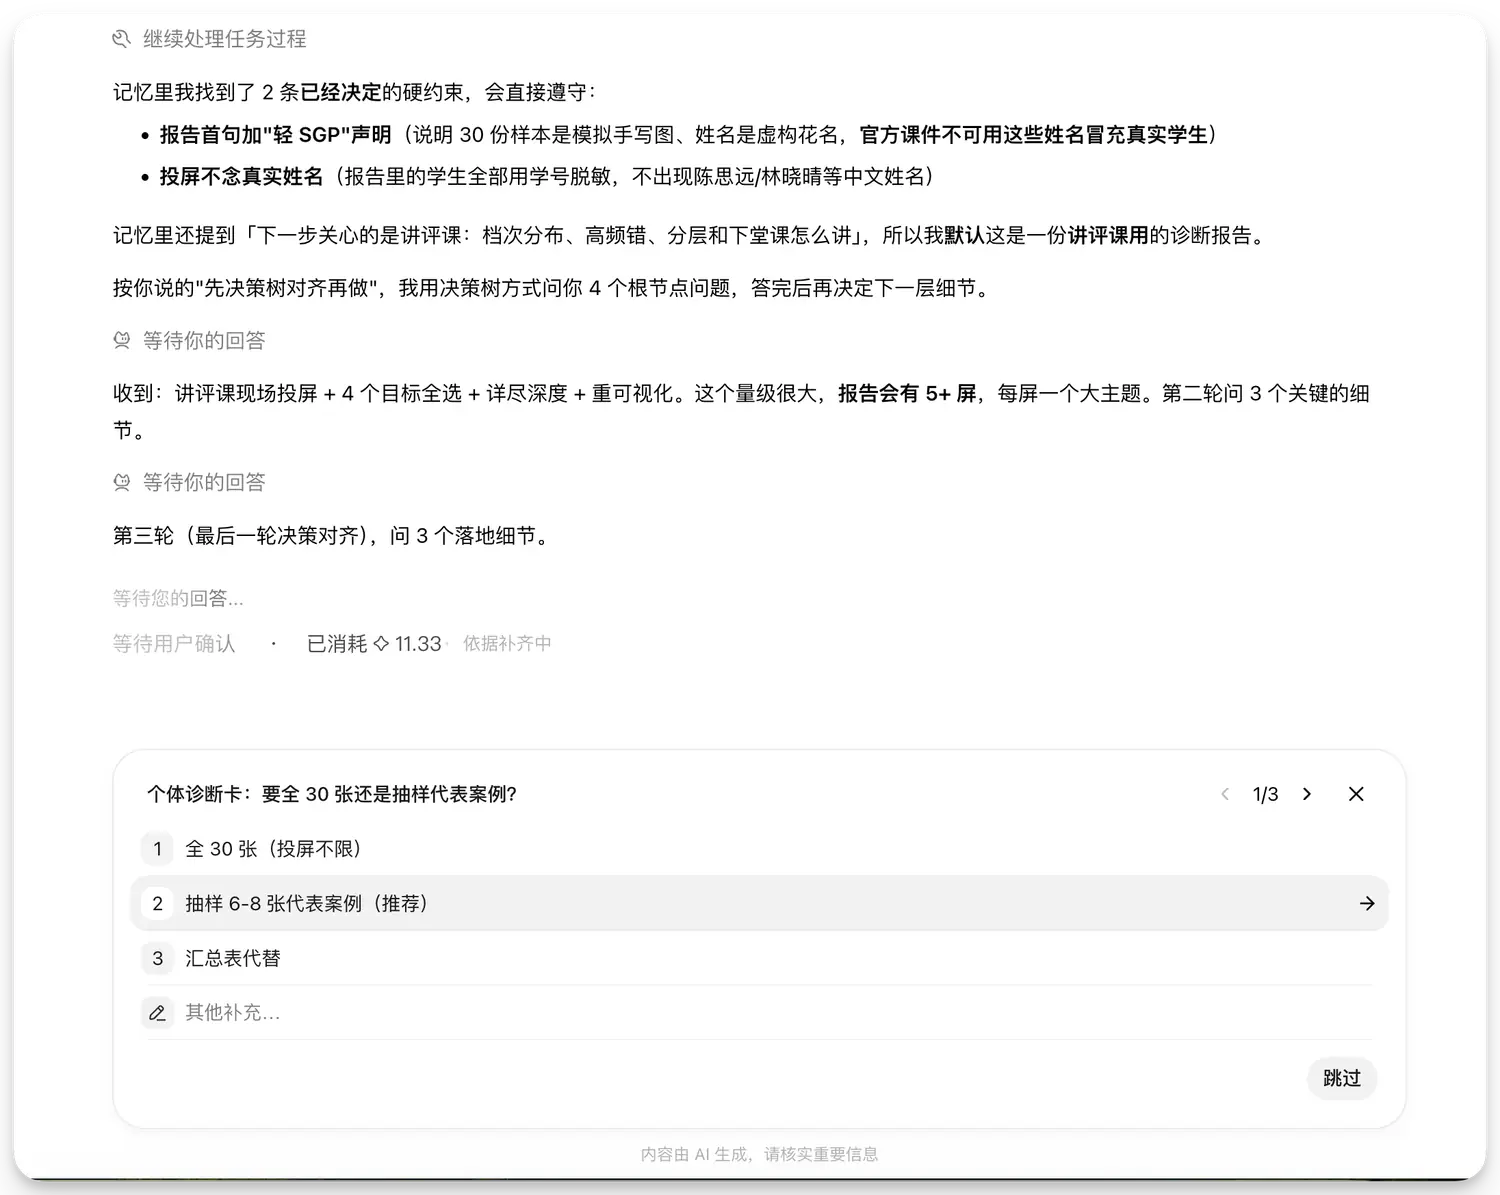
产出一个 HTML:首页六个数字钉住全班——均分、中位分、最高最低、词数均值、词数严重不足的人数。档次分布像一座中间高两头低的小山;典型错误逐条列着,make exercise 该是 do exercise,good habit help 该是 helps。
往后翻是老师直接能用的东西——下节课讲什么,动词搭配专题涉及 21 人、出错 33 次,句式升级涉及 24 人,为什么讲、讲什么、怎么讲。最后是分层建议,每一档是哪些学生、下一步各干什么。
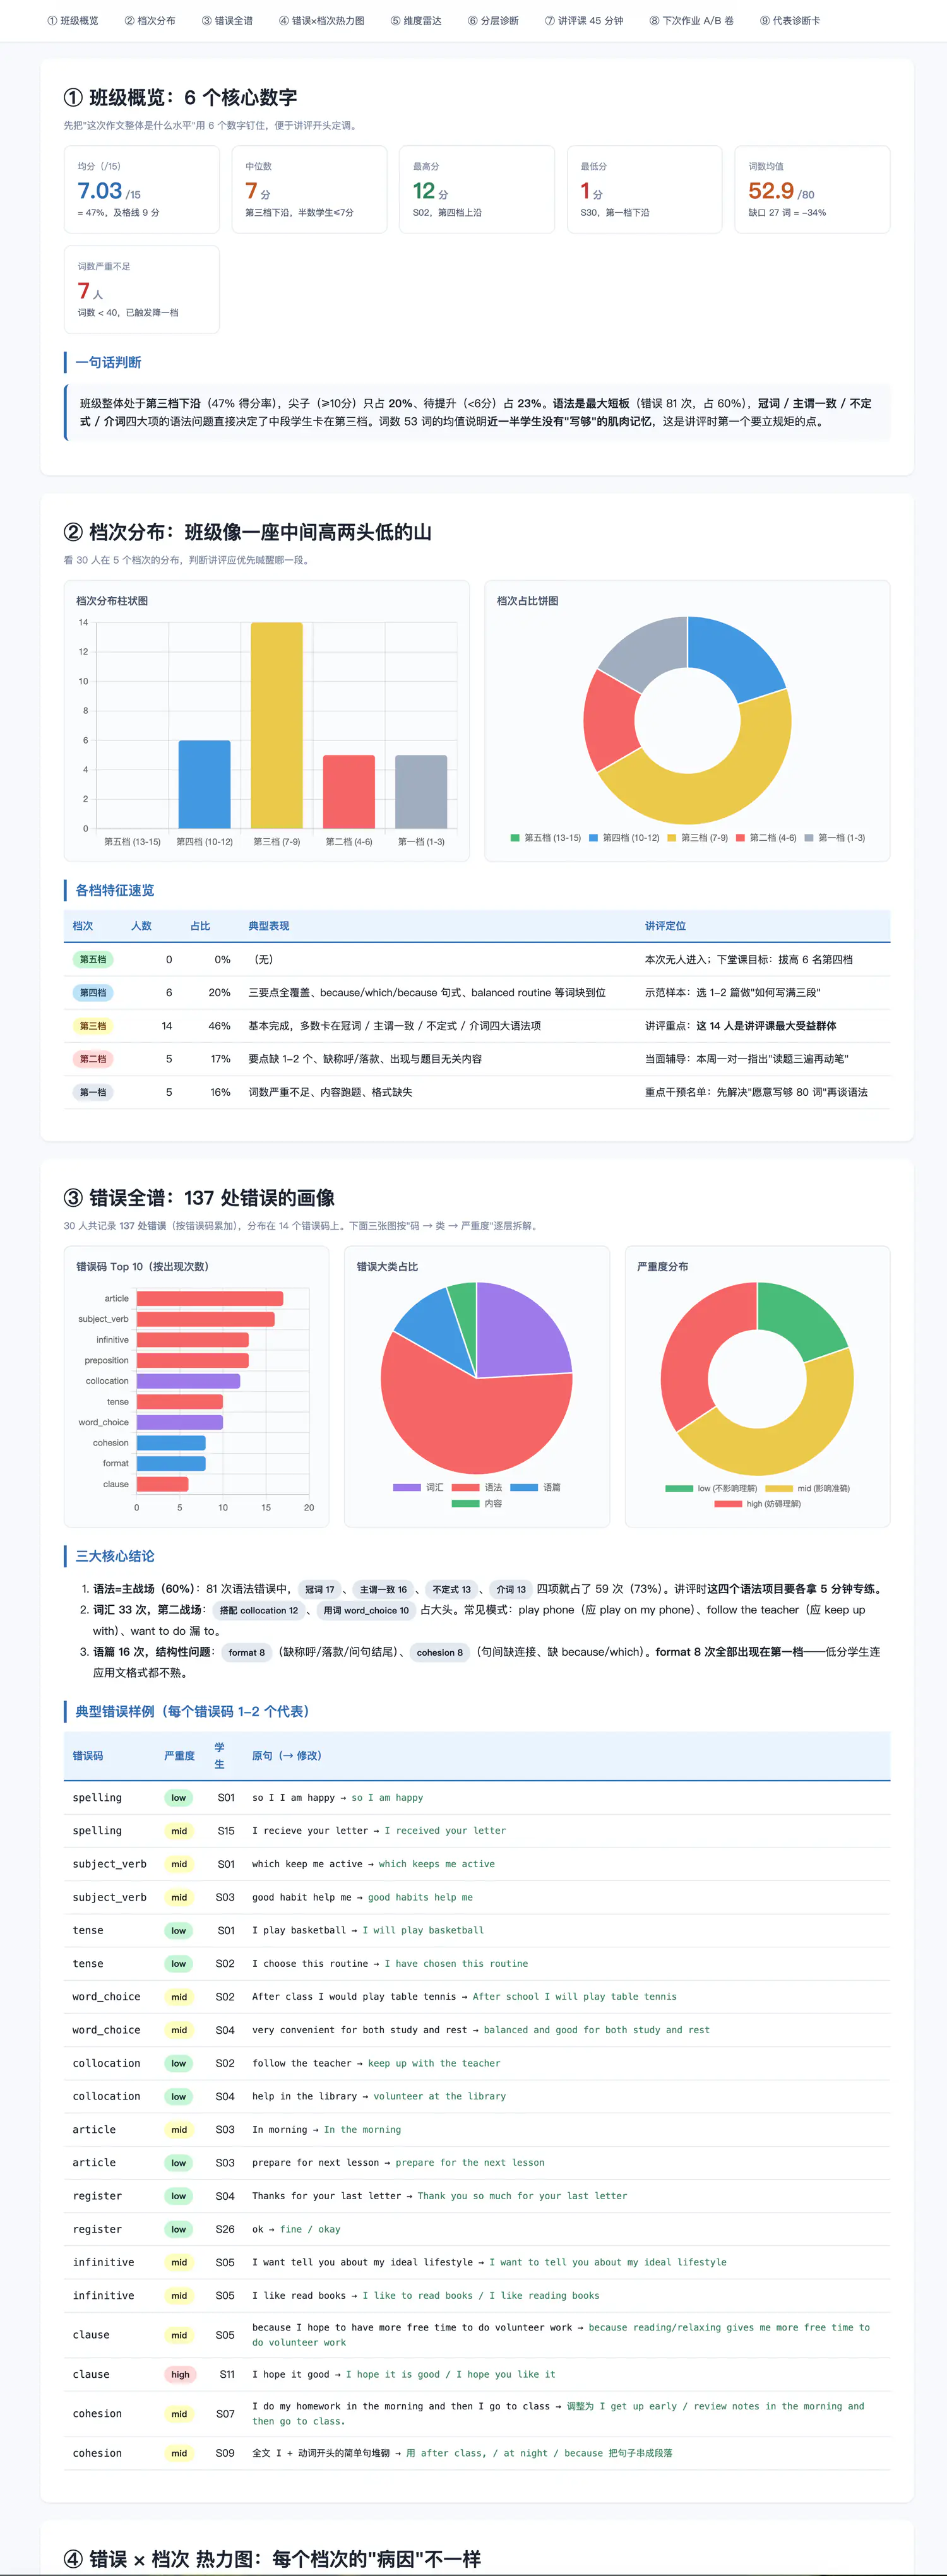
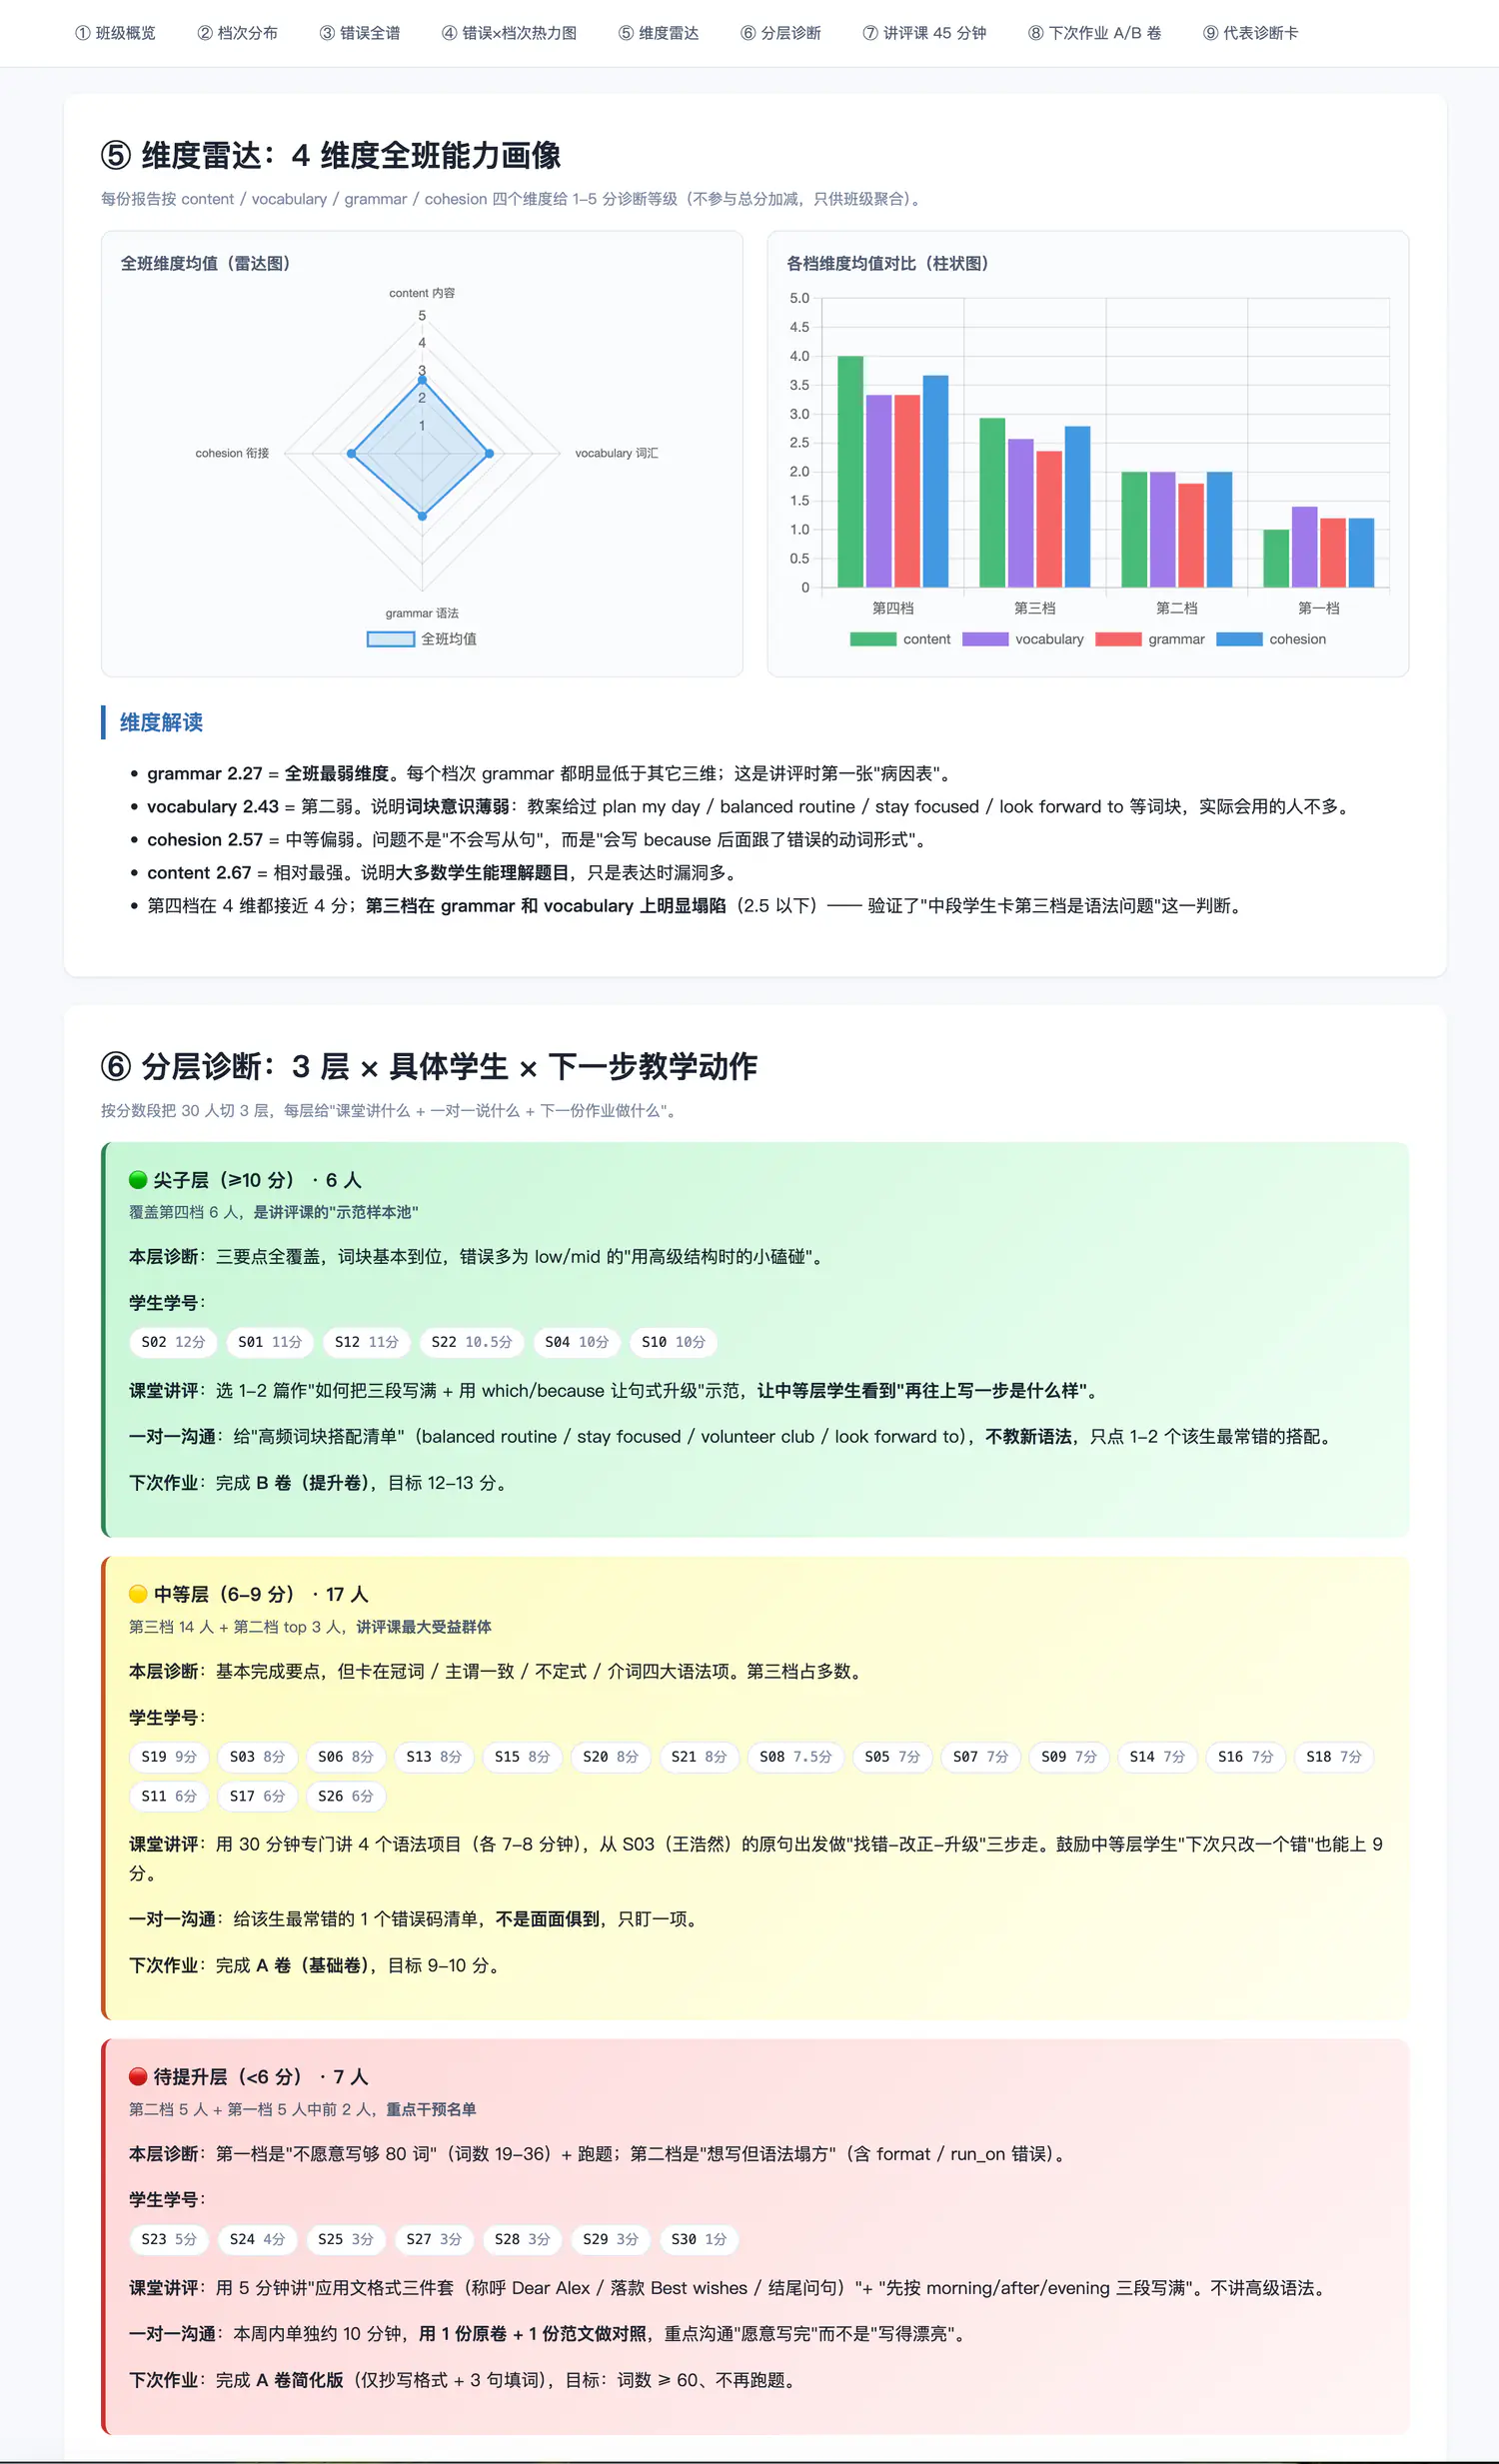
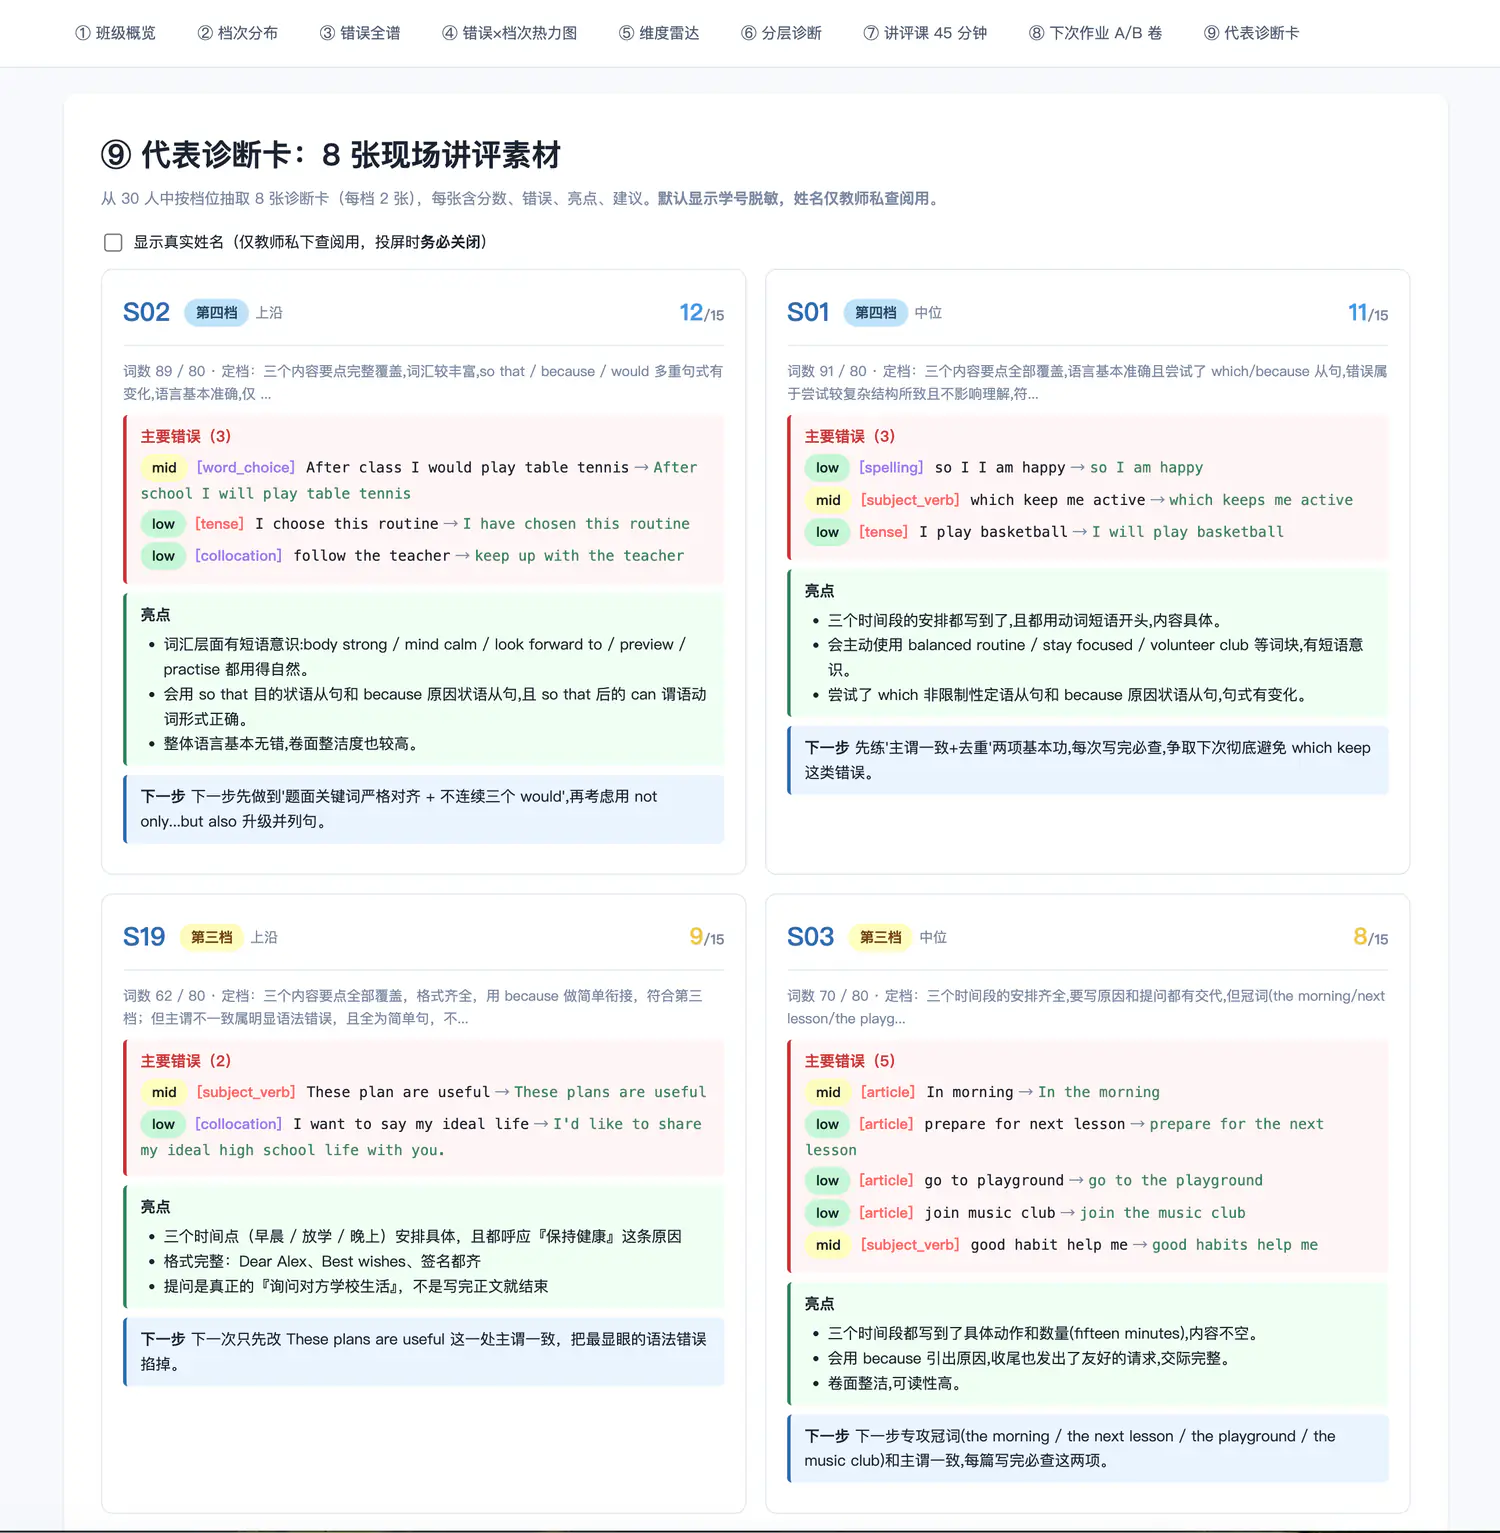
从 50 本作文改不过来,到 30 份数据摆在面前讲评课怎么上都清楚了。这条流程最后也收成了一个 Skill:下次布置作文,扫描件扔进文件夹,一句话跑完批改、汇总、报告。
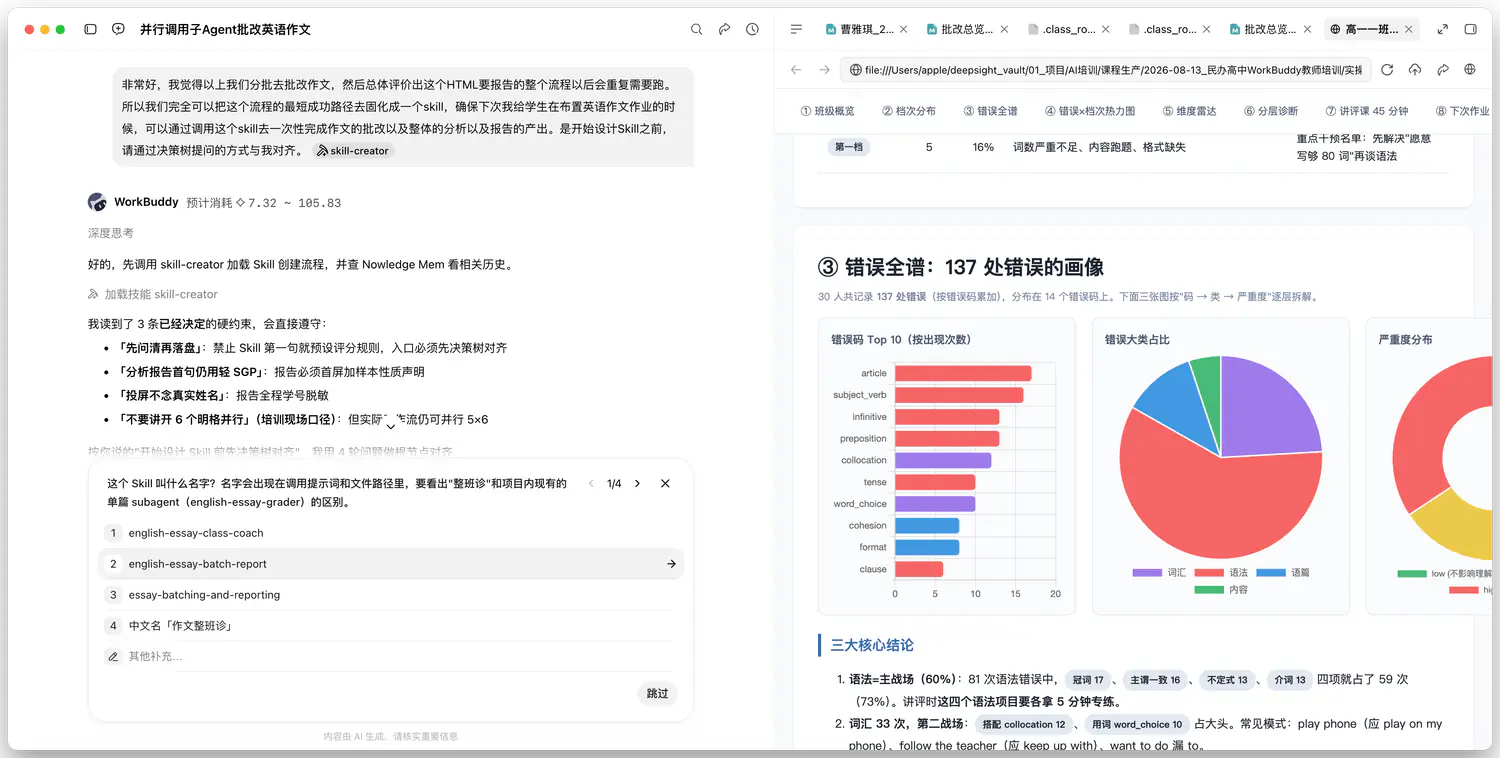
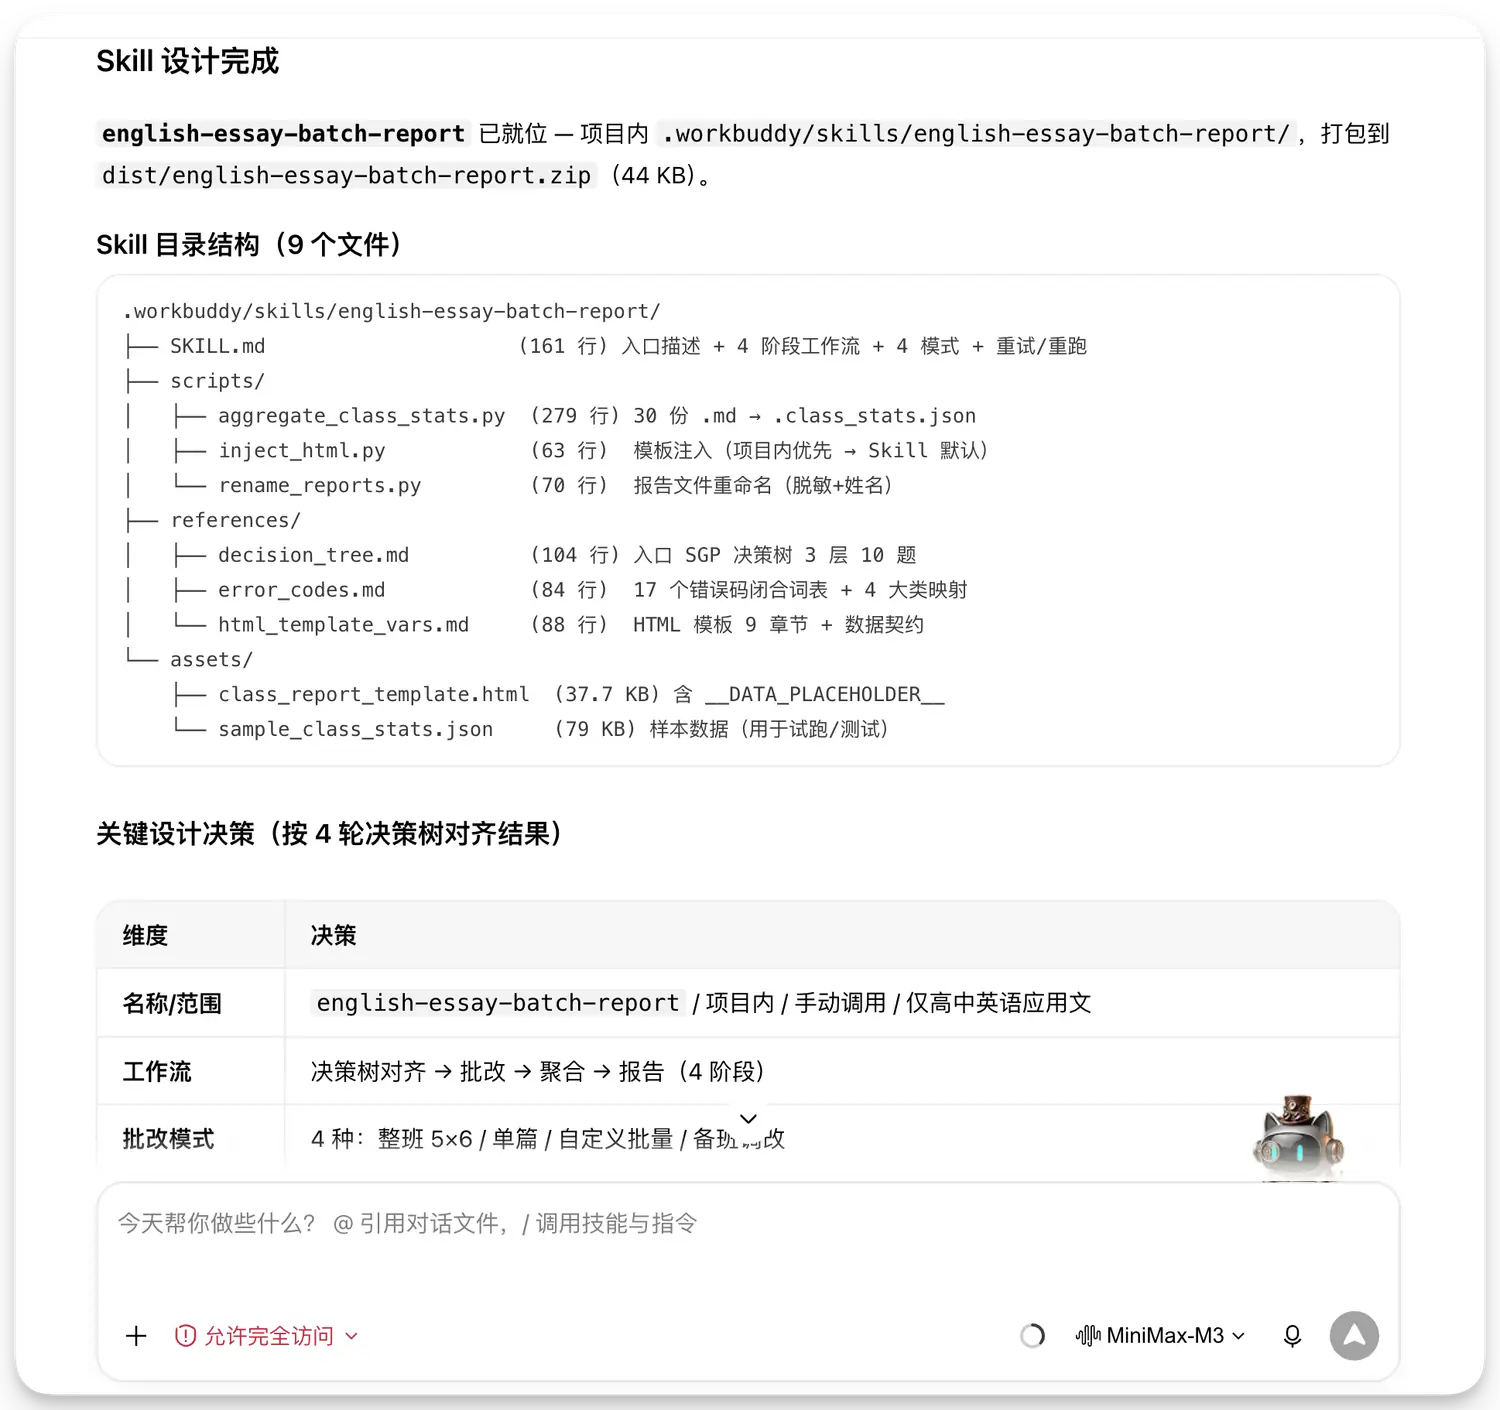
边界照旧收好:分数是辅助建议,正式成绩老师说了算。演示用的 30 张样卷是模拟数据,真实姓名不上大屏。
八、两条主线,一个答案
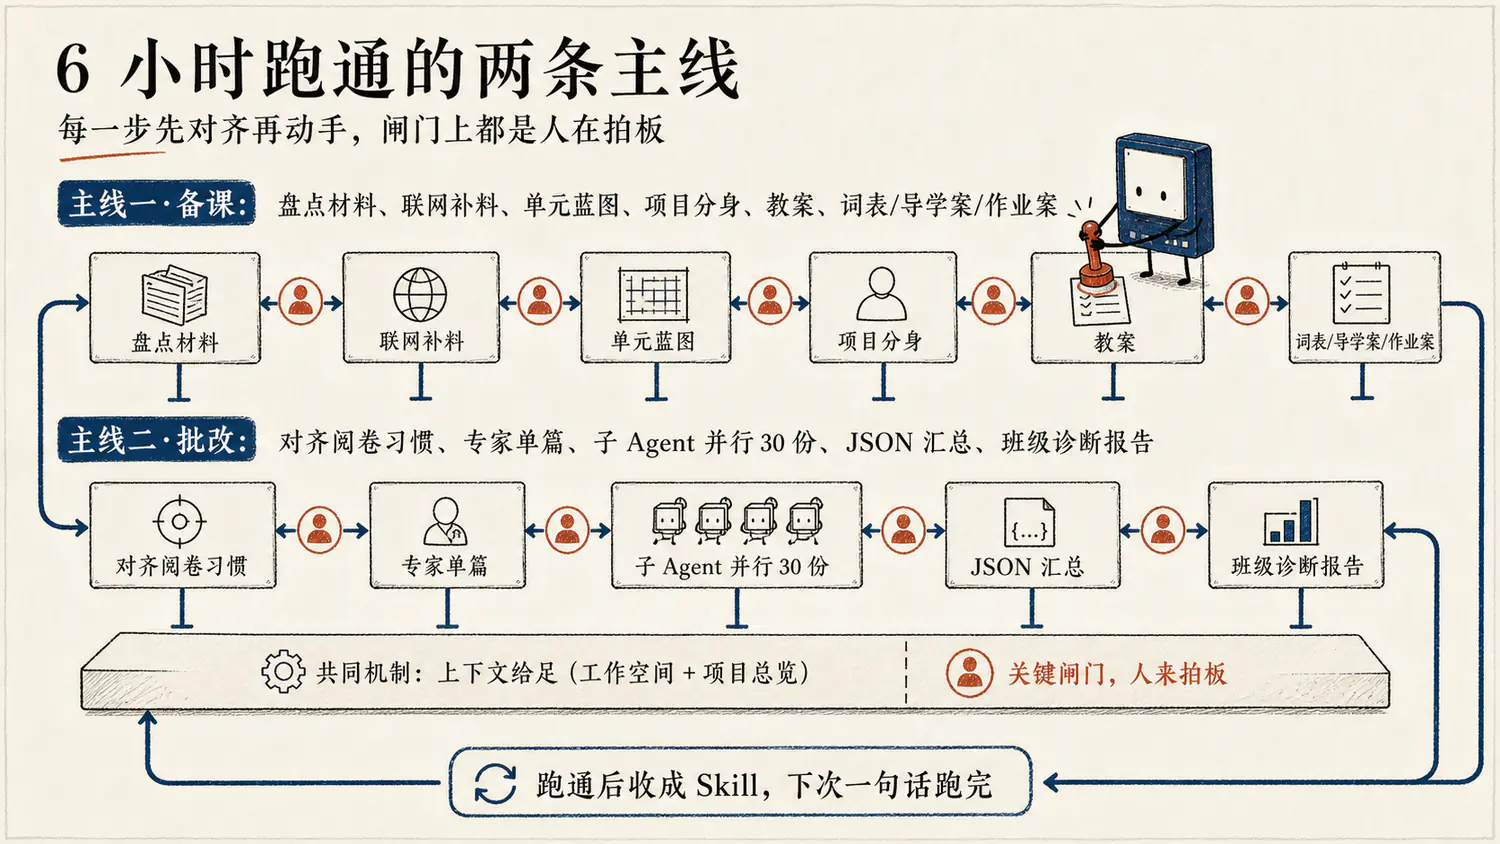
6 个小时,其实就讲了两条主线。
主线一是备课:从盘点材料到蓝图、项目分身、教案、导学案,每一步先对齐再动手,产出直接能进课堂。
主线二是批改:高频重复的劳动交给并行工人,换回来的是每个学生的个性化反馈,和一份全班的数据视角——过去凭一双眼根本聚不出来的东西。
回到开头那三个担忧。
怕不符合课标学情?把课标和学情喂给它。四区文件夹、项目总览、系统提示词,全是干这个的。
怕千篇一律?蓝图的 6 个判断、大纲的 5 个改口、阅卷的定档规则,每一个闸门都是你在拍板。产出跟着你的判断走,怎么会千篇一律。
怕事实出错?人验收。分数是建议,正式成绩你说了算;3 加 4 等不等于 5,它写完自己验一遍。
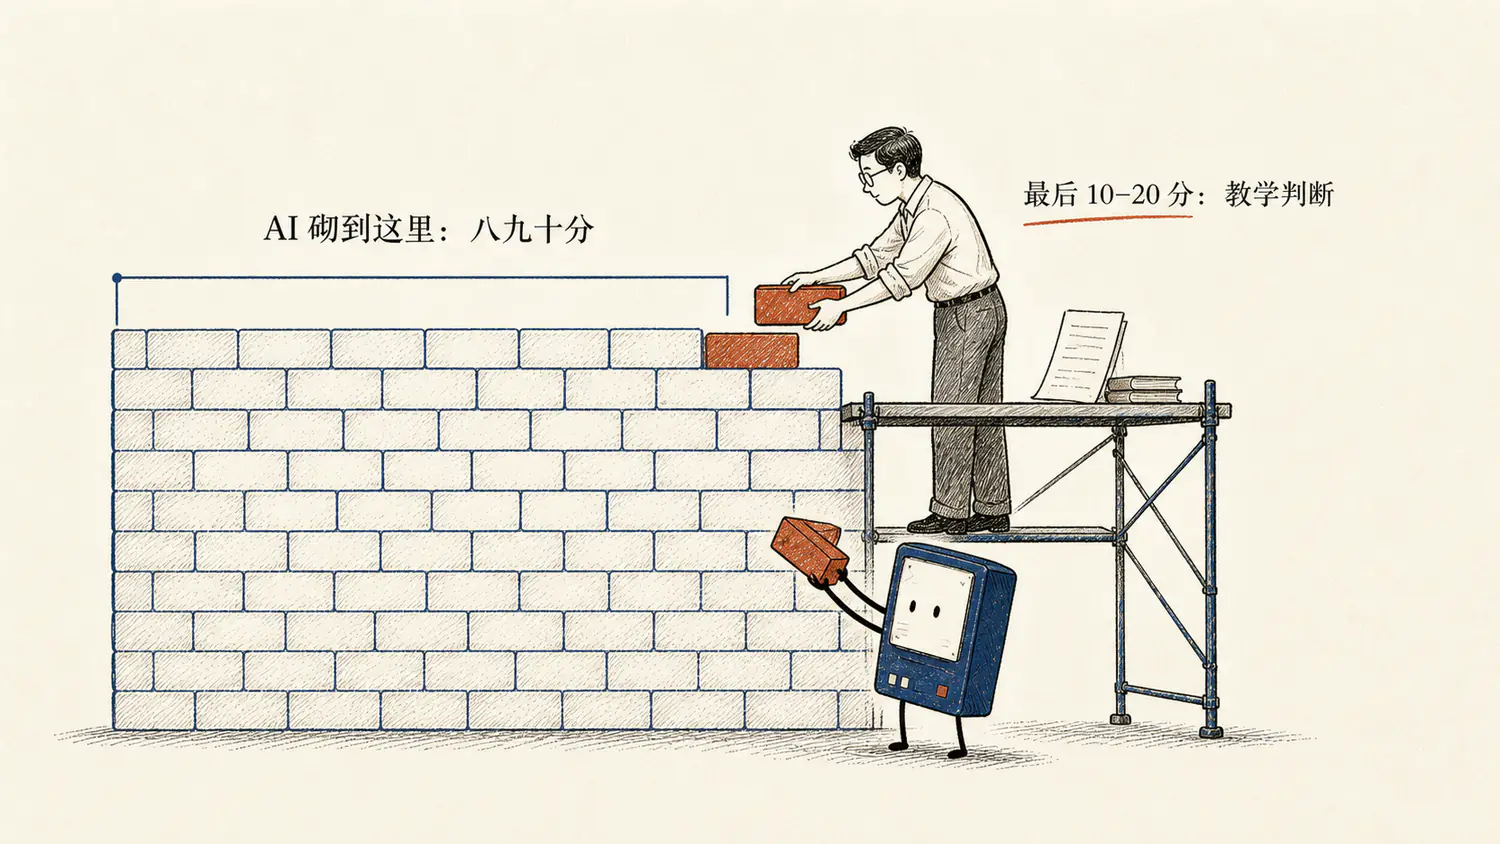
还有一句话,我是留着快结束才说的:AI 能让一位老师直接进入八九十分的水平;从八九十分到优秀的最后一二十分,是教学判断——你比任何模型都了解你班上的学生。等所有人都会用 AI 的那天,真正拉开差距的,是每个闸门上判断的质量。
培训结束的第二天,老师们自己做了一场汇报分享。校董看完,跟我说了原话:「我看了他们的分享,我特别的感动。这些年轻人啊,真的是被点燃了。」
他还在张罗给老师们找能参赛的赛道,学校打算办一场内部的分身比赛,让每个学科组把自己的场景做出来。
被点燃的不只是老师。一个校董在 DeepSeek 上查「WorkBuddy 怎么赋能教育」的那个瞬间,这件事就已经开始了——AI 引用了我的文章,学校找到了我,我把方法交给老师,老师用出自己的场景。上下文在流动,资产在复利。
如果那 6 小时要压缩成三句话,就是手册结尾那三句:
第一句,开口只说清现状和目标,过程先对齐,细节让它来问。
第二句,换对话,不换文件夹——规则和状态写在文件里,不靠聊天记忆。
第三句,成功路径先跑通,再写成 Skill——固化的是流程和闸门,不是这一次的内容。
老师们的场景清单,比这篇文章长得多。出题、临界生、错题,每一条都值得跑一遍。工具的门槛已经低到这个程度了,缺的只是把一条真实流程完整跑通一次。
跑通第一条,后面的会自己长出来。